在数千万行代码交织的 Linux 内核主线里,最难缠的险情往往长着一副人畜无害的面孔:补丁本身没有内存越界、没有空指针崩溃,甚至刚刚体面地修好了一个陈年小漏洞,可一旦合入新内核跑上云端万卡集群,吞吐量却在某个不起眼的锁竞争或缓存行错位上骤然掉下悬崖。
2026 年 11 月 21 日,科技媒体 Phoronix 连续披露两则直指内核性能防线的工程进展:Google 开发的开源智能体代码审查系统 Sashiko 0.9.5 正式上线“Linux 性能专家审查阶段”,在受控基准中把上游真实性能退化的检出率从 15.0% 拉升至 70.0%(Phoronix,2026 年 11 月 21 日);同日晚间,定于 2026 年 11 月 22 日释出的 Linux 7.4-rc4 块设备子系统合入了软件工程师 Qiliang Yuan 提交的 NVMe 命名空间并行移除补丁,一举打通了困扰多租户云存储逾 1 秒的串行卸载排队(Phoronix,2026 年 11 月 21 日)。一边是 AI 守门员在补丁合入前顺着调用链揪出二阶暗雷,另一边是内核工程师亲手铲平卸载路径里的隐蔽积压,两件事在同一天照面,恰好拼出了底层基础设施攻防的一体两面。
顺着调用链往外摸两跳,检出率从15%飙到70%靠哪三道铁律?
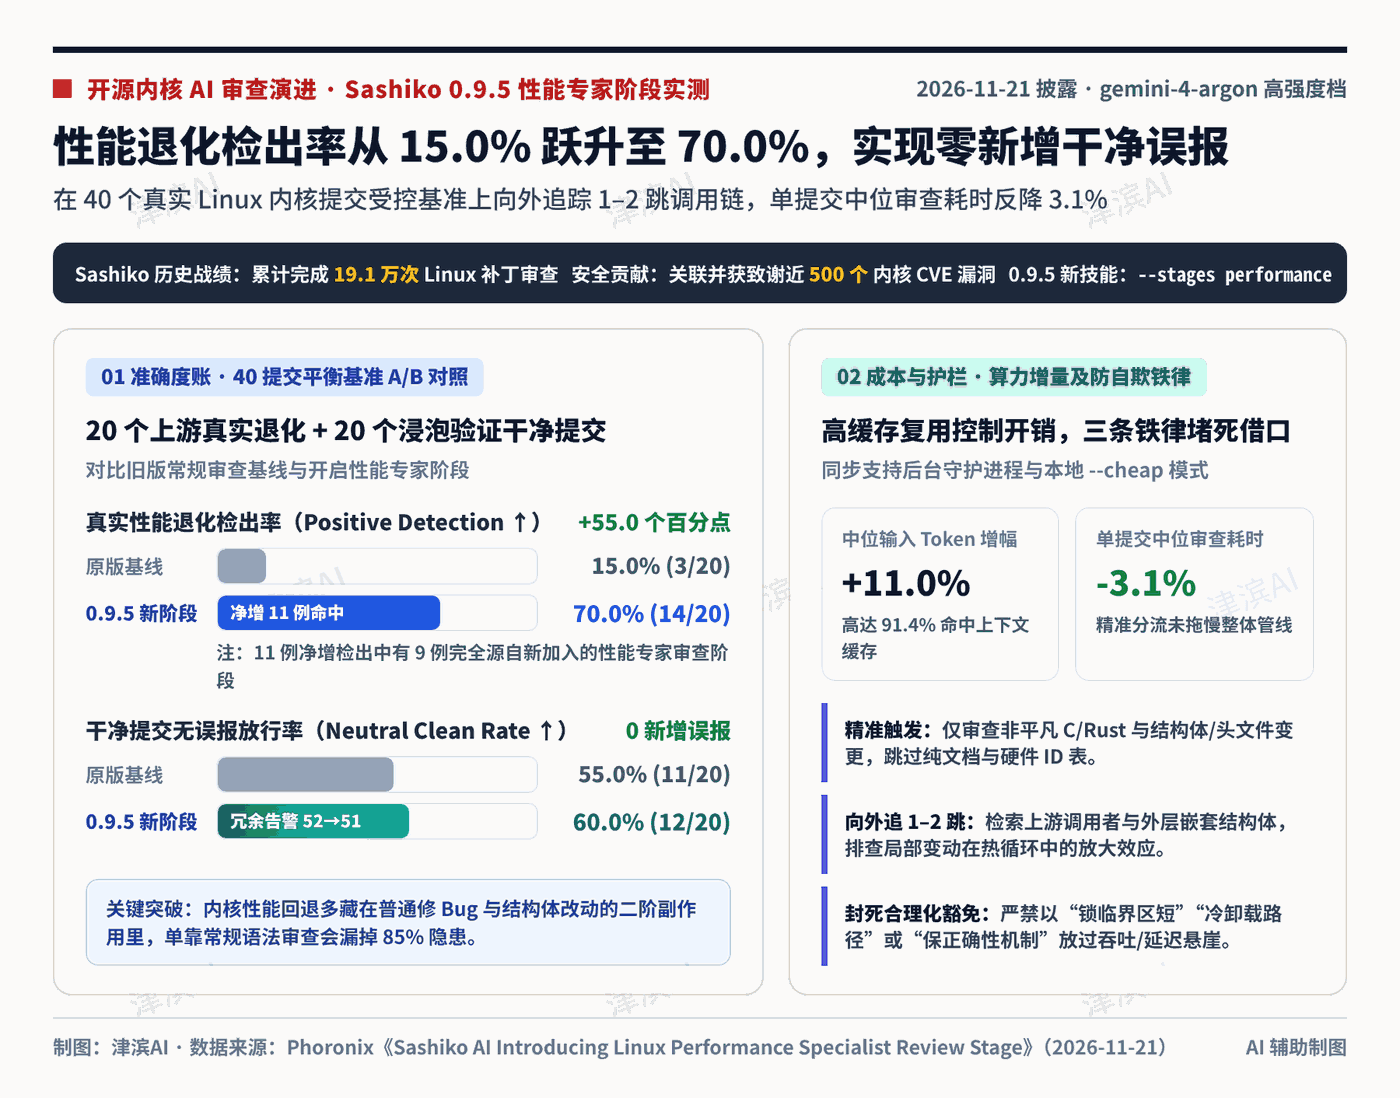
在 Linux 内核社区,Sashiko 早已算得上一位战功赫赫的老兵。在此番升级之前,这套由 Google 研发并开源的智能体审查工具已经累计完成了 19.1 万次补丁审查,在近 500 个内核安全漏洞(CVE)的挖掘与修复记录中被挂名引用(Phoronix,2026 年 11 月 21 日)。但抓代码崩溃和抓性能倒退完全是两套逻辑:内核里的性能退化极少明晃晃写在改动那几行里,十有八九是普通修 Bug、代码清理或者调整结构体字段顺序时惹出的“二阶副作用”。这就好比物业为了修好地下车库的一扇防火门,顺手把门框加厚了五厘米,消防检查过关了,早高峰进出的冷链大货车却全卡在弯道上动弹不得。
为了让智能体长出老练内核维护者的嗅觉,Sashiko 0.9.5 在核心流水线 linux_patch_review.rs 中嵌入了可选的性能专家分析阶段(同时支持后台守护进程与本地 --stages performance 及 --cheap 模式),立下三道严苛的工程铁律:
- 精准分流不陪跑:只在碰到非平凡的 C、Rust 源码或结构体与头文件布局变更时拉起性能专审,遇到纯文档、注释或硬件 ID 表直接跳过,省下好钢用在刀刃上。
- 向外穿透 1–2 跳查户口:强制智能体调用仓库检索工具,顺着修改点往外追踪 1 到 2 跳上游调用者(callers)以及包裹当前结构体的外层嵌套大结构体(outer embedding structs),看一处微小的字段膨胀或加锁有没有在高频外层循环里被放大成灾难。
- 堵死大模型的“和稀泥借口”:在配套的防误报与严重度指南里,研发团队明令禁止智能体拿“锁临界区很短”“这属于冷卸载清理路径(cold teardown)”或者“为了保证正确性理应承受吞吐悬崖”来给性能隐患自我开脱,同时剔除纯猜测性的微优化挑刺与无扇出的单次控制路径。
这三道铁律立竿见影。在覆盖 40 个内核提交(20 个真实上游退化与 20 个浸泡验证干净提交)的受控 A/B 基准 benchmark_performance.json 上,搭配高强度档位 gemini-4-argon 模型实测,Sashiko 对真实性能退化的检出率从基线的 15.0%(3/20) 跃升至 70.0%(14/20),净增 55.0 个百分点,其中 9 例新增命中完全归功于性能专家阶段。
难得的是高检出并未以乱报假警为代价:干净提交的无误报放行率从 55.0%(11/20) 升至 60.0%(12/20),实现零新增误报;算力账同样克制,中位输入 Token 仅增加 11.0%(91.4% 命中缓存),单提交中位审查耗时反而缩短了 3.1%。对照我们在《日均自查17起慢故障,OpenAI性能工厂怎么给亿级对话提速》中剖析的闭源线上排障体系,OpenAI 是在代码上线报警后派双智能体去生产环境追查慢故障,而 Sashiko 则把防线死死顶在了补丁进主线大门之前。
64个存储空间挤同一班电梯,Linux 7.4怎么砍掉逾1秒断连等待?
细读 Sashiko 0.9.5 的审查禁令,很多应用层开发者可能会好奇:为什么内核专家非要专门点名,严禁 AI 用“冷卸载路径(cold teardown)”给慢代码开绿灯?翻开 2026 年 11 月 21 日并入 Linux 7.4-rc4 块设备拉取请求的那笔 NVMe 优化补丁,现成的实战案例就摆在眼前(Phoronix,2026 年 11 月 21 日)。
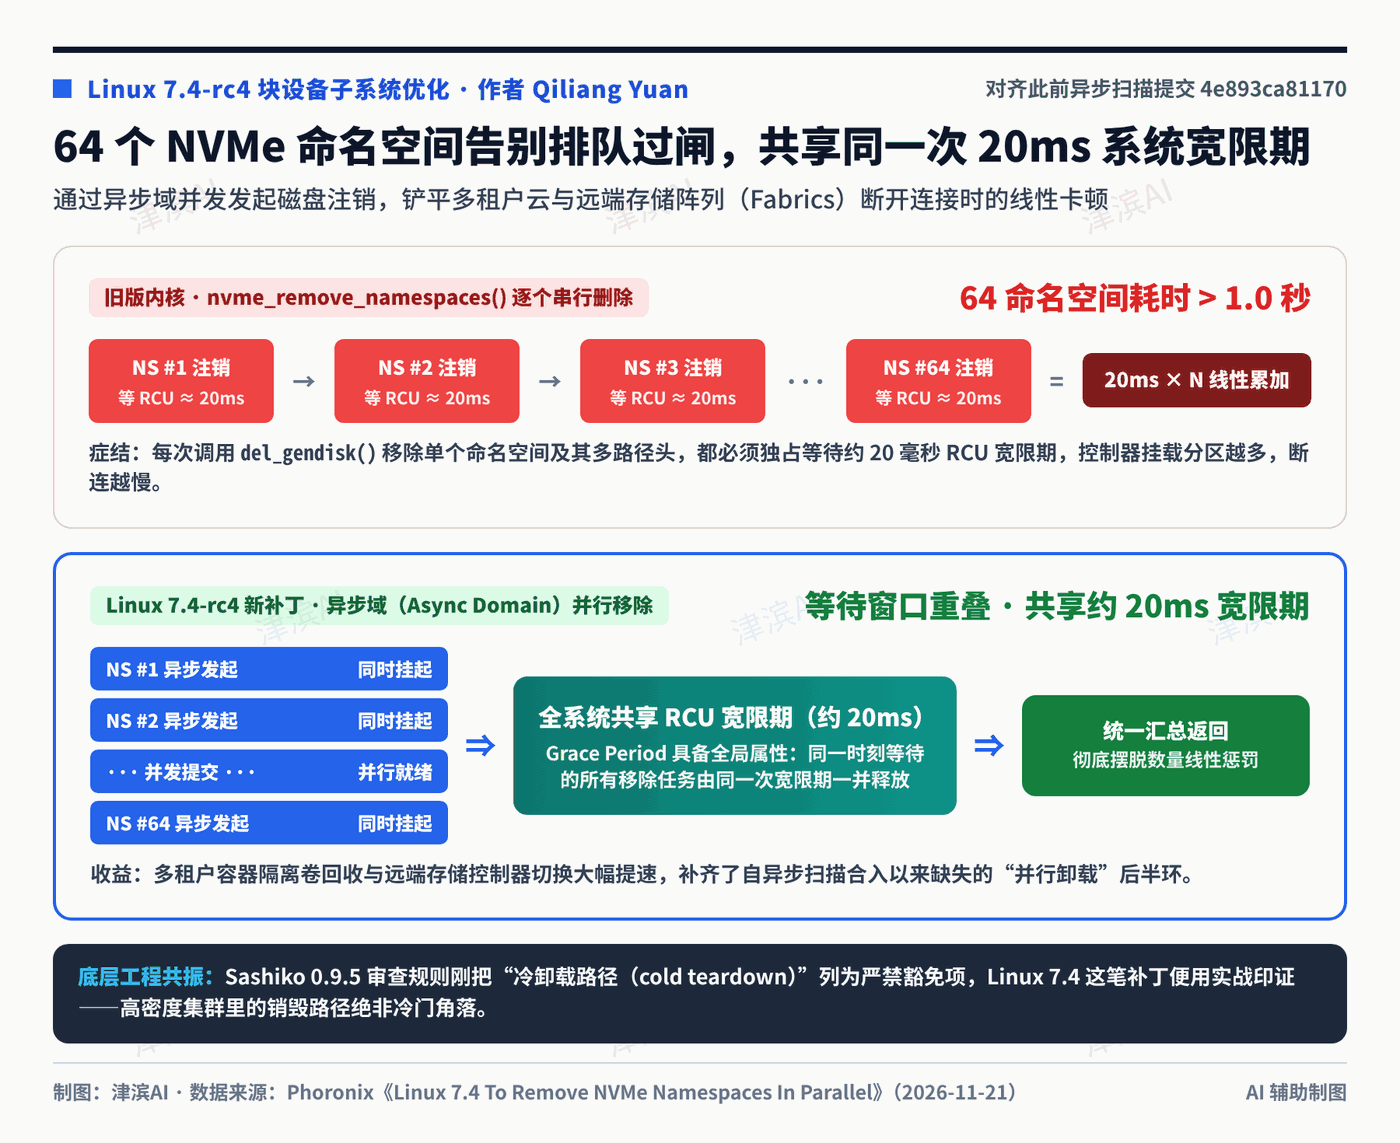
在现代多租户云平台与大规模 AI 训练集群中,运维团队普遍利用 NVMe 命名空间(Namespaces)技术,把一块高速固态硬盘或远端全闪存阵列切分成数十个逻辑隔离的独立存储卷,分别挂载给不同租户容器实现安全隔离。早在先前的内核提交 4e893ca81170 中,社区就已经把连接时的命名空间“扫描添加”改造成了异步并行,唯独把销毁断开时的 nvme_remove_namespaces() 留在了原地——一个接一个排队串行删。
串行删盘慢在哪儿?每次内核调用 del_gendisk() 移除一个命名空间及其多路径头,都必须停下来等待内核完成 RCU(读-拷贝-更新)宽限期,单次等待合计约 20 毫秒。删 1 个分区等 20 毫秒毫无痛感,可一旦云节点要从挂载了 64 个命名空间的远端存储目标(Fabrics target)断开连接,64 次等待首尾相接,光卸载一个控制器就得硬生生卡住超过 1 秒。
与其让 64 名乘客排长队一人包一趟电梯下楼,不如打开闸机让大家同时走进大厅,搭同一班约 20 毫秒的系统级班车集体出站。
软件工程师 Qiliang Yuan 提交的补丁顺着异步扫描的思路补齐了最后半环:通过异步域(async domain)并发发起所有命名空间的移除操作,等全部执行完毕再统一返回。尽管每个命名空间依然需要等待约 20 毫秒,但由于 RCU 宽限期在 Linux 内核里是全系统全局共享(system-wide)的,同一时刻挂起等待的 64 个移除任务会把等待窗口完全叠在一起,由同一次系统宽限期一并放行。从我们在《AI从零画出每瓦4.59倍新CPU,Linux扩容8TB显存池》中追踪的 Linux 7.5 多卡 8TB 显存池扩容,到 Linux 7.4 并行卸载 NVMe 命名空间,底层内核正把一切线性拖慢集群周转的串行旧债逐一清零。
当AI批量写补丁撞上AI守门员,基础设施团队该抄哪条作业?
Phoronix 主编 Michael Larabel 在报道 Linux 7.4 块设备周度修复时顺手点破了一个令所有底层维护者五味杂陈的现实:涌向内核邮件列表的日常修复补丁里,由 AI 与大语言模型驱动产出的代码流仍在持续膨胀,甚至连 Btrfs 文件系统社区都在探讨如何应对缺乏工程常识的低质 AI 补丁洪流(Phoronix,2026 年 11 月 21 日)。写补丁的门槛越低,审补丁的防线就越不能只靠人类专家用肉眼硬扛。
把 Sashiko 0.9.5 与 Linux 7.4 的这两笔改动合在一起看,企业基础架构与核心研发团队至少能直接搬走三条落地经验:
- 把“性能审查”从通用代码评审里单拎出来:别指望一句笼统的“请帮我检查这段代码”能揪出性能回退。学 Sashiko 单独设立性能专家阶段,并给智能体配上向外检索 1–2 跳调用者与外层数据结构的工具链,看不到外层热循环就永远抓不住局部改动的放大效应。
- 在审查提示词里把常见推脱借口写进黑名单:大模型在代码评审时极易顺着作者的注释替隐患找台阶下。明确禁止以“锁粒度小”“属于停机卸载分支”自我豁免,并用“20 个历史真故障 + 20 个干净提交”这种平衡回测集卡死零新增误报红线,研发团队才敢真把 AI 审稿接入合并门禁。
- 彻查高密度集群里的“串行回收旧账”:在容器秒级启停、算力节点高频切分的生产环境里,销毁磁盘卷、解绑虚拟网卡、回收页表早已变成高频日常动作。凡是在循环里逐个触发全局同步等待的旧代码,都值得照着异步域批处理的思路重写一遍。
知识延伸:什么是 Linux 内核里的“RCU 宽限期”,为什么并行等待能省下几十倍时间?
在几十上百核的现代服务器里,如果每次有程序查询磁盘分区表或网络路由都要先加一把互斥锁,所有 CPU 核心光排队等锁就要烧掉大半算力。Linux 内核大规模采用的 RCU(Read-Copy-Update,读-拷贝-更新) 机制换了一套极为精妙的无锁读规矩:读取数据的线程根本不用加锁,直接全速读;当内核需要修改或删除某项数据结构时,先把指针切换到新副本让新来的读者走新路,但此时绝不能立刻把旧内存释放掉,因为可能还有几个 CPU 核心正拿着旧指针读到一半。
内核必须等这一刻所有正在读旧数据的在途操作全部安全退出后,才敢真正回收旧资源——这段“等全场旧读者安全离场”的确认窗口,就叫 RCU 宽限期(Grace Period),在常规服务器配置下通常耗时十几到二十毫秒。最巧妙的地方在于,一次宽限期确认的是“全机器所有 CPU 核心都已经跨过了旧状态”,具备天然的全系统广播属性。如果串行删 64 个分区,就相当于把全场清场哨连吹 64 次;改成异步并行发起后,64 个注销请求同时登记等哨声,内核只需吹响同一次约 20 毫秒的清场哨,就能把整批卸载任务安全放行。
说明:本文由 津滨AI 借助 AI 辅助检索与起草,所有核心数字与事实均经公开一手信源核对;文中概念题图与插画系 AI 辅助生成示意,非现场实拍。
参考资料
- Michael Larabel — Phoronix (2026-11-21):Sashiko AI Introducing Linux Performance Specialist Review Stage
- Michael Larabel — Phoronix (2026-11-21):Linux 7.4 To Remove NVMe Namespaces In Parallel For Faster Results
