2026 年 11 月第三周,国内大模型团队负责人的办公桌上接连摆上两份坏消息。据路透社(2026 年 11 月 19 日)披露,受美国商务部 11 月 16 日生效的新规影响,台积电暂停了部分受影响中国芯片公司 16 纳米及以下先进工艺的代工订单;没有美方许可的设计方案,原则上只能退回去做不带高速大显存的 28 纳米或 40 纳米老工艺。就在前一天,腾讯总裁刘炽平也在财报电话会上直言,海外机房远程租用高端芯片受限虽然没耽误日常对话这类云服务,但国内企业能调动的高端算力更少了,短期内会拖慢下一代新模型的训练进度(路透社,2026 年 11 月 18 日)。
把话说透,侥幸的退路已经被一层层封死:海外最顶配的显卡买不进来,专门给中国市场减配的特供卡也在 2025 年 4 月后受限(36氪,2026 年 10 月 14 日),现在连出海租机房的口子都在越收越紧。回想三年前,不少团队刚领到第一批国产加速卡时,心里都在打鼓:这卡拿来跑个简单问答还行,真能把一个上千亿规模的大模型从头教出来吗?走到 2026 年底,没人再指望外部松手,国产训练显卡这条路,真的是在封锁线里一寸寸硬蹚出来的。
造芯片难、教模型更难,探路者怎么把路垫平?
很多人会问:既然国产显卡早就能跑日常 AI 聊天了,为什么拿来“训练”新模型会难这么多?咱们打个通俗比方:让显卡做日常聊天问答,就像让员工各自独立答题,哪台机器卡了换一台顶上就行;可从头训练一个大模型,就像让上千号人齐步抬一根百米长的大梁——上千张显卡必须连续几个月分秒不差地同步算账、对账、改错。底层哪怕某一步小数点取整偏了一丝丝,跑上几千轮就会把整盘账算崩重来。机房里只要有一根网线闪断半秒钟,剩下九百多张卡都得停在原地干等烧电。
刚起步时,国内探路者迎面撞上的是两堵高墙。第一堵是硬件卡脖子:缺最顶尖的光刻机和高速大显存,国内能造先进 7 纳米芯片的产线排得满满当当(路透社,2026 年 11 月 20 日)。第二堵是软件没人铺路:英伟达统治市场二十年,攒下了一套名叫 CUDA 的“超级现成百宝箱”,里面配齐了几千把趁手扳手,全球程序员写好的代码放上去就能转。早期换上国产卡,好比刚修通了一条新铁路,却还没配齐信号灯和时刻表,程序跑两步就报错熄火。
这种硬仗没有任何巧劲可取,国内芯片和软件工程师靠两股笨功夫硬生生撕开了口子。
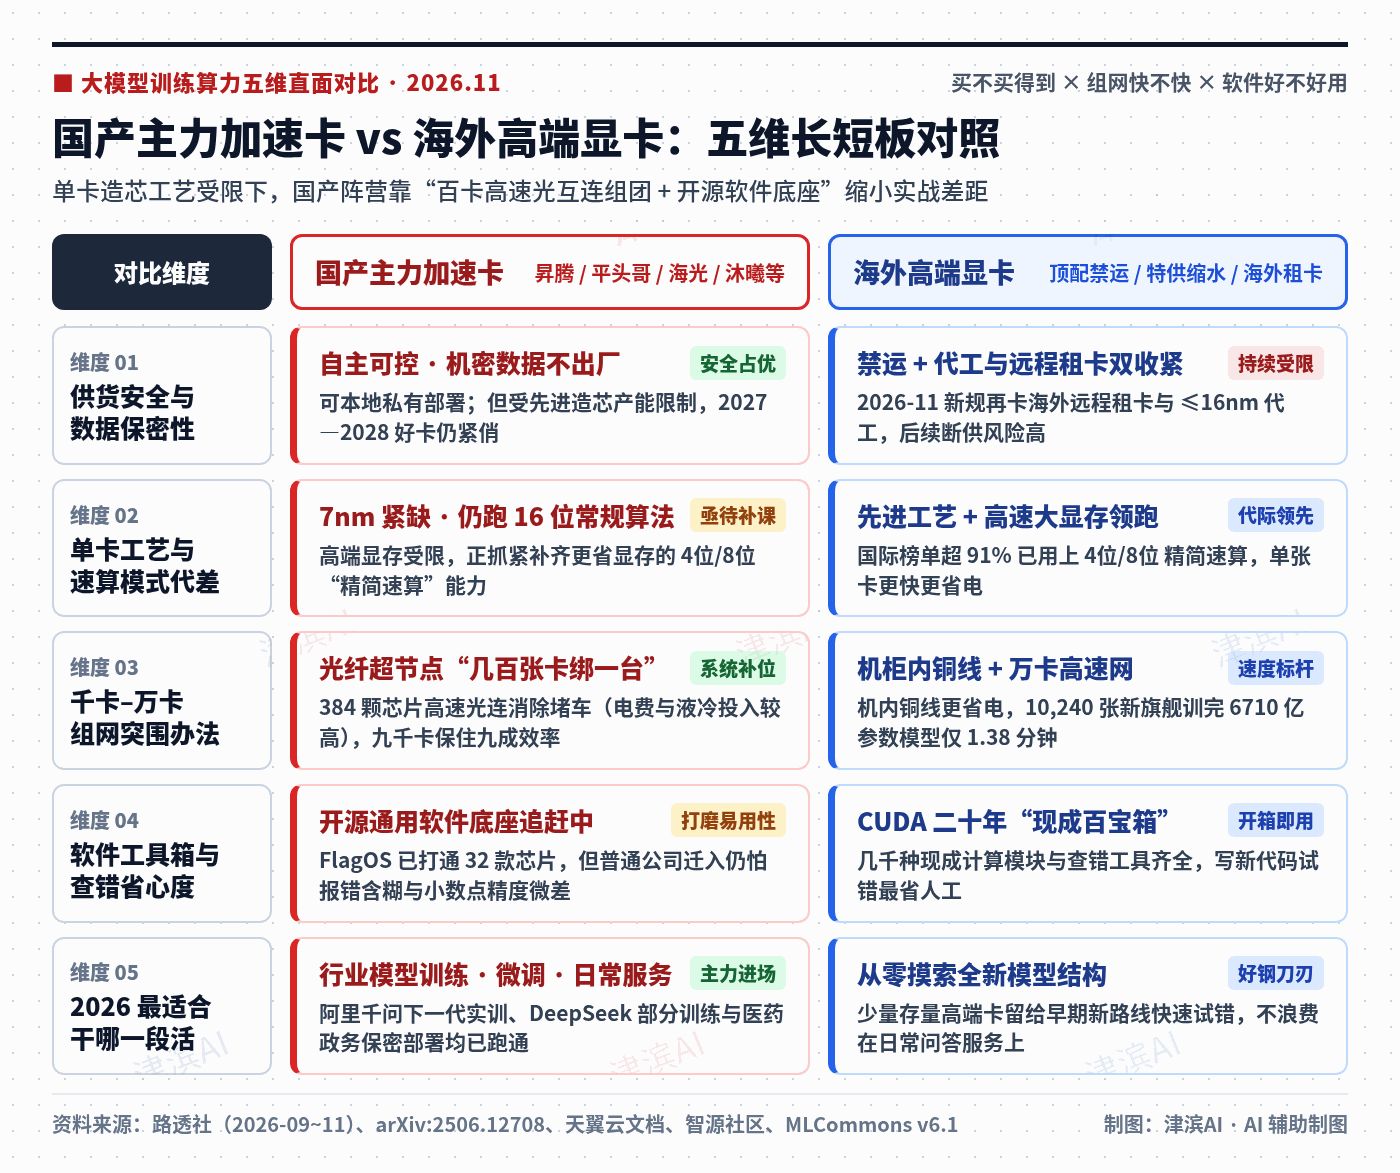
第一招叫“单张卡跑不赢,就修更宽的内部高速路抱团跑”。华为轮值董事长徐直军在 2026 年 9 月 17 日算过一笔实在账:在动辄几万张卡的大机房里,显卡之间互相传数据“堵车排队”,往往白白浪费掉四成以上的时间(路透社,2026 年 9 月 17 日)。华为在公开论文里亮出的办法是,直接用超高带宽光纤把 384 颗国产昇腾芯片和 192 颗处理器绑成一台没有收费站的“巨型电脑”(业内叫超节点,arXiv,2025 年 6 月 19 日)。虽说那篇论文当时测的是大模型问答,但它证明了只要把机柜之间的通信围墙拆掉,同样能治好大模型训练最头疼的数据大堵车。
当然,这套办法也得付出现实代价:海外顶配机柜在柜子内部靠便宜省电的铜线就能连起来,国产超节点为了跨好几个机柜组团,不得不插上成百上千只高速光模块,不仅整柜电费和全液冷散热改造成本涨了一大截,光模块多了日常排查闪断也更费人力。说白了,这是单卡工艺受限之下,用机房基建投入换取训练速度的务实兜底。
第二招是钻进软件最底下,一处一处“抠小数点”改错。北京智源研究院在 2026 年 3 月 27 日讲过一个很典型的细节:团队在海光国产千卡机房里训练一个 320 亿规模的多模态模型时,发现模型越学越走样,工程师一层层往下扒,最后查到芯片最底层的“小数点怎么取整”——把原本图省事的“直接砍掉尾数”,改成更精确的“四舍五入”,模型才终于学上了正轨(智源社区,2026 年 3 月 27 日)。到 2026 年 9 月 30 日,DeepSeek 也联合华为把适配国产卡的底层工具包免费开源出来,共推 128 颗芯片组成的新超节点,还用上了更简单的开源芯片语言,帮后来的团队少熬无数个通宵(路透社,2026 年 9 月 30 日)。
把买不买得到、单卡工艺、千卡组网和软件好不好用摆在同一张桌面上比一比(见下图),国产主力卡与海外高端卡各自的长短板就非常清楚了。
追到 28% 份额、训出下一代千问,这份答卷怎么看才实在?
三年苦熬下来,国产阵营今年交出了一份实打实的阶段成绩单。
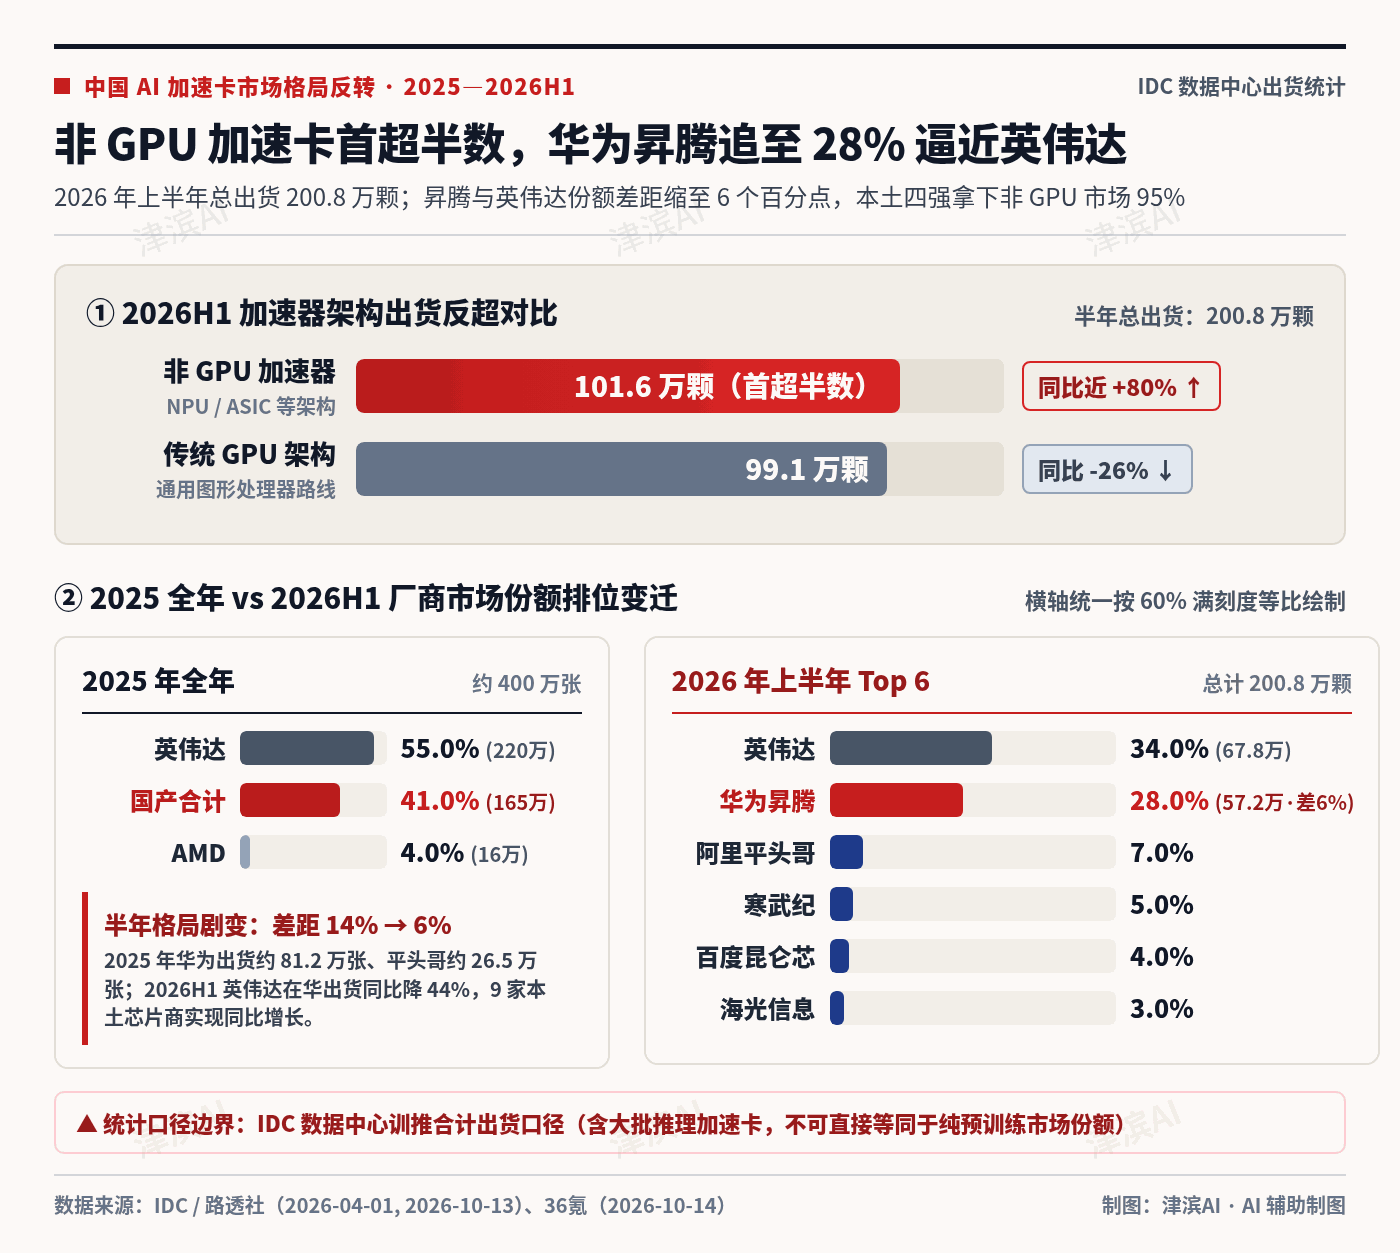
先看权威机构 IDC 统计的中国数据中心 AI 加速卡出货大盘。2025 年英伟达一家还独占国内过半市场(路透社,2026 年 4 月 1 日),到了 2026 年上半年,风向明显变了:非传统显卡路线的加速卡出货猛增近 80%,数量上第一次超过半数。厂商排名里,华为昇腾追到了 28%,距离降到 34% 的英伟达只差 6 个百分点,阿里平头哥、寒武纪、百度昆仑芯、海光信息紧随其后(各家份额变化见下图,路透社,2026 年 10 月 13 日,36氪,2026 年 10 月 14 日)。
不过咱们自己看账得清醒,不能看着 28% 就盲目乐观:第一,这份榜单把“日常陪聊回答问题的小卡”和“从头训练模型的大卡”混在一起算,华为等四家拿走了非传统显卡市场 95% 的份额;第二,它是按卖出去多少“张”卡来排名的,很多便宜省电的问答卡按张数算占了大头,真要是折算成全网高端训练的总算力,差距依然比账面上的 6 个百分点大不少(路透社,2026 年 10 月 13 日)。
真正让人提气的突破,是国产卡终于扛起了顶尖大模型的训练重活。2026 年 11 月 19 日,阿里巴巴 CEO 吴泳铭在财报会上正式宣布自家平头哥真武芯片全面上线,阿里千问已经在国产芯片上训练下一代主力模型(新华财经,2026 年 11 月 19 日)。更早的 4 月 24 日,华为也确认昇腾芯片参与了 DeepSeek 新模型的部分训练,彻底打破了“一流大模型非得靠外国显卡才能训出来”的老皇历(路透社,2026 年 4 月 24 日)。
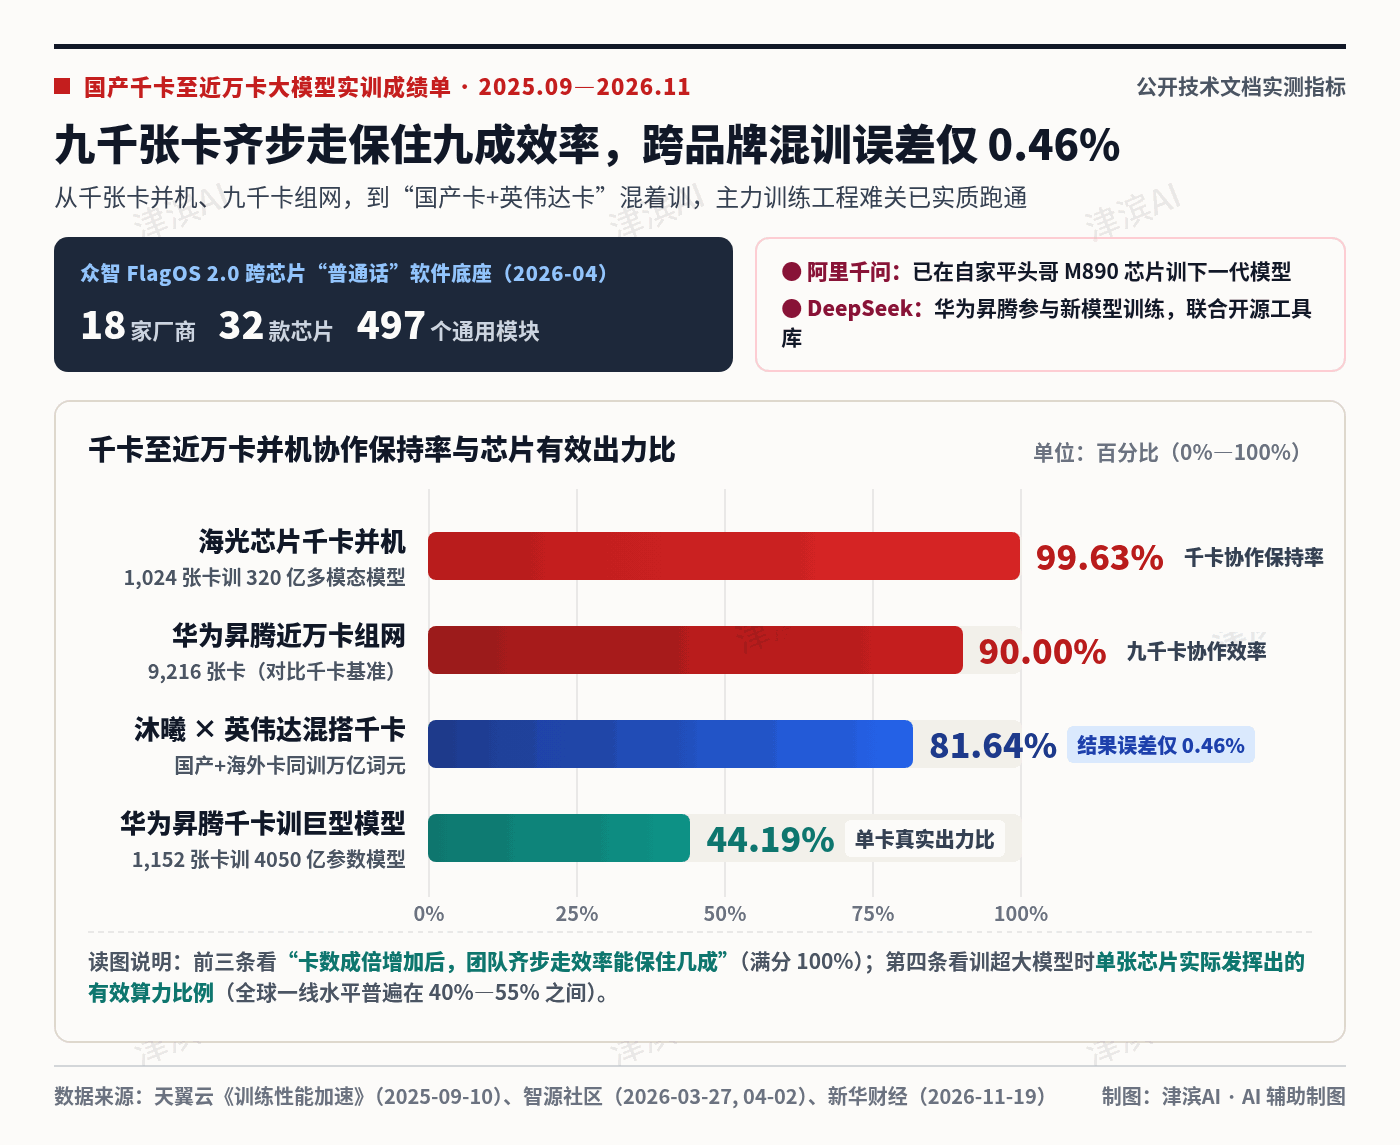
几千张甚至上万张国产卡绑在一起干活的本事也练出来了(见下图)。据天翼云公开测试文档(2025 年 9 月 10 日),把昇腾芯片从一千张扩到 9,216 张同时训模型,团队齐步走的效率依然保住了 90.00%,相当于九千人协同只比千人队慢一成。智源研究院牵头做的跨芯片“普通话”软件底座(FlagOS 2.0)已经打通了 32 款不同品牌的芯片(智源社区,2026 年 4 月 2 日),甚至能把国产沐曦显卡和英伟达显卡混插在同一个千卡机房里合训大模型,最终跑出来的结果误差只有 0.46%(智源社区,2026 年 3 月 27 日)。
放到咱们天津本地的产业一线看,天津大学联合智谱华章在 2026 年 11 月 19 日发布的 560 亿规模“天华开物”生物酶设计大模型,同样跑通了国产算力本地部署,让药企和化工厂最金贵的核心配方数据不用出厂门就能用上大模型(天津政务网,2026 年 11 月 20 日,新华网,2026 年 11 月 19 日)。
前头还剩四道硬坎,企业怎么选卡才不花冤枉钱?
解决了“能不能训”的生存问题后,往深水区走还有四道更难啃的硬骨头。
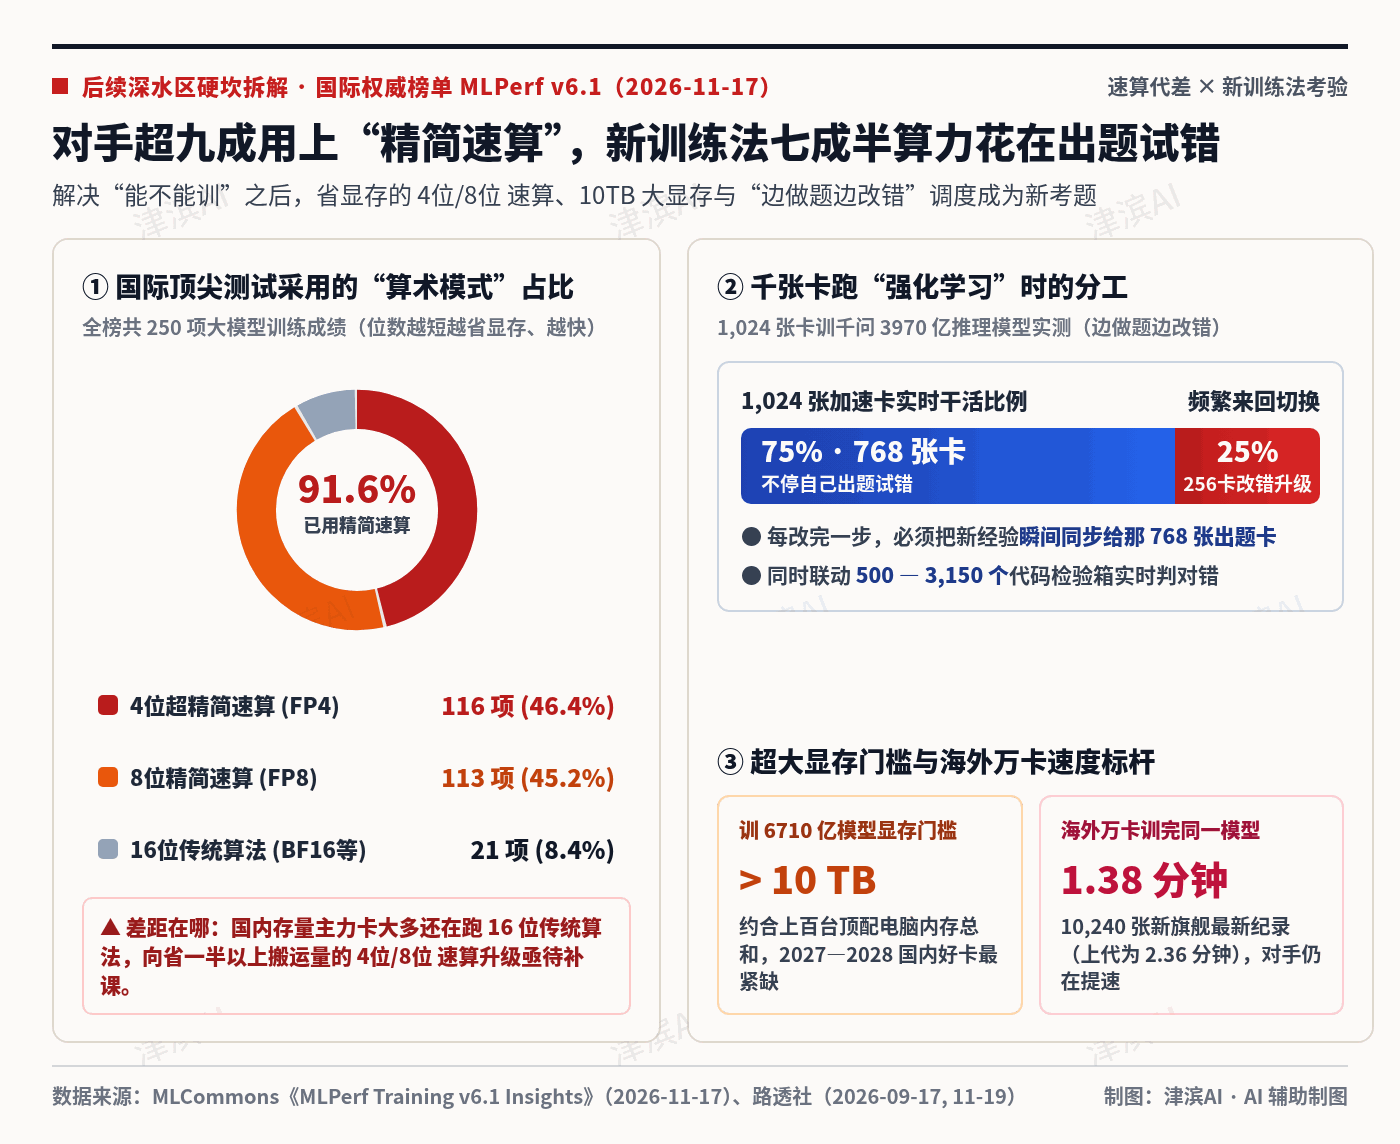
第一道坎,是海外对手换上了“更省力气的精简速算”。在 MLCommons(2026 年 11 月 17 日)刚公布的国际权威训练榜单上,一万张海外最新旗舰卡训完一个超千亿模型只要 1.38 分钟。更值得警惕的是算法代差:全榜 250 项成绩里有超 91% 都用上了 4 位或 8 位“精简速算”(占比见下图)——好比把原本 16 位长的数字压缩成四分之一来搬运计算,既省显存又翻倍提速;而国内大批存量主力卡还在跑 16 位老算法,这门速算课必须抓紧补上。
第二道坎,是大显存和先进造芯产能“有钱也难抢”。训一个顶级大模型,光把中间状态装进显卡就得占掉超 10TB 高速显存,相当于上百台顶配电脑内存加一块儿(MLCommons,2026 年 11 月 17 日)。受光刻机和高端显存产能限制,华为徐直军坦言国内算力设备供不应求(路透社,2026 年 9 月 17 日),阿里吴泳铭更明确提醒:2027 到 2028 年将是国内算力最紧缺的两年(路透社,2026 年 11 月 19 日)。
第三道坎,是“大厂派专家驻场能跑通”不等于“普通公司买回去就会用”。互联网大厂养得起几百号底层高手贴身改代码,普通企业根本没这笔人力预算,一旦国产卡软件报错说得云里雾里,光查故障就能把工期拖垮。
第四道坎,是国产卡“十几套方言”撞上了“边做题边改错”的新训练法。国内十几家芯片各有各的指令语言,不统一标准就得反复重做适配(智源社区,2026 年 4 月 2 日)。偏偏如今训练深度思考模型最流行的方法(强化学习),一千张卡里有 75% 的算力在不停自己出题试错、只有 25% 在集中改错升级(切分见下图),每改完一步还得把新经验瞬间同步给全场,并同时调动最多三千多个检验箱判对错(MLCommons,2026 年 11 月 17 日),调度软件稍微跟不上就会全盘卡壳。
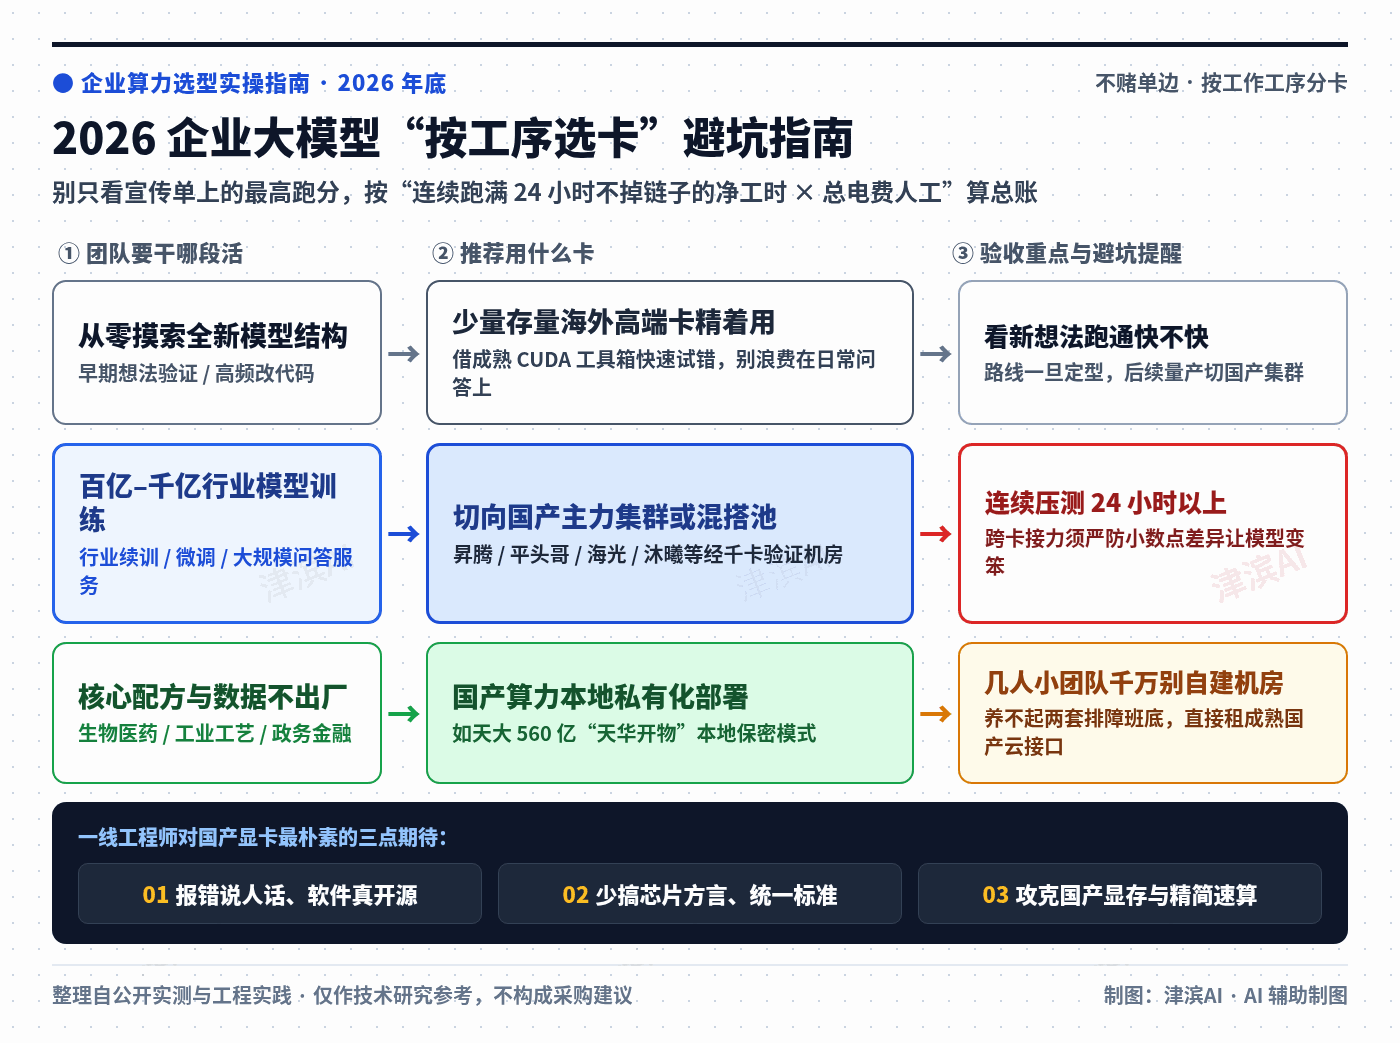
摸清了这四道坎,大中型技术团队最实在的策略就是别把鸡蛋放一个篮子里,按工作工序“分卡干活”:从零摸索全新模型想法时,好钢用在刀刃上,用手头少量的海外高端存量卡快速试错。等技术路线试通了,进入行业模型正式训练、微调和日常大规模问答服务时,果断切到昇腾、平头哥、海光、沐曦这些经受过千卡考验的国产机房。如果是医药配方、工业机密或政务金融这类绝不能出厂的数据,直接把国产算力搬进自家内网最踏实。
这里特别提醒一个容易踩的暗坑:如果把海外卡训了一半的模型搬到国产卡上接着训,两边小数点算法的细微差别有时会让“程序一句错都不报,训出来的模型却悄悄变笨了”,而且同时养两套技术班底非常烧钱。所以“混搭接力”只适合有实力做严格质量比对的大中型团队。要是公司里就几名应用工程师,千万别自己买卡建机房折腾,直接租成熟的国产算力云接口最省钱省心。
追到 28% 靠的是封锁线里不服输的硬气,跨过深水区靠的是把软件细节和电费成本一笔笔抠出来的耐性。
替一线干活的工程师说三句最实在的期盼:一盼国产卡软件报错多说人话、工具彻底开源,少让大家熬夜猜谜;二盼各家厂商少搞封闭小圈子、尽快统一“芯片普通话”,别让程序员把精力耗在重复改代码上;三盼早日攻克国产高速大显存良率与精简速算,让国产卡从“买不到外国卡时的救急替代”,真正变成“算总账更省钱的首选”。
知识延伸:为什么买训练显卡不能只看宣传单上的“最高跑分”?
企业买训练算力,如果只拿宣传单上的“理论最高速度”除以价格,就像买长途重卡只看仪表盘最高时速一样容易吃亏。上千张卡一起训模型,真正拼的是“拉满货跑长途不抛锚的净工时”——也就是扣掉中途网线闪断、死机重启、停车备份之后,真正花在让模型变聪明上的有效时间。
另一个容易被忽视的落差是“柜子里面快、跨出柜子慢”:同一个超节点机柜内部显卡传数据像跑八车道高速,一旦跨出机柜走普通网络,传输速度往往会慢上十倍左右(MLCommons,2026 年 11 月 17 日)。签采购或租用合同前,最管用的土办法就是把自家的真实模型放上去连续跑满 24 小时以上,算清楚“把模型训达标一共烧掉多少电费、耗掉多少人工”,这把尺子最不会骗人。
说明:本文由 津滨AI 编辑部借助 AI 辅助检索公开研报、学术论文与财报披露并完成初稿整理,经人工逐条核对 IDC 统计口径、路透社与新华财经原报道、天翼云与智源公开技术文档及 MLCommons v6.1 结果后审校定稿;文内概念题图由 AI 辅助生成(非实拍),五张数据统计与对比决策图由 津滨AI 基于公开核实资料自制。本文仅作算力基础设施技术与产业研究参考,不构成任何硬件采购或证券投资建议。
参考资料
- Reuters (2026-04-01):Chinese chipmakers claim nearly half of local market as Nvidia's lead shrinks
- Reuters (2026-10-13):Nvidia's China AI-chip share falls as Huawei closes gap, report finds
- 36氪 (2026-10-14):英伟达与华为的6个百分点:中国AI芯片市场竞争格局生变
- Reuters (2026-11-18):Tencent says new US chip curbs won't hurt cloud revenue, may slow model training
- Reuters (2026-11-19):TSMC tightens China AI chip curbs as new US rules close manufacturing loophole, sources say
- 新华财经 / 东方财富网 (2026-11-19):阿里巴巴集团CEO吴泳铭:平头哥三代GPU加速推进 正成为阿里全栈AI的支撑底座
- Reuters (2026-11-19):Alibaba tops revenue estimates on AI cloud growth; profit up on investment gains
- Reuters (2026-11-20):US AI chip curbs hit China tech stocks, spur self-sufficiency push
- Reuters (2026-04-24):DeepSeek-V4, the Chinese AI model adapted for Huawei chips
- Reuters (2026-09-30):DeepSeek partners with Huawei to develop chip programming tools, reducing reliance on Nvidia
- Reuters (2026-09-17):China's Huawei says AI chip demand outstrips supply as it steps up Nvidia challenge
- arXiv (2025-06-19):Serving Large Language Models on Huawei CloudMatrix384
- 天翼云文档中心 (2025-09-10):训推服务—训练性能加速
- 智源社区 (2026-03-27):六款AI芯片、三大模型、同构+异构千卡——众智FlagOS以统一技术栈完成AI训练“全要素”验证
- 智源社区 (2026-04-02):众智FlagOS 2.0正式发布:32款AI芯片、497算子、Skills专业技能库首发
- 天津政务网 / 天津日报 (2026-11-20):国内自主研制的酶设计基座大模型在津发布
- 新华网 (2026-11-19):我国自主研发酶设计基座大模型“按需定制”工业酶
- MLCommons (2026-11-17):MLPerf Training v6.1: Bigger Clusters, Broader Hardware, and the Rise of Software-Driven Gains