大模型已经能让 GPU 模块的 PPA(功耗、性能与面积)权衡改进至多 14% 了,为什么云巨头还在急着抢封装厂的排期?[1][2]
2026 年 11 月 18 日(北京时间 11 月 19 日),半导体行业同日拍出两份重磅公告[1][2][3][4]。OpenAI 在技术报告《Advancing chip design with OpenAI models》中披露,模型帮自研芯片减掉约 13% 单元面积,帮 AMD 旗舰 GPU IP 把 PPA(功耗、性能与面积)拉高至多 14%[1][3];同日,微软与英特尔签下长期协议,公开宣布将把 Intel Foundry 的 EMIB 先进封装用于 Azure 自研芯片,并锁定多年期 Xeon 产能[2][4]。
前端 AI 写电路一路高歌,后端大厂却在排队锁产线。
账本摊开,反差背后的答案其实很清楚:大模型此刻撬动的只是芯片设计的前半段,真正卡住流片与供货节奏的,还站在物理世界那道铁门后面。
先算前端红利:Jalapeño 省 13% 面积,AMD 旗舰 GPU IP 的 PPA 改进至多 14%
先看 OpenAI 交出的正面账目,这组实绩并不虚[1]。
2025 年初,OpenAI 工程师就开始用 GPT-4o 辅助设计初代自研推理芯片 Jalapeño[1]。2026 年 8 月硅片带电验证(bring-up)后,团队估算模型提出的电路改写让向量单元标准单元面积减约 13%,矩阵单元减约 10%[1][5]。拆进矩阵单元细看,一版乘法器方案把综合后面积压低约 15%,运算延迟从 2 个时钟周期缩到 1 个周期;另一版加法器方案同样减掉约 15% 面积,稳住原有的 2 周期延迟[1][3]。
这套方法很快推进到了第三方量产芯片上[1]。与 AMD 联合攻坚时,模型直接重写描述电路的 SystemVerilog RTL 代码,再接入 Synopsys 工具链逐轮校验证等价性与 PPA 权衡[1]。在 AMD 旗舰 GPU IP 上,模型相对高度优化基准又挤出至多 14% 的 PPA 改进——OpenAI 称,这相当于把约一年的优化进展压进了不到 5 个月[1][3]。AMD 已将部分改写送交制造,其余并入后续生产设计文件,并在下一代旗舰 CPU 关键模块里验证了个位数百分比的 PPA 提升[1]。
为把这套能力工具化,OpenAI 与 Synopsys 于 2026 年 9 月 30 日签署多年期协议,联合训练专用模型 GPT-Synopsys,使其原生操控 Synopsys.ai 与 Autopilot 推进 PPA、时序和验证收敛[1][6]。该联合服务将打包交付算力、模型与工具许可,客户设计数据全程加密且不用于模型训练,目前正与头部芯片客户做早期技术对接[6]。
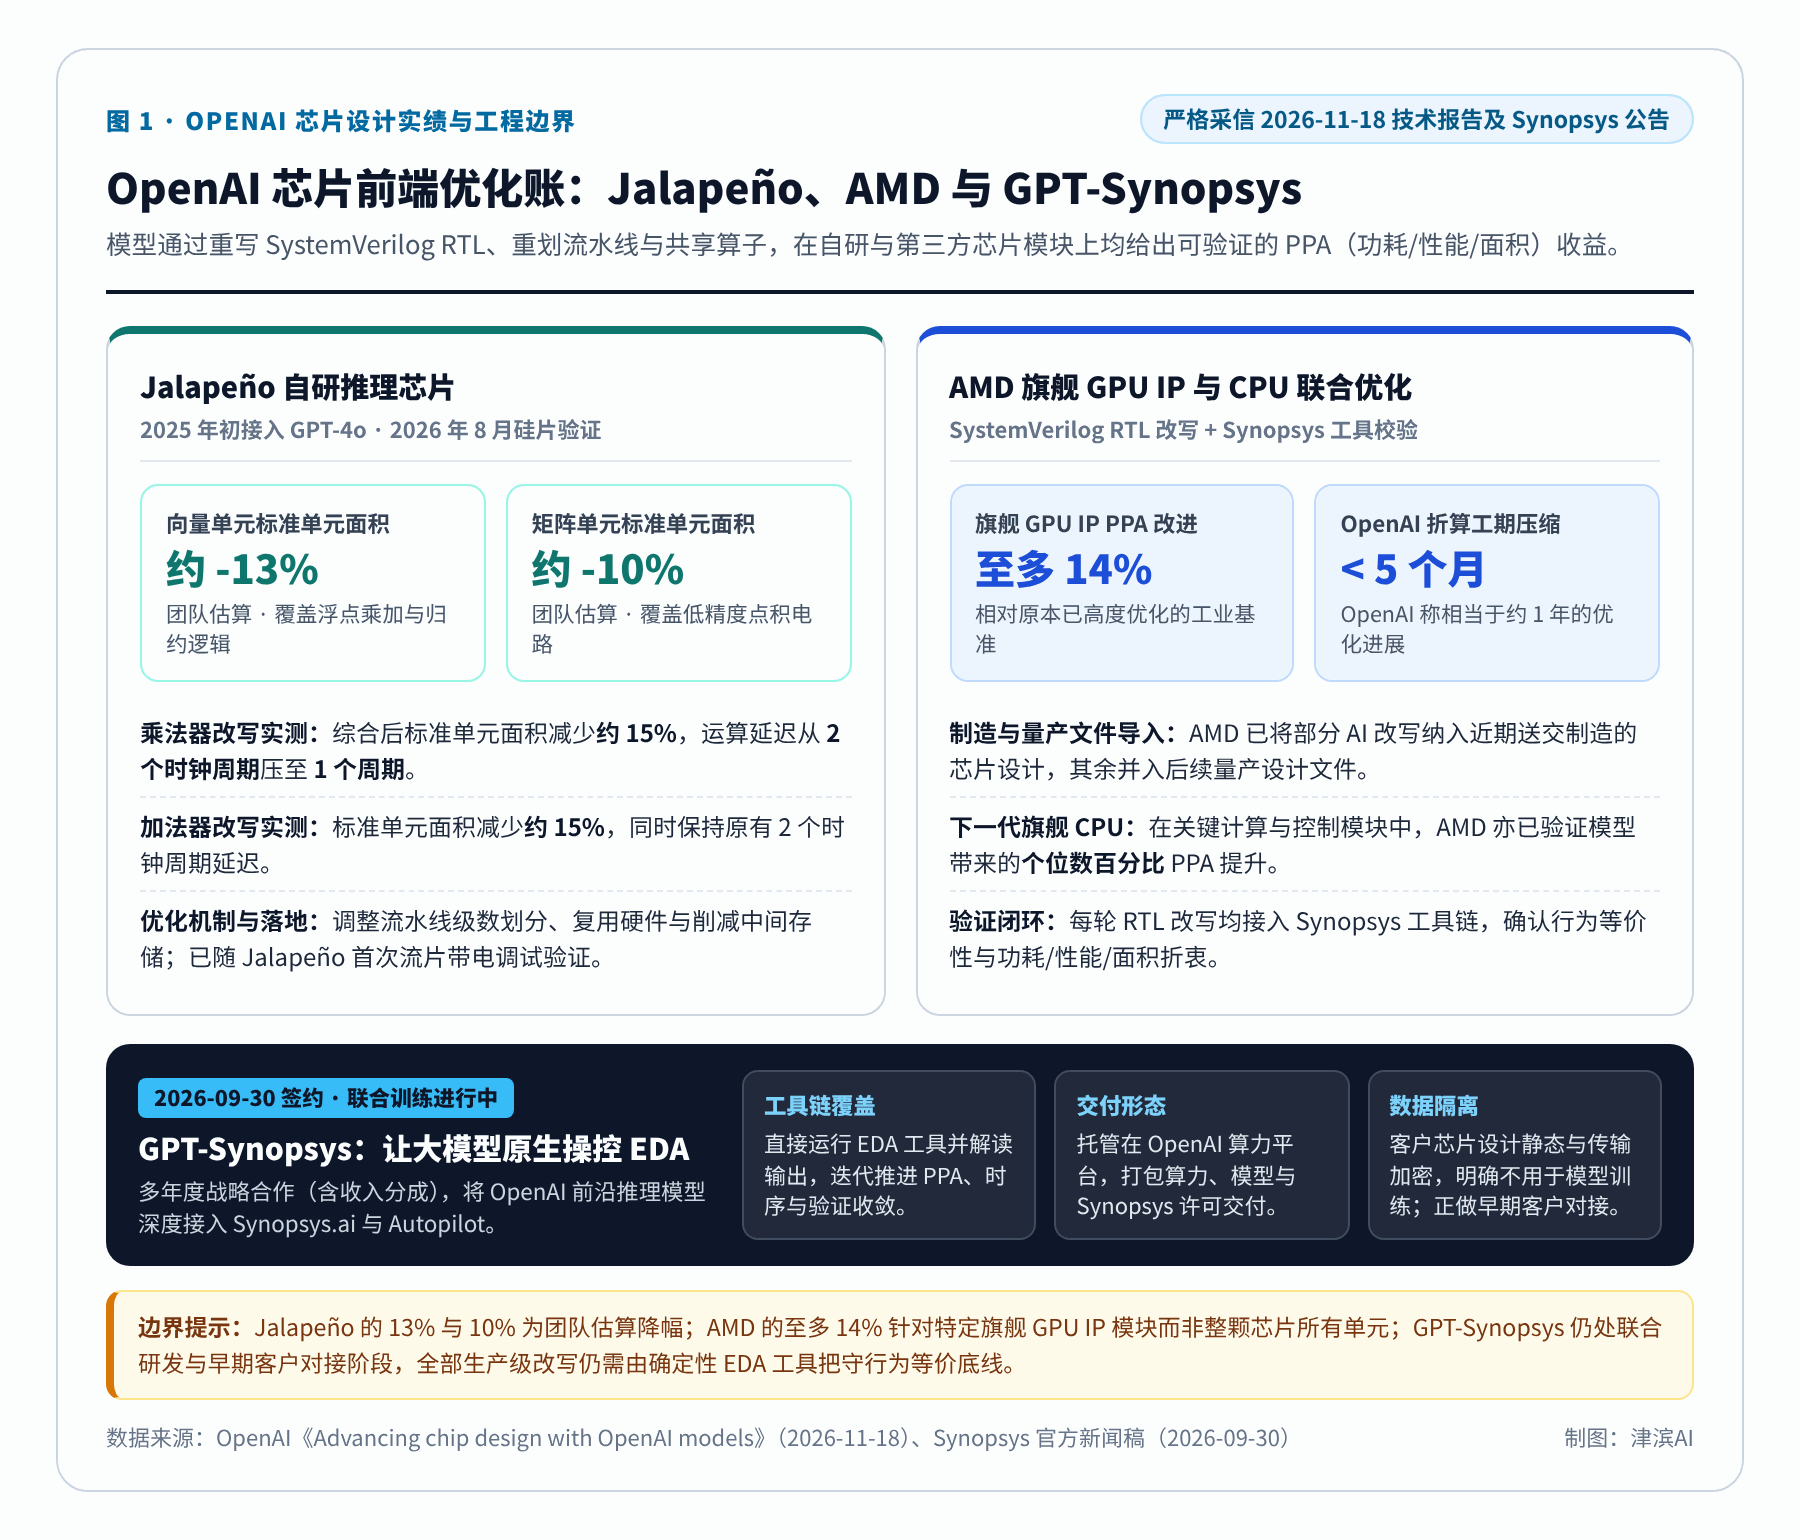
配图说明:图 1 保留了报告中的“团队估算”“至多 14%”及“早期对接”等原始限定口径,未将特定 GPU IP 模块收益外推为整颗芯片幅度。
翻开 9,881 次评测的脚注:从头写 RTL 拿高分,为什么绕不过封装账
数字看着很猛,但只要翻到 OpenAI 报告后半段的评测脚注,画风立刻收紧[1]。
为测出不同代际模型的真实边界,OpenAI 拿两款开源 32 位 RISC-V 核——面向 FPGA 的 PicoRV32 与 OpenTitan 安全芯片嵌入式核 Ibex——跑了共 9,881 次计分评测[1][3]。在约 11.2 万 Token/次的预算下,GPT-6.2 Astra 在两核均分都排在五款模型首位,优化现有 PicoRV32 时均分大约是 GPT-6 Astra 的两倍,GPT-6.1 Sol 也胜过 GPT-5.6 Sol[1][3]。
反常的是第二组对照:当模型不再改旧代码,而是只照着书面规格与接口模板“从头写 RTL”时,全部五款模型得分全高于“优化现有核”,GPT-6.2 Astra 在 PicoRV32 上跨过 0.7 分,在 Ibex 上均值约为 0.75 分[1]。
从零写一颗处理器,怎么反倒比局部微调更容易拿高分?
OpenAI 自己在报告末尾道出了实情:从书面需求起步给了模型余地,可以跳过原核里原有的性能计数器、扩展指令等辅助特性[1][3]。这些电路对测试集里的吞吐跑分几乎没有帮助,却占着真实芯片的面积与功耗;换言之,高分里有一部分其实是“做减法删掉辅助模块”换来的[1]。不仅如此,评测放行了高达原核 16 倍的面积上限,频率靠 Yosys 估算,OpenAI 明确提醒,只有强制保留原有功能、收紧面积红线,并在物理综合之后检查时序,测试才接近量产芯片[1]。
同日落锤的微软与英特尔协议,把另一半硬账拍在了桌面上[2]。
2026 年 11 月 18 日,微软宣布成为首家在 Azure 自研芯片中采用 Intel Foundry EMIB(嵌入式硅桥多芯片互连)先进封装的企业,同时锁定含下一代 Diamond Rapids 平台在内的多年期 Xeon 产能[2][7][4]。双方顺势公布系统实测:搭载 CXL 内存与 Xeon 6 Flat Memory Mode 的 Azure M 系列 v4 虚拟机在特定沙盒负载下性能至多升至 2.3 倍,启用 Intel QAT 加速的虚拟机将 SQL 备份提速至多 2.5 倍,Intel TDX 负责跨主机热迁移时的内存与寄存器加密[2][7][4]。
但核对微软新闻稿与独立技术媒体拆解表,同样有两笔留白不能漏掉[7]。其一,2.3 倍与 2.5 倍实测分别跑在沙盒负载与硬件配置并不完全等同的对比虚拟机上(vCPU、内存与处理器代际均有差异)[7];其二,双方既没点明采用 EMIB 的具体 Azure 芯片型号,也没披露封装结构、产量和投产排期[7]。而微软多线押注的直接推手,正是 AI 芯片挤爆台积电 CoWoS 产线,云巨头必须提前卡位第二条互连通道[8]。
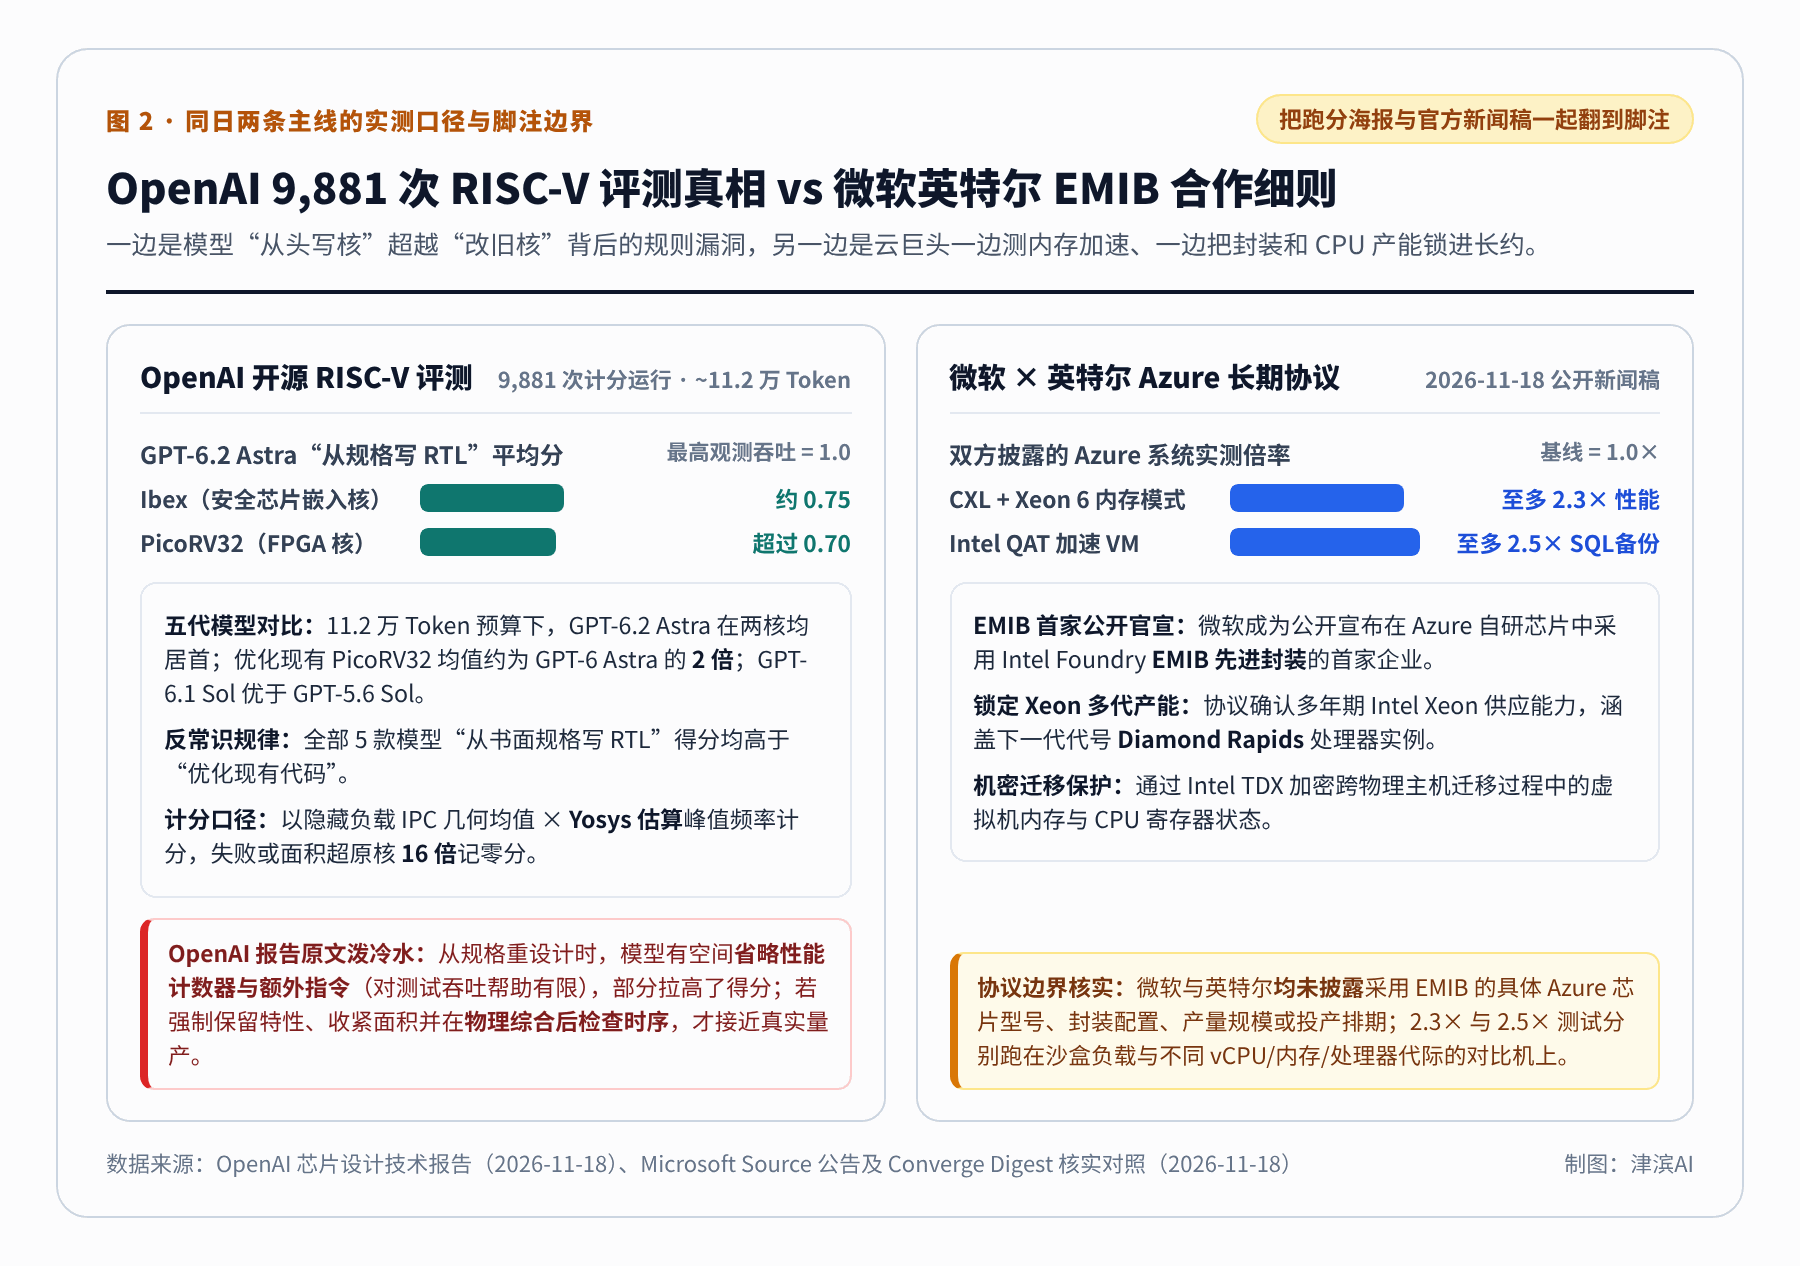
配图说明:图 2 左侧标明 RISC-V 评测放宽 16 倍面积及缺少物理综合后时序校验的原始前提,右侧注明微软与英特尔未公开具体 EMIB 芯片型号与排期。
前端代码和后端硅片是两本账:我的判断与不成立条件
算完前后端这两笔账,结论很明确:AI 模型此刻压低的只是芯片前端 RTL 探索的时间与人力成本,还无法替企业跨过后端物理综合与先进封装的物理铁门[1][7]。前端把架构试错从一年压进几个月后,流片排期与 EMIB、CoWoS 封装产能反而会成为更紧的卡口——OpenAI 在前端提速、微软在后端锁封装和 CPU 产能,合起来才是云端芯片完整的账。
当然,反方观点也有成立的理由[1][6]。对无需多芯片高带宽拼接的成熟制程控制芯片、普通微控制器或单颗 FPGA 原型团队而言,既用不上 EMIB 也不抢 CoWoS,先进封装不在关键路径上[8];如果 GPT-Synopsys 未来几年打通后端布局布线闭环,AI 参与物理收敛的深度也可能高于当前预期[6]。
把条件收窄看,这套“前端提效、后端锁产能”的双账判断在三类情形下并不成立:芯片面积够小、无需 2.5D/3D 多裸片互连封装;工程停留在可编程 FPGA 原型或高度固化的标准单元微调;或产品允许为成熟单芯片放宽功耗与频率上限。只要落在这些范围里,前端省下的工期就能直接兑现成上市速度。[7][8]
知识延伸:AI 写 RTL 停在哪一步?看懂物理综合与 EMIB 互连铁门
模型在 SystemVerilog 阶段砍下 10% 到 15% 单元面积,为什么还被 OpenAI 提醒“没过物理综合时序关”?拆开芯片工程关键节点就明白了[1][7]:
- 前端逻辑综合(AI 已打出杠杆):就像 Jalapeño 重划乘法器流水线级数、共享浮点逻辑并削减中间存储,这层处理的是 RTL 级布尔等价变换与门级映射[1]。只要目标清晰、仿真能兜住等价性,模型就能高频试错,把微架构师数月的调优探索迅速筛出来[1]。
- 物理综合与时序收敛(真刀真枪碰物理规律):一旦逻辑网表落到硅片版图,金属走线寄生参数、布线拥塞、供电网络压降(IR drop)和局部热点全会冒出来[1]。Yosys 估算出的频率在真实布局布线里可能因几条长走线拉不直而掉频,这也是 OpenAI 强调必须在物理综合后复查时序的原因[1]。
- 异构先进封装(代码变不出产线):当单颗裸片面积撞上光刻掩模上限,厂商必须把计算芯片与内存拆开再互连[7][8]。微软签约的 Intel Foundry EMIB,是在有机封装基板凹槽内嵌入小型多层硅桥,只在相邻裸片边缘用细间距微凸块拉通高密度短距互连,其余区域用粗凸块接回基板,从而绕开整块大尺寸硅中介层的产能瓶颈[7][8]。这类微米级封装工艺全靠晶圆厂和封装厂的硬产线堆出来,写代码的大模型插不上手[7][8]。
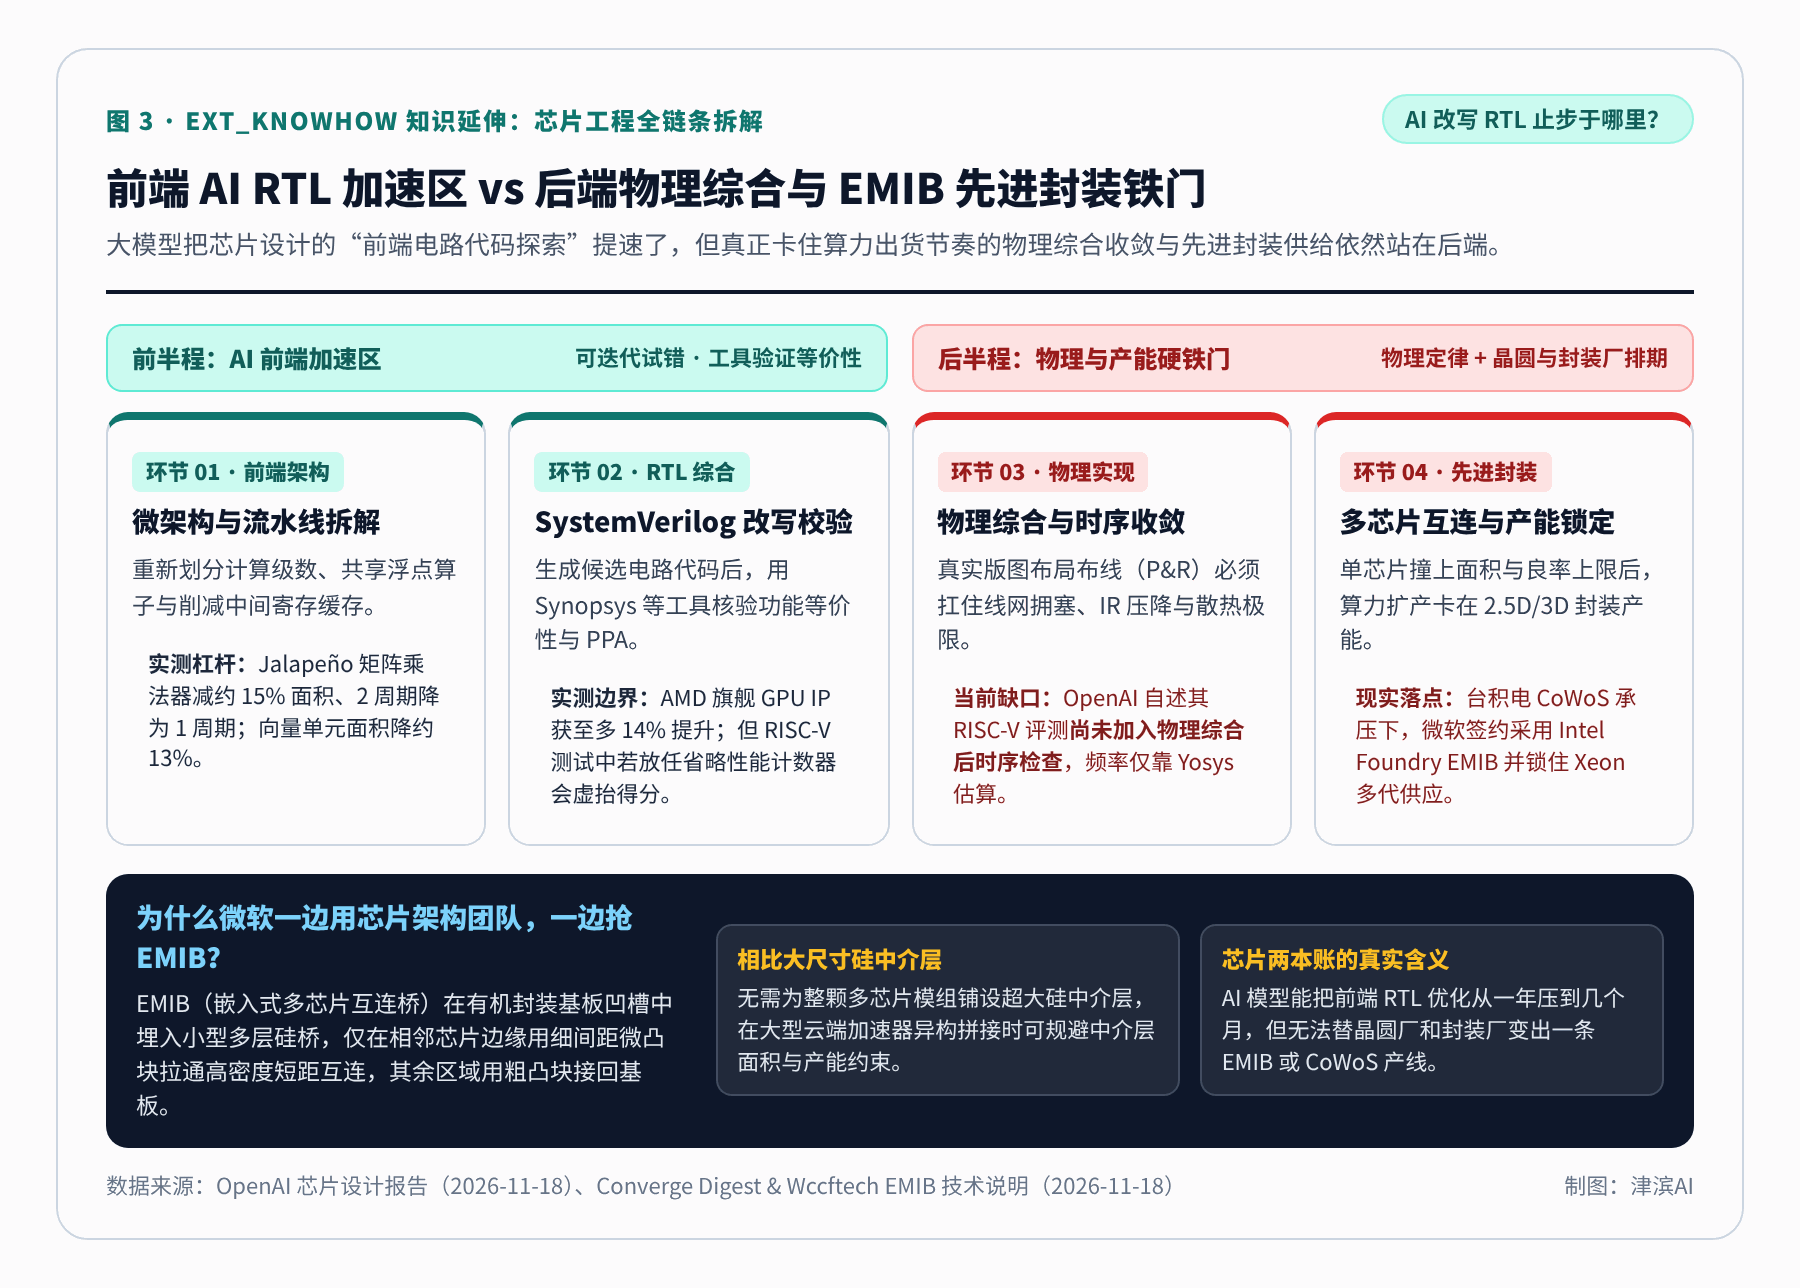
配图说明:图 3 将 OpenAI 报告披露的 RTL 优化杠杆与微软采用的 EMIB 基板埋桥物理结构放在同一工程链条中对照。
下一次再看到“AI 独立设计芯片”或“省出一年研发工期”的捷报时,先别急着改算力交付预期,不妨按顺序对三本明细账[1]:
- 有没有拿掉非跑分功能——性能计数器、调试接口与异常指令集是不是完整留在了 RTL 里?
- 面积和频率卡在哪里——时序指标是逻辑综合估算,还是过完了真实物理综合与签核?
- 硅片写完去哪封——多裸片互连所需的 EMIB 或 CoWoS 产能、以及配套服务器 CPU 供应,在工厂排期表上占到位置了吗?
三笔账对不上,前端代码跑得再快,硅片也还是卡在半路上。[1][7]
说明:本文由 津滨AI 借助 AI 辅助检索与起草,并经人工逐条核对 OpenAI、Synopsys、微软及公开科技媒体信源审校;文首题图由 Nano Banana Pro 概念生成(非实拍),其余 3 张信息图均依据公开披露数据自制渲染,不代表任何企业官方立场。
参考资料
[1] Advancing chip design with OpenAI models | OpenAI (2026-11-18):https://openai.com/index/advancing-chip-design-with-our-models/
[2] Microsoft and Intel deepen collaboration to deliver differentiated Azure infrastructure | Microsoft Source (2026-11-18):https://news.microsoft.com/source/2026/11/18/microsoft-and-intel-deepen-collaboration-to-deliver-differentiated-azure-infrastructure/
[3] OpenAI 发布最新技术报告:利用 AI 模型辅助芯片设计,Jalapeño 向量计算单元面积减约 13% | IT之家(2026-11-19):https://www.ithome.com/1/029/135.htm
[4] 微软与英特尔深化合作:Azure 自研芯片采用 EMIB 先进封装,锁定多代 Xeon 产能 | IT之家(2026-11-19):https://www.ithome.com/1/029/122.htm
[5] Jalapeño first results | OpenAI (2026-08):https://openai.com/index/jalapeno-first-results/
[6] OpenAI and Synopsys Announce GPT-Synopsys: Frontier Intelligence to Revolutionize Chip Design | Synopsys (2026-09-30):https://investor.synopsys.com/news/news-details/2026/OpenAI-and-Synopsys-Announce-GPT-Synopsys-Frontier-Intelligence-to-Revolutionize-Chip-Design/default.aspx
[7] Microsoft Picks Intel EMIB for Azure Silicon | Converge Digest (2026-11-18):https://convergedigest.com/microsoft-intel-emib-azure-xeon-diamond-rapids/
[8] Microsoft Becomes The First Announced Intel EMIB Customer For Its Azure Custom Silicon, Also Locks In Multi-Year Xeon Capacity That Includes Next-Gen Diamond Rapids | Wccftech (2026-11-18):https://wccftech.com/intel-microsoft-emib-foundry-diamond-rapids-chip-capacity-for-azure/
