2026 年 11 月 20 日,OpenAI 晒出了一份火药味十足的技术报告:自 2026 年夏天起,他们每周都要按团伙封掉数千乃至数万个违规账号(OpenAI,2026 年 11 月 20 日)。这些账号既没发垃圾广告,也没去撞库盗密码,干的全是同一件事——凑在接口前疯狂提问,把顶尖大模型的回答和解题草稿悄悄搬回家,喂给自家模型“偷师学艺”。
不少读者看完一头雾水:平时看技术新闻,“知识蒸馏”明明是帮企业省显卡、降电费的正经手艺,怎么转头又成了大厂围追堵截的灰色捷径?更让人好奇的是,文字又没刻名字,抄完拿回去换套近义词“洗一遍稿”,原厂凭什么还能顺藤摸瓜抓个正着?
科技科普创作者「野菜人」打过一个特别传神的比方:整场攻防战,说白了就是一场“AI 界的米其林后厨菜谱防伪战”。顺着后厨做菜这根线往下捋,蒸馏、反蒸馏和模型指纹这三个听着唬人的硬核词,五分钟就能看个通透。
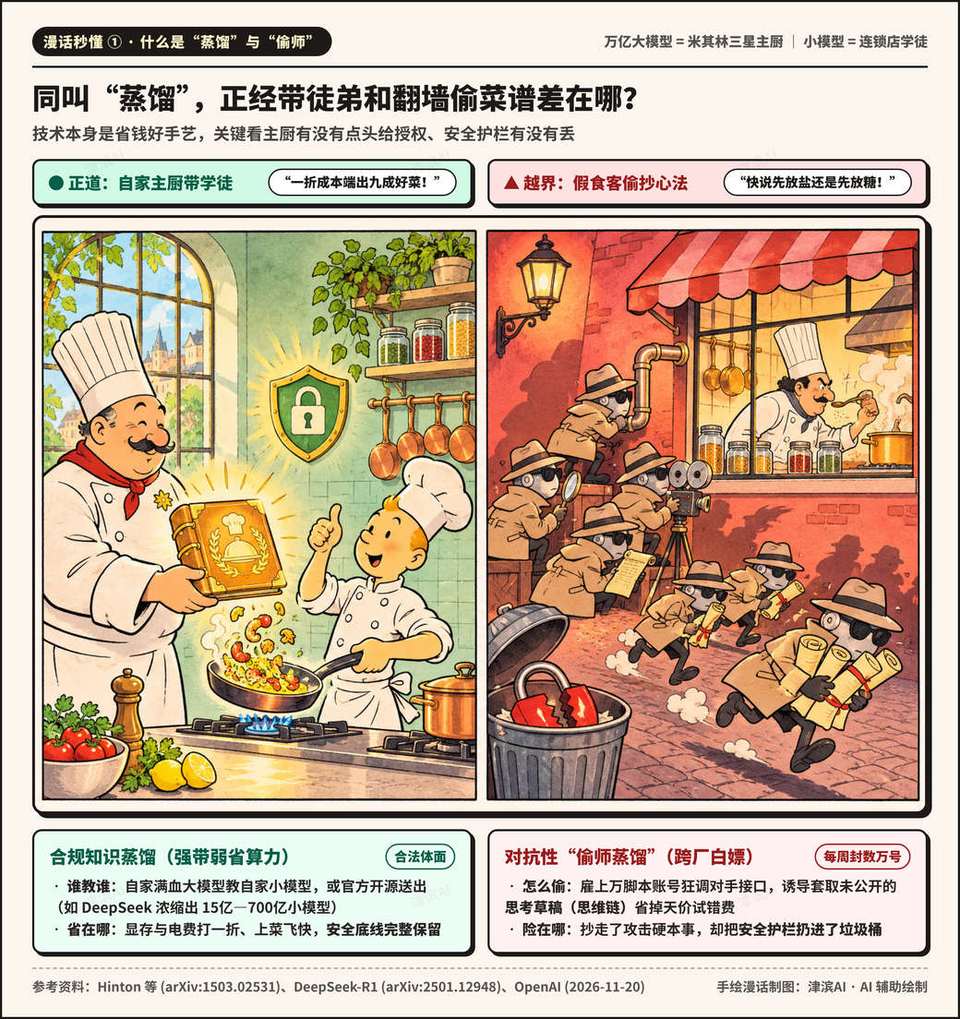
同样叫“蒸馏”,自家带徒弟和翻墙偷菜谱差在哪?
先把一个最容易冤枉好人的误区解开:“蒸馏”这门技术本身半点不脏,反而是你每天手机里都在享受的省钱功臣。
你可以把参数动辄上万亿的顶尖大模型,想象成一位米其林三星主厨。主厨手艺登峰造极,可请他炒一盘青椒肉丝得慢工细活半小时、收五百块出场费,普通街边连锁店根本请不起。早在 2015 年 3 月 9 日,图灵奖得主杰弗里·辛顿(Geoffrey Hinton)与同事就在经典论文中提出了“知识蒸馏”(arXiv,2015 年 3 月 9 日):让自家请得起的大主厨先去刷海量考题,把每一步火候拿捏和配料比例浓缩成一本《标准做菜手册》,拿去手把手带教自家个头小、上菜快的小学徒模型。
学徒虽然没有主厨那么博学,但只要跟着手册练熟了,显存占用和响应延迟打个一折,照样能端出主厨八九成功力的好菜。比如 DeepSeek 团队在 2025 年 1 月 22 日发布的 DeepSeek-R1 论文(arXiv,2025 年 1 月 22 日)里,就大大方方用自家训好的满血大模型当老师,一口气浓缩教出了 15 亿到 700 亿参数的六款轻量小模型开源送给全行业,普通公司拿几张常规显卡就能在本地跑起来。这种“自家主厨带自家徒弟”或者“开源主厨敞开门送菜谱”,合规体面,没有任何毛病。
真正让闭源巨头掀桌子的,是跨厂白嫖的“对抗性偷师蒸馏”。
从零预训练一位新主厨,光买卡烧电和反复试错就得砸进数亿美元。有些团队不想掏这笔冤枉钱,便雇来上万个“假食客”——也就是代理池与自动化并发脚本,钻进竞争对手的 API 接口里昼夜点单,直接撞破了服务商“禁止用本平台输出训练竞争模型”的协议红线(OpenAI 使用政策,2026 年)。
更刁钻的是,假食客点菜绝不满足于端走一盘成品菜。他们专门设计连环诱导词,逼着主厨把“几成油温下锅、先放盐还是先放糖、哪一步差点炒糊又怎么补救”的后厨心法一字不落默写出来——这就是行话里最值钱的内部思考草稿(思维链)与工具调用轨迹。OpenAI 在 2026 年 11 月 20 日的对照实验里把账算得很透:拿同一个学生底座去学网络安全任务,偷学了“完整原始思考草稿”的学生,考分明显压过只看“公开简短总结”的学生(OpenAI,2026 年 11 月 20 日;Anthropic,2026 年在软件编程测试中也验证了同一现象)。最悬的是,偷师者把攻击与推理真本事抄走了,原厂花重金焊死的安全护栏却没抄过去,一旦流向高危领域就会埋下大雷。两种“蒸馏”的一念之差,对照下图一看便知。
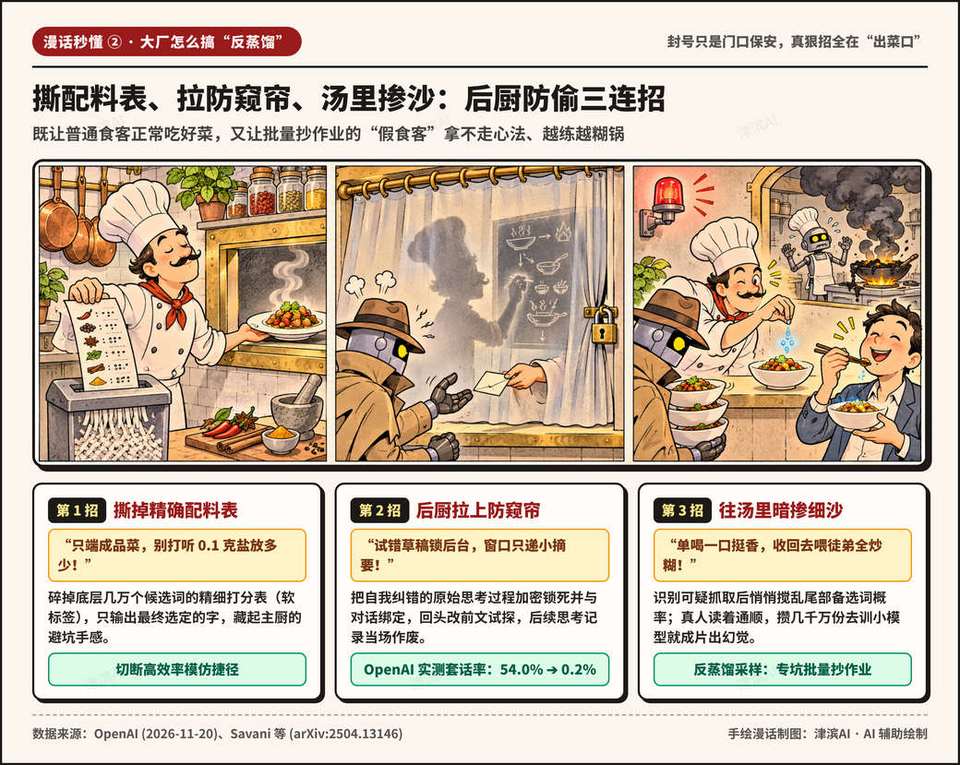
出菜口设卡、汤里掺细沙,大厂怎么防偷又怎么靠“指纹”抓包?
发现后厨有人偷师,光靠门口保安封账号其实最被动——封掉一批号,对方换串代理 IP 第二天又来了。真正狠的“反蒸馏”,是直接在出菜口动刀子,目前一线大厂主要使出了三招连环闸。
第一招叫“撕掉精确配料表”。 大模型在屏幕上蹦出每一个字之前,心里其实给词表里几万个候选词都打好了分数:比如“室外天气真”后面,“好”占 75%、“晴朗”占 18%,连八竿子打不着的“西瓜”都有个 0.001% 的极低分。早年不少接口会把这张精确到小数点后几位的打分表原样退给调用方,等于把主厨“哪些调料能放、哪些雷区千万别碰”的配料克数全交了底。如今主流闭源旗舰干脆锁死或砍掉底层打分表,只把最终挑出来的成品字端上桌。
第二招叫“后厨拉上防窥帘”。 既然偷师者最眼馋中间自我纠错的思考草稿,系统就把原始思考过程死死锁在自家服务器后台,你在网页上看着“正在思考”转圈圈,端出来的其实是一份脱敏删减后的简报。OpenAI 在 GPT-6.2 Astra 与 GPT-6.2 Sol 上还加了一把硬锁:把加密思考记录和当前对话历史死死绑在一起,只要你回头改掉前面一句提问想试探它怎么变招,接口当场把后面的思考记录全部作废,连工具调用的参数都会被输出安检员逐字过筛(OpenAI,2026 年 11 月 20 日)。这一套组合拳下来,面对 6 个 AI 攻击模型的轮番套话,上一轮思考草稿被套出的成功率从旧版的 54.0% 断崖跌到了 0.2%,本轮套取率也从 22.9% 压到了 0.9%(防线升级前后实测落差与后厨三连招见下图)。
第三招最损也最妙,叫“往汤里暗掺细沙”。 卡内基梅隆大学等机构学者在《反蒸馏采样》论文(arXiv,2025 年 10 月 26 日修订)里拆解过这套机制:一旦后台识别出疑似批量抓取的可疑流量,系统甚至不急着踢人下线,而是在挑词输出的瞬间,在不改动正常首选词意的前提下,故意把排在后面的备选词概率搅乱、拉平,或者在长推理链里塞进极隐蔽的细碎噪声。普通用户单吃这一口汤,文字照样通顺、代码照样能跑;可偷师者要是攒下几千万份“微调过火候”的菜谱回去喂模型,小徒弟越练越偏,一遇上复杂长任务就成片“糊锅”说胡话。
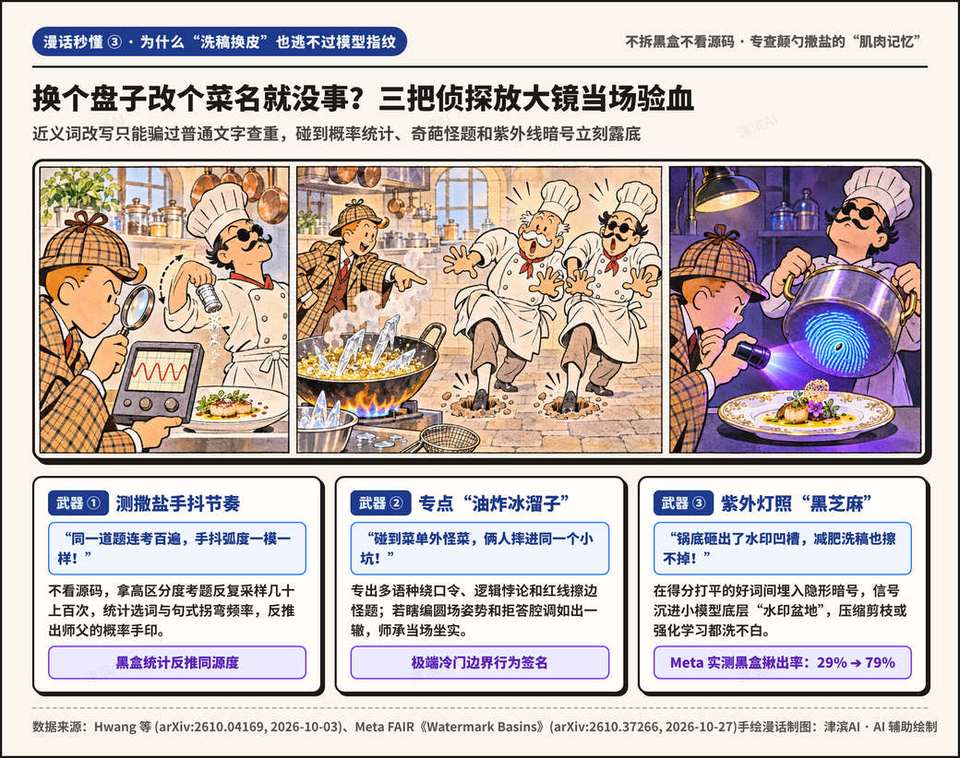
那要是有人赶在设防前偷完了菜谱,回去还特意把所有回答用同义词改写“洗了一遍稿”、换了个新盘子端出来,还能抓到现行吗?
答案是:照样一抓一个准。 普通文字查重看的是菜盘表面摆盘,而模型指纹查的是厨师颠勺撒盐的“肌肉记忆”。就算对方把代码权重锁在黑盒子里绝不公开,稽查人员手里也有三把验血武器:
- 测撒盐的手抖节奏(黑盒概率轮廓比对)。 就像老厨师撒盐的落点节奏改不掉,审计人员拿同一批高区分度考题让嫌疑模型反复答几十上百遍,统计它的选词偏好、句式拐弯习惯,跟当年破译密码电报一样反推出底层的概率手印。
- 专点一道“油炸冰溜子”(极端冷门怪题探针)。 进店不点家常菜,专挑菜单上压根没有的多语种绕口令、自相矛盾悖论或擦边红线题去考它。两个号称“各自闭门苦练”的模型,碰到同一道奇葩怪题时,居然用同一种姿势瞎编圆场、弹出同一套拒答腔调、甚至一脚踩进同一个冷门逻辑小坑,师承关系当场就露了底。
- 紫外灯照菜底的“隐形黑芝麻”(近邻词水印与参数水印盆地)。 大厂发模型前会在采样环节埋入人眼无感的统计暗号(Nature SynthID-Text,2024 年 10 月 23 日)。2026 年 10 月 3 日,浦项工大与华盛顿大学学者进一步提出“平手词微调水印”(arXiv,2026 年 10 月 3 日):平时绝不硬塞生僻词,只在主厨心里两个好词得分几乎打平手时,悄悄偏爱带暗号的那一个,单篇读着毫无痕迹,攒几十道题一算总账立刻显形。更绝的是,Meta FAIR 团队在 2026 年 10 月 27 日发布的《水印盆地》研究(arXiv,2026 年 10 月 27 日)中发现,抄来的水印会在小模型底层参数里砸出一个洗不掉的“凹槽(水印盆地)”——哪怕偷师者给模型做量化压缩、剪枝减肥,甚至再跑一轮强化学习试图洗白,在误报率严控在 0.1% 的铁尺下,这套纯黑盒检测法依然揪出了 79% 的蒸馏模型,而旧式数词频的办法只能抓到 29%(三把侦探放大镜见下图)。
表面词句能洗稿,骨子里的做菜起手式洗不掉。
抄近道的窗关上了,普通公司怎么“体面用蒸馏”省真金白银?
看懂了这套后厨防伪战,接下来整个大模型牌桌的走向其实已经板上钉钉。
靠几万个脚本账号去海外闭源接口套取思考草稿、花小钱刷高榜的弯道超车窗口,到 2026 年底基本已经焊死。往后头部阵营拼的是硬桥硬马的真本事:看谁搭得起成千上万个真实代码沙箱与数学验证器,让模型在强化学习里自己试错长本事;而闭源巨兽与开源模型也会彻底各司其职——万亿参数的闭源主厨负责攻坚最复杂的跨学科难题,百亿参数以内的开源“专精小厨师”则扎进企业本地机房,干好响应快、成本低、数据不出门的实在活。
这也给所有正在选型采购的企业提了个醒:评估大模型别再光盯着静态跑分榜上多三分少五分,更别轻信来路不明的廉价第三方“中转拼单接口”。 一旦上游大厂顺着账号网络拉闸封号或触发反蒸馏噪声,架在上面的企业客服与代码助手一夜之间就会断粮报错。真正该算的账,是“做成一件合格业务的平均总花费”——把单次调用电费、一次做对不返工的成功率,以及合规不断供的安全账全算进去。当然,如果只是三五个人的创业小团队做早期非敏感产品原型验证,没必要一上来自己买卡折腾蒸馏,直接按量调用正规大厂的官方轻量级接口反而最省心。
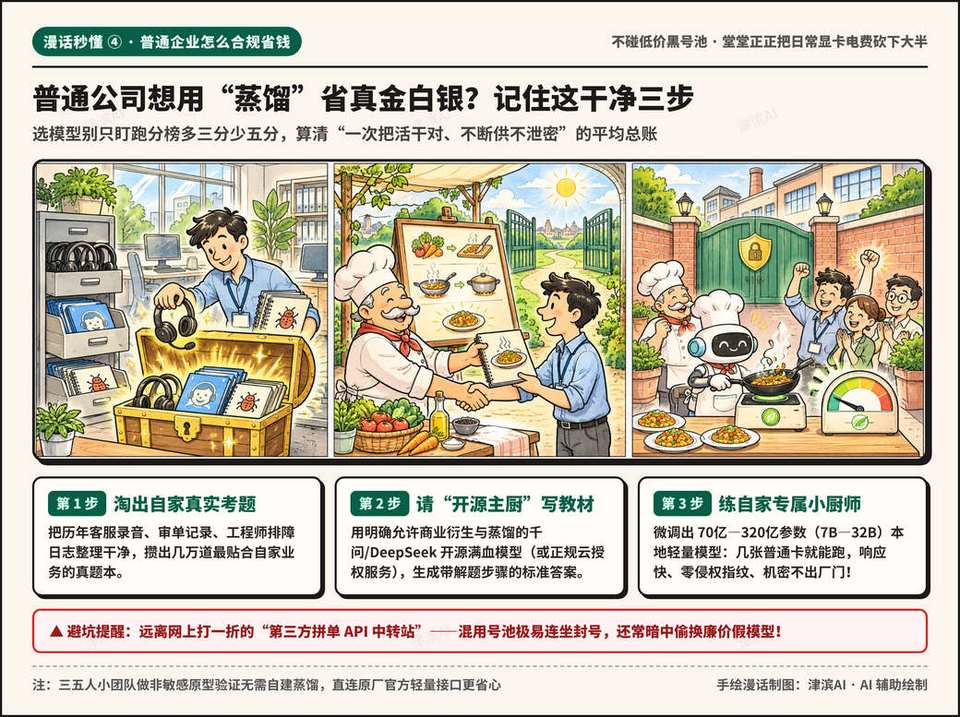
对于有长期高频调用需求、手里又攥着敏感业务数据的正规企业来说,合法合规用好“蒸馏”恰恰是最划算的降本利器,正确打开方式只有干净的三步:第一,去自家客服录音、历史审单记录和工程师排障日志里,清洗出几万条真实业务考题;第二,请允许商业衍生与蒸馏的开源满血大模型(例如遵循宽松开源协议发布的千问开源旗舰或 DeepSeek 开源底座),或者购买云厂商明确授权可做模型微调的企业级服务当“合规主厨”,生成带完整解题步骤的标准教材;第三,拿这份干净教材去微调一个 70 亿到 320 亿参数(7B—32B)的自家专属小模型。不偷不抢、没有外部脏指纹,既把日常显卡开销砍下大半,又能把自家的独门业务手艺稳稳留在自己锅里。
知识延伸:普通用户遇到“第三方超低价 API 中转站”,怎么一眼识别风险?
不少个人开发者和小微团队图便宜,常去买网上打三折甚至一折的“聚合 API 中转卡”。从反蒸馏风控机制看,这类非官方号池正是大厂每周封禁数万账号的头号重灾区(OpenAI,2026 年 11 月 20 日)。它们往往把成百上千个买来的个人号混在一个池子里轮询转发,只要池子里混进一个批量抓数据的“偷师客”,整批关联账号就会被连坐封杀。
更隐蔽的坑在于“货不对板”:部分黑心中转站会在后台把你付费请求的昂贵旗舰模型,偷偷路由替换成蒸馏出来的廉价高仿小模型赚差价。遇到写常规周报看不出破绽,一碰到跨文件改代码或严谨财务核对就频频埋雷。生产环境务必直连国内外模型原厂或正规云大厂的官方企业通道,省下的那点差价,远不够赔一次线上业务翻车。
说明:本文由 津滨AI 编辑部参考科技科普创作者「野菜人」关于“后厨菜谱防伪战”的通俗比喻视角,借助 AI 辅助检索公开学术论文与官方安全报告并完成初稿整理,经人工逐条核对 OpenAI 官方报告、Hinton 与 DeepSeek 原始论文、反蒸馏采样及 2026 年 10 月最新模型指纹与水印盆地论文数据后审校定稿;文内概念题图与四幅知识连环画插图由 AI 辅助生成并经人工编排核实(非实拍)。本文仅作人工智能技术科普与企业合规选型参考。
参考资料
- OpenAI (2026-11-20):Combatting adversarial distillation
- OpenAI (2026):Usage Policies
- Geoffrey Hinton, Oriol Vinyals, Jeff Dean (2015-03-09):Distilling the Knowledge in a Neural Network (arXiv:1503.02531)
- DeepSeek-AI (2025-01-22):DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (arXiv:2501.12948)
- Yash Savani, Avi Schwarzschild, J. Zico Kolter et al. (2025-10-26):Antidistillation Sampling (arXiv:2504.13146)
- Google DeepMind / Nature (2024-10-23):Scalable watermarking for identifying large language model outputs
- Jeongyeon Hwang, Anshul Nasery, Sewoong Oh, Jungseul Ok (2026-10-03):Language Model Fingerprinting Requires Rethinking Watermark Teachers (arXiv:2610.04169)
- Hongyan Chang, Hady Elsahar, Pierre Fernandez et al., Meta FAIR (2026-10-27):Watermark Basins: Black-Box Detection of Distilled LLMs (arXiv:2610.37266)
- Anthropic (2026):Distillation defenses
