做过实时语音助手或数字人客服落地的研发团队,大多在联调桌上吃过同一个哑巴亏:大语言模型和流式语音合成早就把首字出声压进几百毫秒了,偏偏一接上逼真的扩散模型数字人,用户刚问完话,屏幕里的脸就得先僵住好几秒才能动嘴。
2026 年 11 月 20 日,由 Iliad 集团、达飞集团与施密特科学基金会资助的法国开放科学实验室 Kyutai 联合索邦大学等机构,正式发表入选英国机器视觉会议(BMVC 2026)的实时流式数字人模型 AURA(Audio-Driven Streaming Avatar),同步公开了双规格模型权重、推理代码以及 30,000 条带预计算教师轨迹的合成视频数据集(Kyutai 官方博客,2026 年 11 月 20 日;BMVC 2026 论文 arXiv:2611.26540)。在单张 H100 GPU 上,轻量版 AURA 1.3B 能以 20.7 FPS 的吞吐率零前瞻流式生成 576p 视频,配合自家语音系统 Unmute 后,端到端交互延迟被硬生生压到了约 1.2 秒。
不等整句话说完就张嘴,两阶段蒸馏怎么砍掉92%去噪步数?
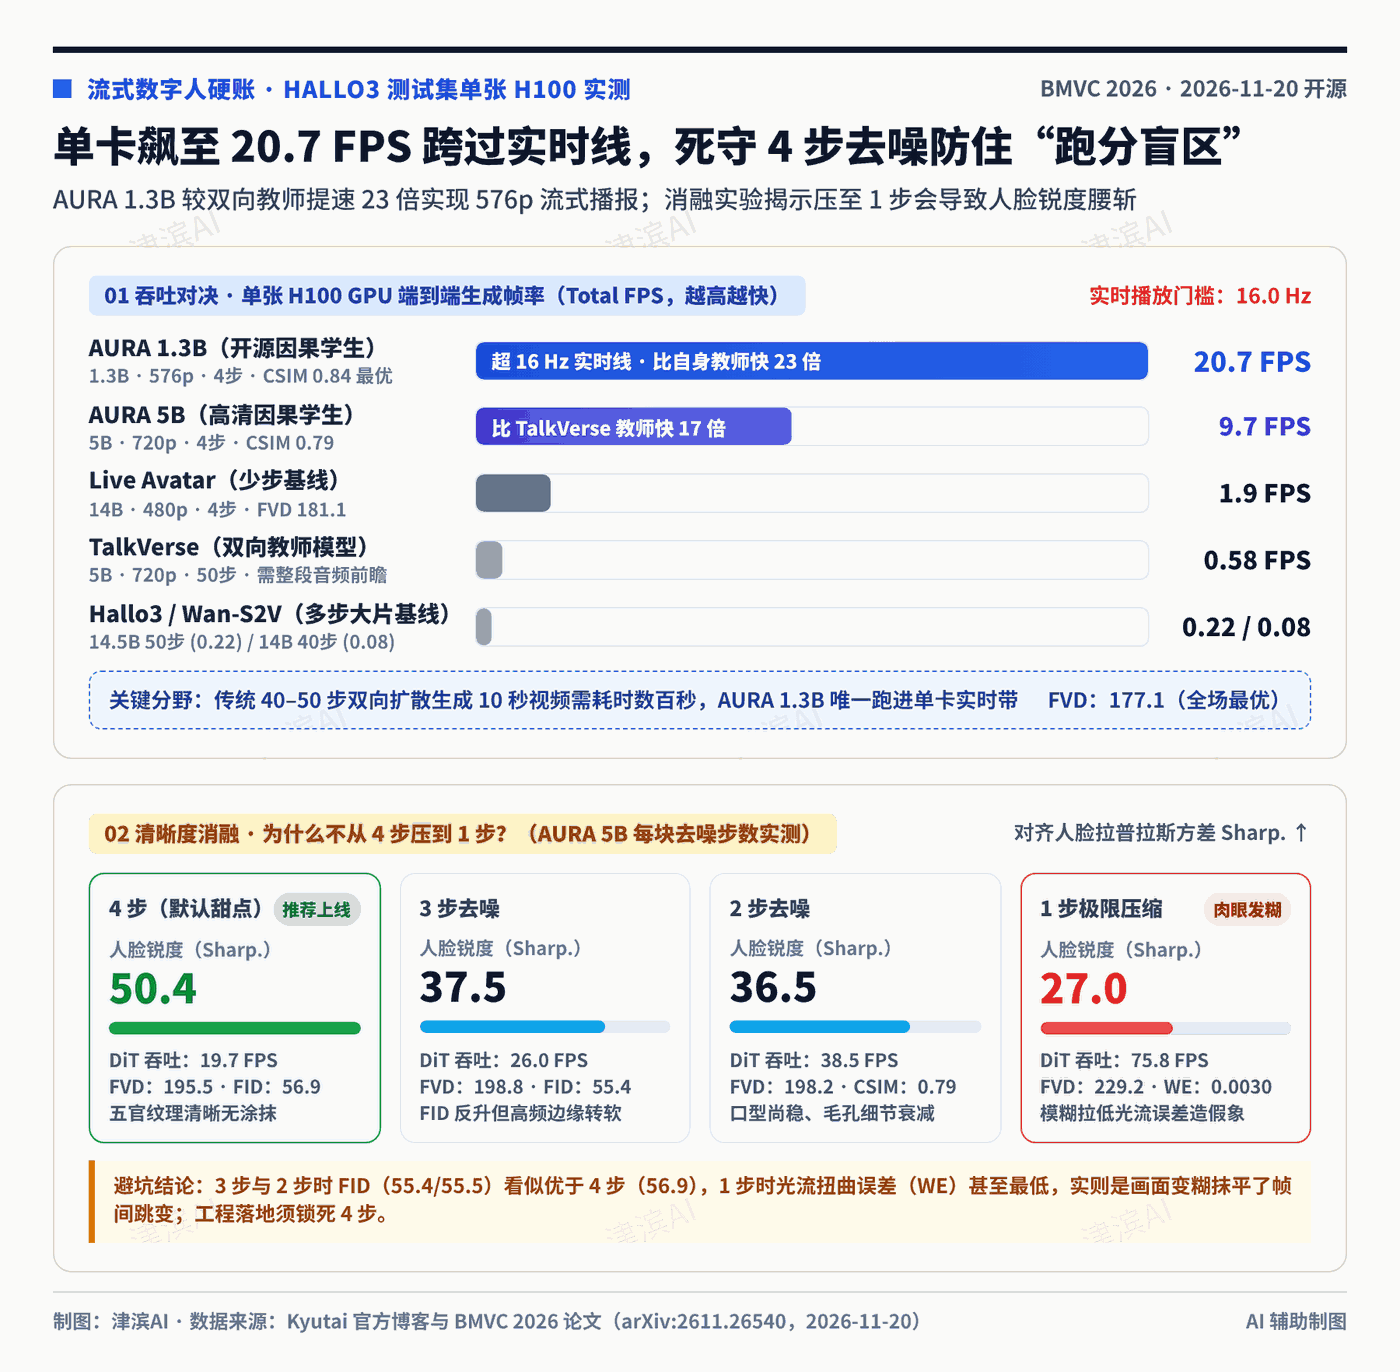
为什么前两年的音频驱动扩散模型做得很逼真,却几乎没法直接搬进实时电话亭?卡脖子的地方在“双向注意力”和“音频前瞻”上。像 Hallo3、Wan-S2V 或 TalkVerse 这类传统模型,工作方式好比挑剔的电影剪辑师:必须等配音演员把整段好几秒的台词全部念完,拿到完整音频切片后,再把前后画面揉在一起来回精修四五十遍。放到单张 H100 上实测,14B 参数的 Wan-S2V 端到端每秒只能挤出 0.08 帧,Hallo3 也只有 0.22 FPS,做离线短视频配音尚可,放到实时对话里根本接不上话茬(Kyutai,2026 年 11 月 20 日)。
Kyutai 的解法很干脆:把需要 50 步去噪的双向教师模型,通过两阶段蒸馏压缩成只需 4 步的分块因果学生模型,实现彻底的零未来音频前瞻(No audio look-ahead)——只要当前这一小块的语音刚落音,显卡立刻出画面,绝不等下一秒的尾音。
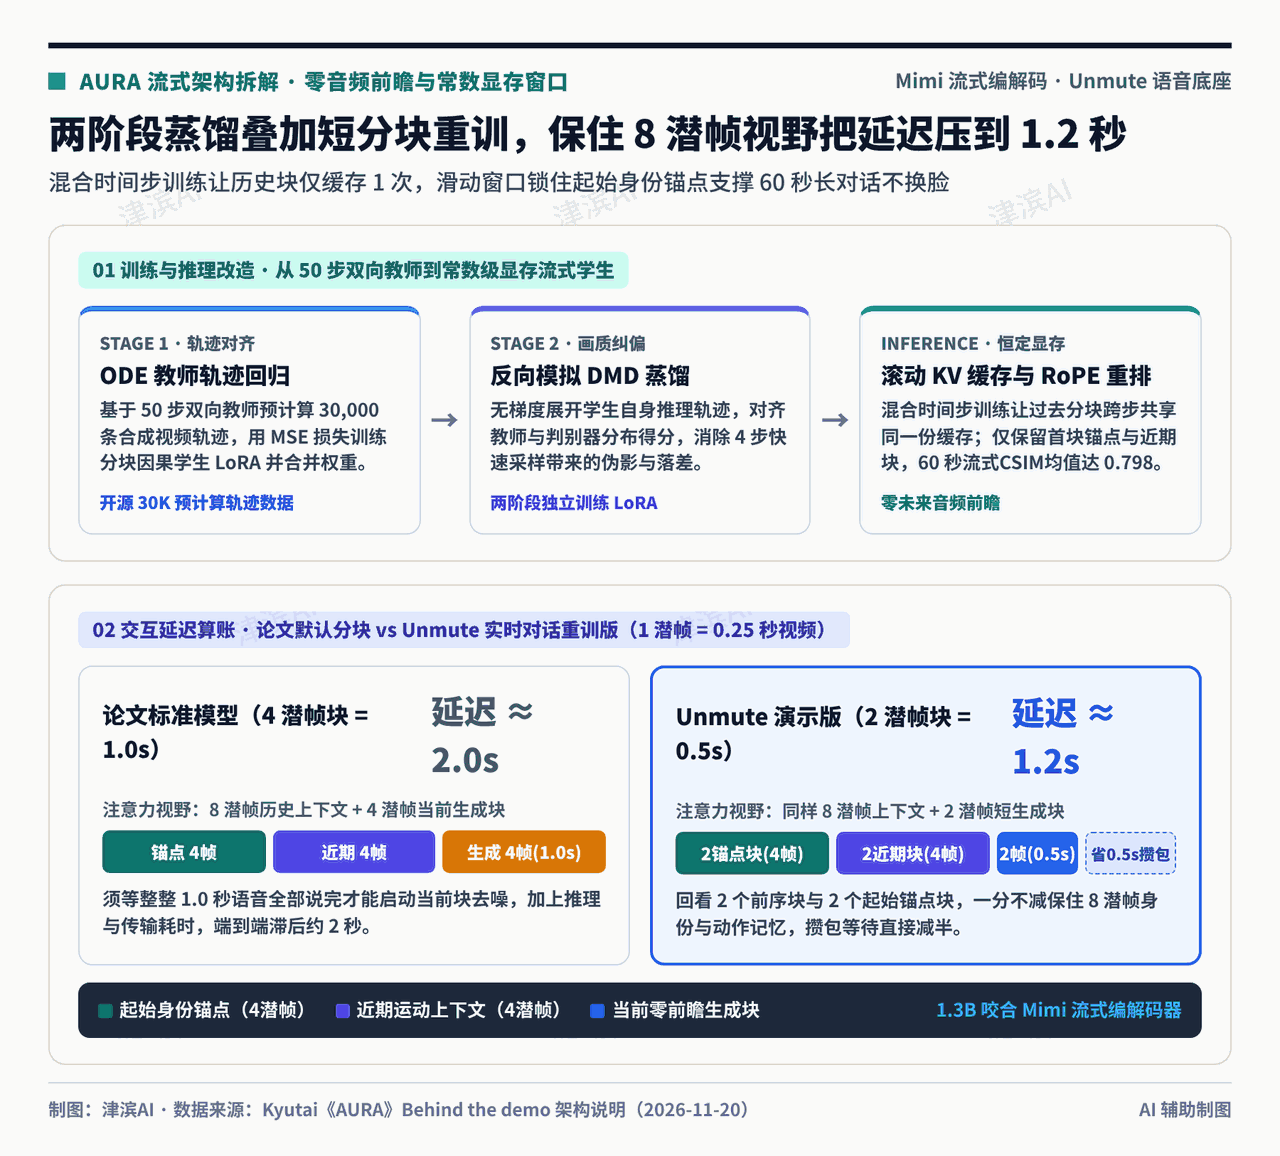
我们在往期拆解《偷抄菜谱逃不过后厨指纹,一文读懂大模型“蒸馏与反蒸馏”》时曾辨析过模型蒸馏的合规边界:不同于跨厂商黑盒套取外部接口输出,AURA 展示的是教科书级的自家白盒步数蒸馏(Hugging Face Kyutai AURA 合集)。研究团队先用冻结的 50 步教师跑出 30,000 条合成视频的完整常微分方程(ODE)去噪轨迹,第一阶段用均方误差损失训练低秩适配器(LoRA)让学生顺着老师的步伐走;合并第一阶段权重后,第二阶段引入带反向模拟的分布匹配蒸馏(DMD),让学生模型在自己真实无梯度展开的推理状态上对齐教师与判别器分数,抹平少步采样的画质折损。
这套管线最终交付了丰俭由人的两档开源权重:AURA 1.3B 抛弃了常见的离线 Wav2Vec2 语音特征,直接咬合 Kyutai 自研流式音频编解码器 Mimi 在 Wan2.1 1.3B 底座上训出教师再蒸馏,单张 H100 跑出 20.7 FPS,比自身双向教师快 23 倍,稳稳跨过 16 Hz 实时播放门槛;主打高清的 AURA 5B 从 TalkVerse 蒸馏而来,以 9.7 FPS 流式输出 720p 画面,速度达到教师的 17 倍(纯扩散主干提速 30 倍)。正如我们在《腾讯混元Hy4开放7700亿参数MoE权重,企业私有部署怎么算账》与《可灵4.0写2000字、BWM-Forge编世界:AI进工位》中所算过的硬账,模型走进生产工位拼的永远是单卡吞吐与显存开销——AURA 通过混合时间步训练让每个历史视频块只需写入一次 KV 缓存,配合重排旋转位置编码(RoPE),哪怕对话拖长到一整小时,显存占用也纹丝不动。
从2秒再挤出0.8秒,短分块怎么保住长对话不换脸?
搞过音视频流媒体的同行心里都清楚,生成帧率跑赢播放帧率(20.7 FPS 大于 16 Hz)只是拿到入场券,真正卡住体感的是端到端首包延迟。因为分块因果模型必须攒齐当前分块的全部语音才能动手算图,数字人嘴型落后于声音的时间,至少等于“一个分块的音频时长 + 单块生成耗时”。
在 BMVC 2026 论文的标准设定里,每个生成块包含 4 个潜帧(对应 16 fps 下的 1 秒视频),接进流式链路后总交互延迟大约在 2 秒左右(Kyutai,2026 年 11 月 20 日)。两秒钟在电话客服里是什么概念?用户说完一句“帮我查下账单”,对面数字人得先微笑发呆两秒才张嘴,急性子用户往往以为麦克风没收上音,已经开始喂喂喂地抢话了。
为了给自家实时语音对话系统 Unmute 配上一张跟得上语速的脸,Kyutai 工程团队在演示版里做了一次非常精巧的手术:把 AURA 1.3B 的单次生成块从 4 个潜帧直接砍半到 2 个潜帧(0.5 秒视频),重新跑完两阶段蒸馏,一举把端到端交互延迟压到了约 1.2 秒,同时依然在单张 H100 上保持实时流式输出。
把每次生成的画面切小一半省下等语音的时间,同时把往回看的历史块数量翻倍,既赚到了 1.2 秒低延迟,又一帧没丢掉上下文记忆。
很多工程师会担心:分块切得这么碎,模型会不会像患了健忘症一样动作抽搐、聊着聊着换了张脸?Kyutai 的办法是“切小生成块,锁死总视野”。演示版每次虽然只生成 2 个潜帧,但注意力窗口会同时回看前 2 个近期块(共 4 个潜帧,维持眨眼点头连贯)与开场最前面的 2 个起始锚点块(共 4 个潜帧,死死钉住人物五官长相),加起来依然是完整的 8 个潜帧上下文,跟论文标准版看到的信息量分毫不差。在 HALLO3 测试集连续 60 秒长流式压测中,AURA 1.3B 在六个连续 10 秒切片上的视频质量(FVD 均值 181.3)与身份相似度(CSIM 均值 0.798,单视频中位漂移仅 -0.02)全程平稳(arXiv:2611.26540)。
跑分好看肉眼却发糊,为什么消融实验劝你守住4步底线?
拿到开源代码后,一线优化工程师最自然的冲动肯定是继续往下拧毛巾:既然 4 步去噪能跑 20.7 FPS,要是再砍到 2 步甚至 1 步,岂不是普通中端显卡也能轻松跑满?Kyutai 在消融实验里晒出的一组对比数据,给这种盲目压步数的做法敲响了警钟(Kyutai,2026 年 11 月 20 日)。
团队在 AURA 5B 上把每块去噪步数从 4 步逐级压到 1 步,扩散主干(DiT)帧率确实从 19.7 FPS 一路飙到了惊人的 75.8 FPS。诡异的一幕出现在自动评测指标上:当步数降到 3 步和 2 步时,常用来衡量画质的 FID 指标(55.4 与 55.5)居然比 4 步默认版(56.9)还要漂亮,连衡量帧间稳定性的光流扭曲误差(WE)也在 1 步时刷出了全场最低值 0.0030。如果只看跑分大表汇报工作,1 步和 2 步简直是性价比神作。
可一旦点开真实视频,人脸肉眼可见地变糊了。为了撕开这层跑分假象,研究团队专门加测了对齐人脸区域的拉普拉斯方差(Sharp.)来量化真实清晰度:4 步时锐度高达 50.4,降到 3 步直接跌去四分之一至 37.5,2 步为 36.5,压到 1 步时更是断崖跌至 27.0。同样在 Mabyduck 平台由 27 名评审员完成的 400 组匿名双盲对比中,自动跑分占优的 Hallo3 因为嘴部动作夸张和手部残影在四项主观评分中垫底,而 4 步 AURA 5B 在人物还原度上反而赢过了慢它 17 倍的 50 步教师模型。
把这些实测底牌摊在桌面上,给国内做语音数字人团队的选型账就非常清楚了:如果是做实时智能客服、外语口语陪练或交互式导览屏,直接拿 AURA 1.3B 搭配 Mimi 流式音频编解码器,采用 4 步去噪与 2 潜帧(0.5 秒)分块方案,单张 H100 就能跑通 1.2 秒级低延迟对话;如果是做 720p 知识播报、电商讲解切片等允许几秒缓冲的准实时场景,选 AURA 5B 画质更扎实;至于团队内部做二次蒸馏与量化验收,切记把拉普拉斯人脸锐度和真人盲测塞进上线门禁,别被虚高的 FID 跑分骗过了眼睛(GitHub kyutai-labs/aura)。
知识延伸:为什么传统 FVD/FID 跑分抓不住少步数扩散模型的“变糊陷阱”?
很多刚接触视频生成的工程师会纳闷:FID(弗雷歇入门距离)和 FVD(弗雷歇视频距离)明明是顶会论文必测的黄金指标,怎么连人脸糊了一半都报警不出来?
原因出在这类指标“看整体轮廓、轻局部纹理”的测量方式上。FID 和 FVD 会先把图片或视频喂进一个预训练分类网络,提取高层语义特征再算两组数据的统计分布距离——好比站在十米开外眯着眼看两拨人的高矮胖瘦和穿衣配色像不像,却根本没凑近看衣服上的针脚清不清楚。当扩散模型步数被压得太少时,模型为了减少误差,最省力的偷懒办法就是输出一张“五官位置全对、但皮肤毛孔和发丝被磨皮抹平”的平均脸。更隐蔽的是,糊成一片的画面没有锐利的边缘线条,前后两帧做像素对齐时反而显得异常“平滑”,顺手把光流扭曲误差也骗出了高分。在质检脚本里加一行计算边缘梯度的拉普拉斯方差,就像给相机装上对焦峰值检测,几毫秒就能把“跑分好看却像隔了层塑料膜”的糊片当场拦下来。
说明:本文由 津滨AI 借助 AI 辅助检索与起草,所有核心数字与事实均经公开一手信源核对;文中概念题图与插画系 AI 辅助生成示意,非现场实拍。
参考资料
- Nathaniel Cohen, Nicolas Dufour, Amélie Royer, Alasdair Newson, Patrick Pérez — Kyutai (2026-11-20):AURA: Audio-Driven Streaming Avatars in Real Time
- BMVC 2026 论文预印本 (arXiv:2611.26540):AURA: Audio-Driven Streaming Avatar
- Kyutai 开源模型权重、代码与 30K 合成视频轨迹数据集:Hugging Face Collection: kyutai/aura & GitHub: kyutai-labs/aura
