用 AI 写代码上线快了五倍十倍,研发团队最先崩掉的是哪一环?答案往往出在监控大屏上:新功能发版猛如虎,线上接口隔三差五变卡变慢,高薪请来的资深工程师没空琢磨核心架构,整天困在报警群和 AI 对话框之间当“复制粘贴传话筒”。
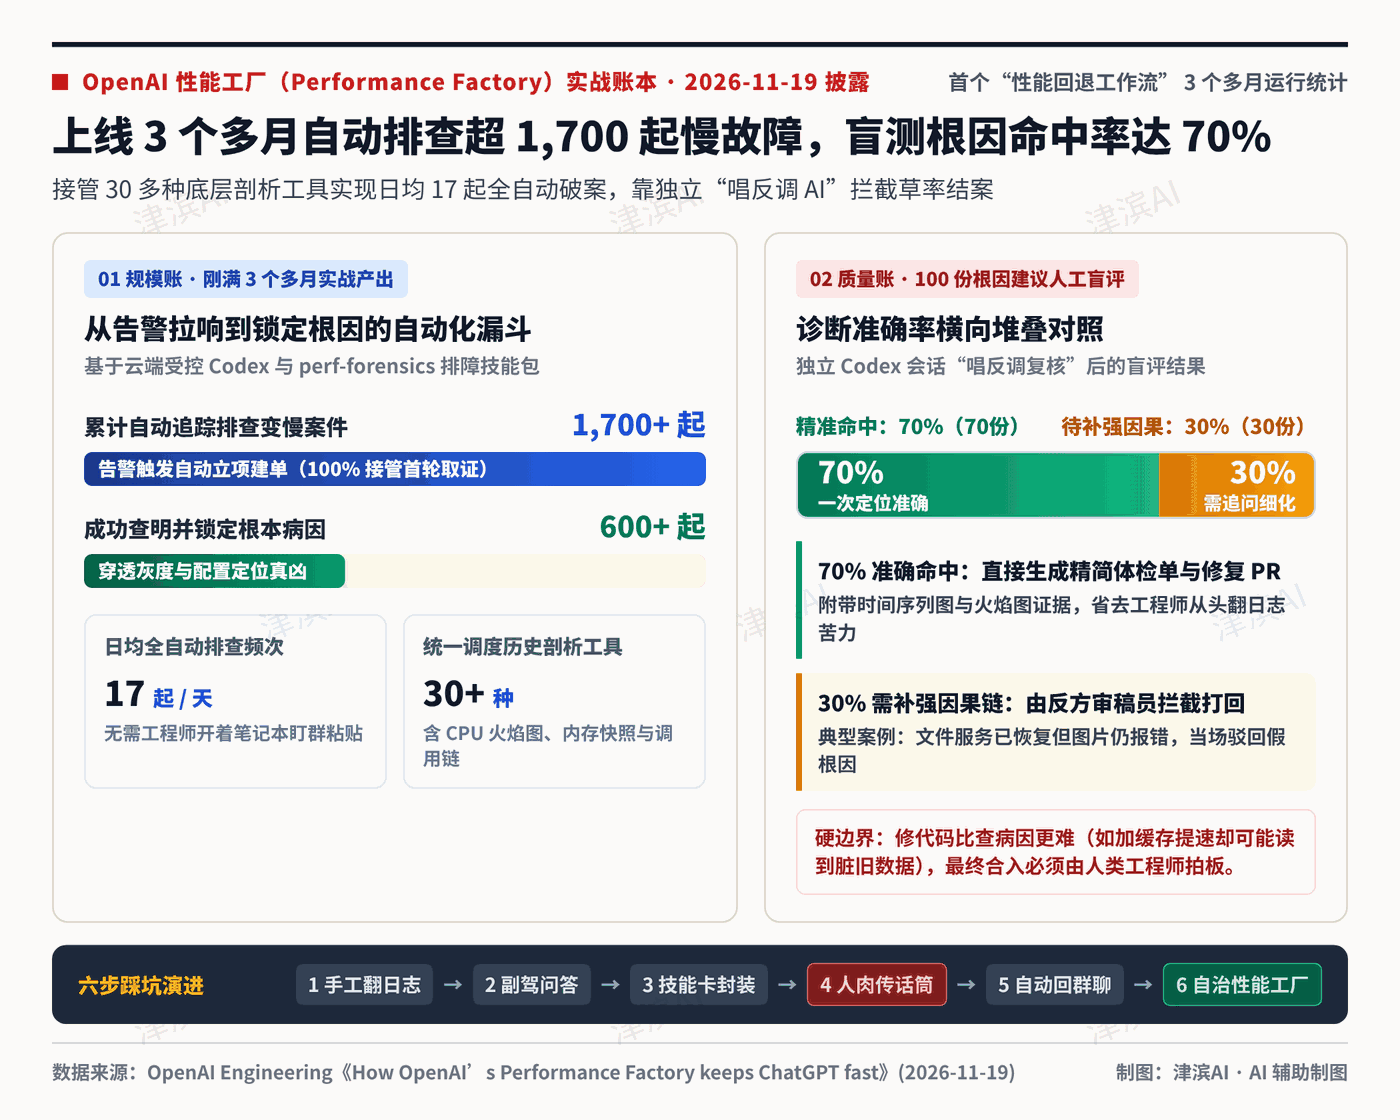
2026 年 11 月 19 日,OpenAI 技术团队成员 Okay Zed 与 Cyrus Forbes 发表官方工程复盘(致谢名单中包含性能火焰图发明人 Brendan Gregg),首次晒出了内部云端自治系统 Performance Factory(性能工厂) 的实战账本(OpenAI,2026 年 11 月 19 日)。上线刚满 3 个多月,这套系统里跑通的第一个“性能回退工作流”,已经自动追踪排查了超过 1,700 起 变慢告警,锁定超过 600 起 根本病因,折合每天自动办案 17 起。
写代码快了十倍,工程师怎么反倒沦为“人肉传话筒”?
很多团队以为,有了编程大模型,线上排障也就是顺手问两句的事。OpenAI 工程团队把自家走过的弯路一五一十摊开,恰好是一部六步进阶的真实踩坑史(OpenAI,2026 年 11 月 19 日)。
最早在纯手工救火阶段,想搞懂 ChatGPT 的“首字响应延迟”为什么突然变慢,全靠熟悉底层的老专家手工翻指标、比对调用链、上机器抓剖析数据。日积月累下来,光内部性能剖析工具就攒了 30 多种,新来的工程师连哪把锤子敲哪颗钉子都认不全。后来团队把 Codex 当成排障副驾,再把老专家的三板斧打包成一份名叫 perf-forensics 的可复用技能卡:先找准变慢的确切时间起点,再圈出受波及的请求人群,最后核对发版与配置开关。经过历史故障回测打磨后,丢过去一条告警就能一次跑出诊断结论。
怪事偏偏就出在这第三步之后。
技能卡越好用,工程师越觉得自己像个没有感情的“人肉传话筒(human proxy)”。监控群里告警一响,人把报错复制粘贴进挂好技能卡的 Codex,等吐出分析报告,再原封不动粘贴回 Slack 群里。查案的脑力活是省了,人却被拴死在了剪贴板上。哪怕后来他们把这套排查搬上云端自动回帖,自动化到群聊回复那一刻也就断了线。随着每天告警越积越多,谁去改代码、改完发版灵不灵,还得靠工程师去乱麻一样的群聊消息串里海底捞针。
为了彻底拔掉这根刺,OpenAI 搭起四件套底座,把零散问答改造成了端到端的“性能工厂”(OpenAI,2026 年 11 月 19 日):
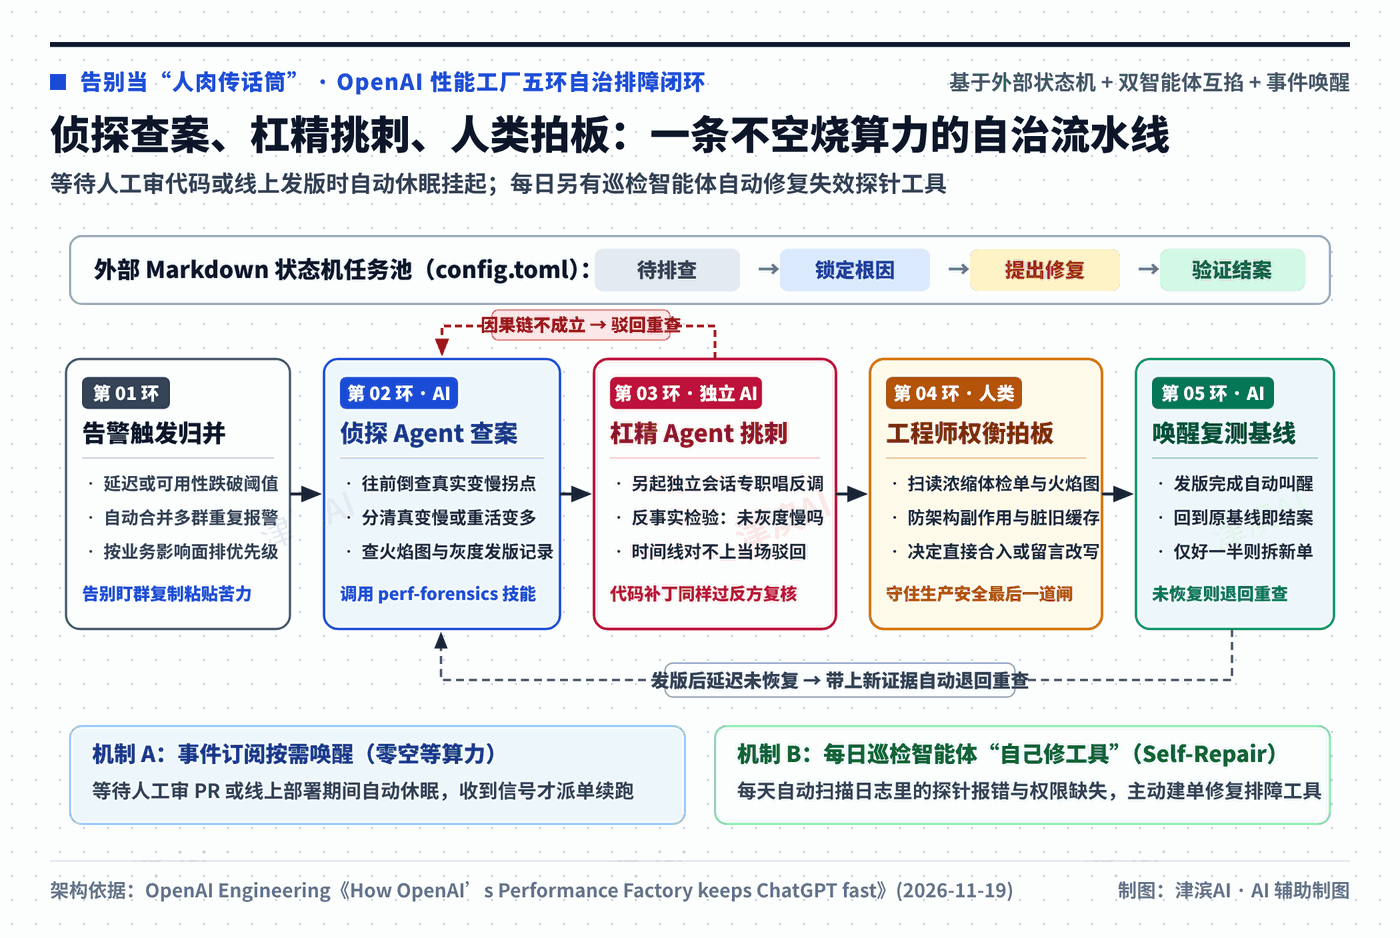
- 外部状态机任务本:用配置文件和分阶段 Markdown 指令单(涵盖待排查、锁定根因、提出修复、已解决四个阶段),把进展和证据存在单个智能体脑子外面,换谁接棒都不丢上下文,还能把同一起故障炸出的多条重复告警自动归并排座次,不拿满屏文字墙轰炸工程师。
- 定时派单调度器:轮询检查哪些任务准备就绪,按当前阶段的说明书派智能体上场。
- 带受控工牌的云端执行舱:智能体用独立服务身份在内网云端跑任务,能像真人工程师一样调阅代码库、CPU 火焰图和内存快照,权限边界一清二楚,也不用指望哪位工程师的笔记本电脑一直开着盖。
- 按需叫醒的事件订阅:碰到要等人类审代码或者等线上发版完成的空档,智能体绝不在后台空烧算力干等,先挂起休眠,等 GitHub 评审留言或发版完成信号一到,再自动唤醒接着干。
专派“杠精AI”挑刺翻案,70%命中率背后藏着什么猫腻?
把流程串起来只是体力活,真正决定这套系统敢不敢上生产环境的,是诊断准不准。
排查线上变慢最容易踩两个坑。第一个坑是时间差:监控阈值报警那一刻,真正的劣化往往早在几小时前就埋下了,排障智能体得先顺着历史曲线倒查真正的拐点,分清到底是“同类老请求真变慢了”,还是“原本就费时的重活请求占比变多了”。第二个坑更要命,早期的智能体跟急着下班的新手一样,看到第一个勉强说得通的借口就草率结案(OpenAI,2026 年 11 月 19 日)。
怎么治这个偷懒病?OpenAI 使出了一招极聪明的“唱反调红队复核(Adversarial Review)”。
每当排障智能体交出一份病因报告,系统不会直接采信,立即拉起第二个完全独立的 Codex 会话。这位审稿员的唯一职责就是挑刺拆台,用反事实追问去推翻前一个智能体的结论:如果真是那次灰度发版惹的祸,没被灰度覆盖的同类请求一直健康吗?把可疑改动回滚之后,变慢的曲线真掉回去了吗?
这招在实战里真抓到过漂亮的现行。在一次 ChatGPT 对话异常排查中,打头阵的智能体顺藤摸瓜查到图片下载报错,一把将黑锅扣在“内部文件定位服务故障”头上,顺手就想标结案。负责唱反调的第二个 Codex 审稿员一拉时间轴,当场揪出破绽:那个文件定位服务老早就恢复正常了,可用户的图片请求依然在报错!前面的理由根本圆不上后半截故障,审稿智能体直接打回重查,并把还缺哪几环证据清楚记在任务单上(OpenAI,2026 年 11 月 19 日)。
让一个 AI 当侦探找线索,再派另一个独立 AI 当反方辩手砸场子,比单靠一个大模型闷头苦想靠谱得多。
即便加上了双智能体互掐制衡,OpenAI 晒出的内审底账依然很诚实:在团队人工盲评的 100 份 根因诊断建议里,70% 被判定为精准命中,剩下 30% 仍需人工或后续轮次继续补齐因果链(见图 1 右侧对比)。不吹嘘“百分百全知全能”,把七成常规慢故障稳稳挡在人工介入之前,这笔工时账就已经大赚特赚了。
查病因容易开药方难,普通研发团队该先抄哪一步?
顺着五环流水线往后看,OpenAI 在复盘后半段泼了一盆所有技术主管都该听进去的冷水:把故障修对,比查出病因难得多(OpenAI,2026 年 11 月 19 日)。
通过反方挑刺的病因单,会交由智能体自动写出修复代码并拉起代码合并请求(PR),再附上一份浓缩了指标曲线、CPU 火焰图与改动依据的精简体检单。但在实操中,智能体写的补丁有时会把简单问题绕复杂,甚至按下葫芦浮起瓢。比如接口慢了,智能体顺手加一层内存缓存,延迟数字立马好看了,却可能让线上用户读到过期的脏数据(stale data)。这类牵一发动全身的架构取舍,系统同样先让反方智能体审一遍补丁,最后一步拍板合不合入代码的决定权,依然死死攥在懂业务全局的人类工程师手里。
等人类点下发版,休眠的验证智能体会被自动叫醒去盯恢复情况:延迟彻底回到基线才算结案;要是只恢复了一半,就关掉旧单、给剩下的尾巴另开一张新单追查;要是纹丝未动,立刻打回重查。更有意思的是,性能剖析探针坏了或者少了个读取权限,都会把智能体变成睁眼瞎,因此他们每天还会跑一个巡检智能体专门翻运行日志,揪出坏掉的工具自动建单“自己修工具”,并在每次升级技能前拿抹掉事后答案的历史真实故障做防作弊回测(OpenAI,2026 年 11 月 19 日)。
算完这套账,给国内研发团队的落地判断非常明确:上马 AI 运维千万别一上来就追求“无人值守自动改线上代码”,最划算的切入点,是先砍掉报警群里的“人肉复制粘贴”,再配上一正一反双智能体自动取证,把人类工程师宝贵的注意力全部留给最后五分钟的代码合入拍板。 当然,如果你们维护的只是三五台机器、几周才发一次版的低并发内部管理后台,压根犯不着兴师动众搭整套云端状态机工厂,先把老师傅的排障命令整理成一份标准复用脚本就够用了。
知识延伸:为什么线上变慢告警响起时,“第一案发现场”往往已经在几小时前?
平时大家总觉得,哪一秒改坏了代码,监控警报就该在哪一秒拉响。可在真实的亿级并发互联网服务里,报警器响起的时间几乎永远滞后于真正埋雷的时刻(OpenAI,2026 年 11 月 19 日)。
原因主要出在“灰度放量”与“潮汐掩护”上。现代发版通常先放 1% 或 5% 的小流量试水,如果在凌晨低谷期上线了一段略微拖慢数据库查询的代码,当时机器空闲算力充裕,整体平均响应时间根本碰不到报警红线。等到几个小时后早高峰到来、灰度比例推高到 50%,排队效应突然像堵车一样指数级放大,警报才会凄厉拉响。如果排障人员只盯着报警前十分钟刚上线的无辜代码抓替罪羊,十有八九会冤枉好人。先往前倒推几小时找到指标轻微抬头的真正起点,再核对当时的灰度批次,才是老练排障的第一铁律。
说明:本文由 津滨AI 编辑部借助 AI 辅助检索公开技术文献并完成初稿整理,经人工逐条核对 OpenAI 2026 年 11 月 19 日官方工程博客一手数据、故障案例与架构细节后审校定稿;文内概念题图由 AI 辅助生成(非实拍),统计对比图与五环流水线架构图由 津滨AI 基于公开核实资料自制。本文仅作软件工程与人工智能技术实践参考。
参考资料
- Okay Zed, Cyrus Forbes, OpenAI Engineering (2026-11-19):How OpenAI’s Performance Factory keeps ChatGPT fast
