设计一颗全新处理器,第一件事居然是让 AI 亲手删掉它自己写的 141 页 英文设计说明书。
这一幕发生在硬件初创团队 Architect Labs 于 2026 年 11 月 18 日公开的 Frostbite 项目里(Architect Labs,2026 年 11 月 18 日)。首轮硬件电路代码一跑出来,智能体集群发现自然语言文档里的纸面估算离真实物理极限差得十万八千里,干脆把那份 PDF 直接丢进回收站,转身改用超过 80 万行 Lean 数学形式化证明当唯一铁律,从编译器、全新指令集一路自主画到了 7nm 芯片物理版图,跑出了同工艺传统核心 4.59 倍 的每瓦性能。
仅仅相隔两天,操作系统底座也传来了被算力硬件逼改老规矩的消息:2026 年 11 月 20 日,据科技媒体 Phoronix 报道,Intel 工程师面向计划在下一周期合入的 Linux 7.5 内核提交补丁,把沿用多年的显卡显存虚拟映射地址池上限从 1TB 一口气扩建 8 倍到 8TB(Phoronix,2026 年 11 月 20 日)。一边在指甲盖大小的硅片里推翻共享缓存老规矩,一边在操作系统内核里加印显存“门牌号”,两件硬核大事撞在一起,指向了同一个算力新瓶颈。
拆掉几十个厨师抢的大冰柜,AI怎么靠35年前老数学省下电费?
想看懂 Frostbite 凭什么省电,得先看清过去二十多年传统 CPU 把电费冤枉花在了哪儿。
从 2000 年代初单核提速撞墙开始,无论是服务器里的 Intel Xeon、AMD Zen 还是各类多核处理器,基本都在走同一条路:往一颗芯片里塞进几十上百个核心。问题在于,主流编程语言默认任何一段代码都能随时读写同一块共享内存。这就好比三十个厨师挤在一间大厨房里,围着同一口公用大冰柜抢食材(L1/L2/L3 多级共享缓存)。为了防止两个厨师同时改坏同一盘菜,芯片不得不拿出大半面积和电费去排队等锁、核对缓存一致性账本,还得在运行现场拼命猜“下一刀该切哪根葱”(取指、译码与乱序调度)。
Frostbite 的 AI 智能体集群在没有预设任何传统架构框框的前提下,从故纸堆里翻出了法国学者 Yves Lafont 在 1990 年 提出的冷门计算模型“交互网(Interaction Nets)”(Architect Labs,2026 年 11 月 18 日)。
放到厨房里打比方,交互网干脆把那口抢破头的公用大冰柜拆了,改成每个小工位自带专属小抽屉,每份食材只有一个主人、只用一次,切完直接把纸条递给隔壁工位。程序员用语法接近 Rust 的 Vine 语言写普通逻辑,编译器自动把它转成节点连线图。比如在 5×5 棋盘摆五皇后的经典搜索里,传统 C++ 程序只能一步步挨个试探,交互网不用改写一行并行代码,天生就能摊开 3,183 次 局部交互,关键路径只有 262 步,平均每一步都有约 12 个 互不打架的活可以同时开干。
光有好点子造不出真芯片,大模型写代码最怕“一本正经胡说八道”。Architect Labs 镇住幻觉的办法很硬核:用自研硬件规范语言 ASL 写好包含 31 个 模块契约的系统模型 Arcmodel,全部原生转译成 80 万行以上 的 Lean 4 数学证明代码。另一套自动物理校准流水线盯着真实电路的功耗热点反复纠偏,把最初高达近 250% 的功耗预测偏差死死摁进 1%—5% 的误差带里,全芯片仿真速度却比传统电路级仿真快了 660 倍。智能体集群在并行分支里一口气试了 58 个 架构改版点子,优胜劣汰留下了 37 个(Architect Labs,2026 年 11 月 18 日)。
最让人类工程师意外的一幕,出现在硬件运行时的演化结果里。芯片上压根没有设中心调度员,AI 智能体完全靠自己在性能爬坡中悟出了三条小瓦片(Tile)生存铁律:
先干自己手头端口的活;手头空了就去隔壁忙不过来的邻居队列里顺手接活干;要是左邻右舍都没活,当场关灯打盹省电。
整套“挂起记录、邻居偷活(Work-Stealing)、最后一个任务包回传自动叫醒下一段代码”的精密配合,没有任何一行出自人类的事先指令。
翻开4.59倍能效的底牌,离装进你的服务器还差哪几步?
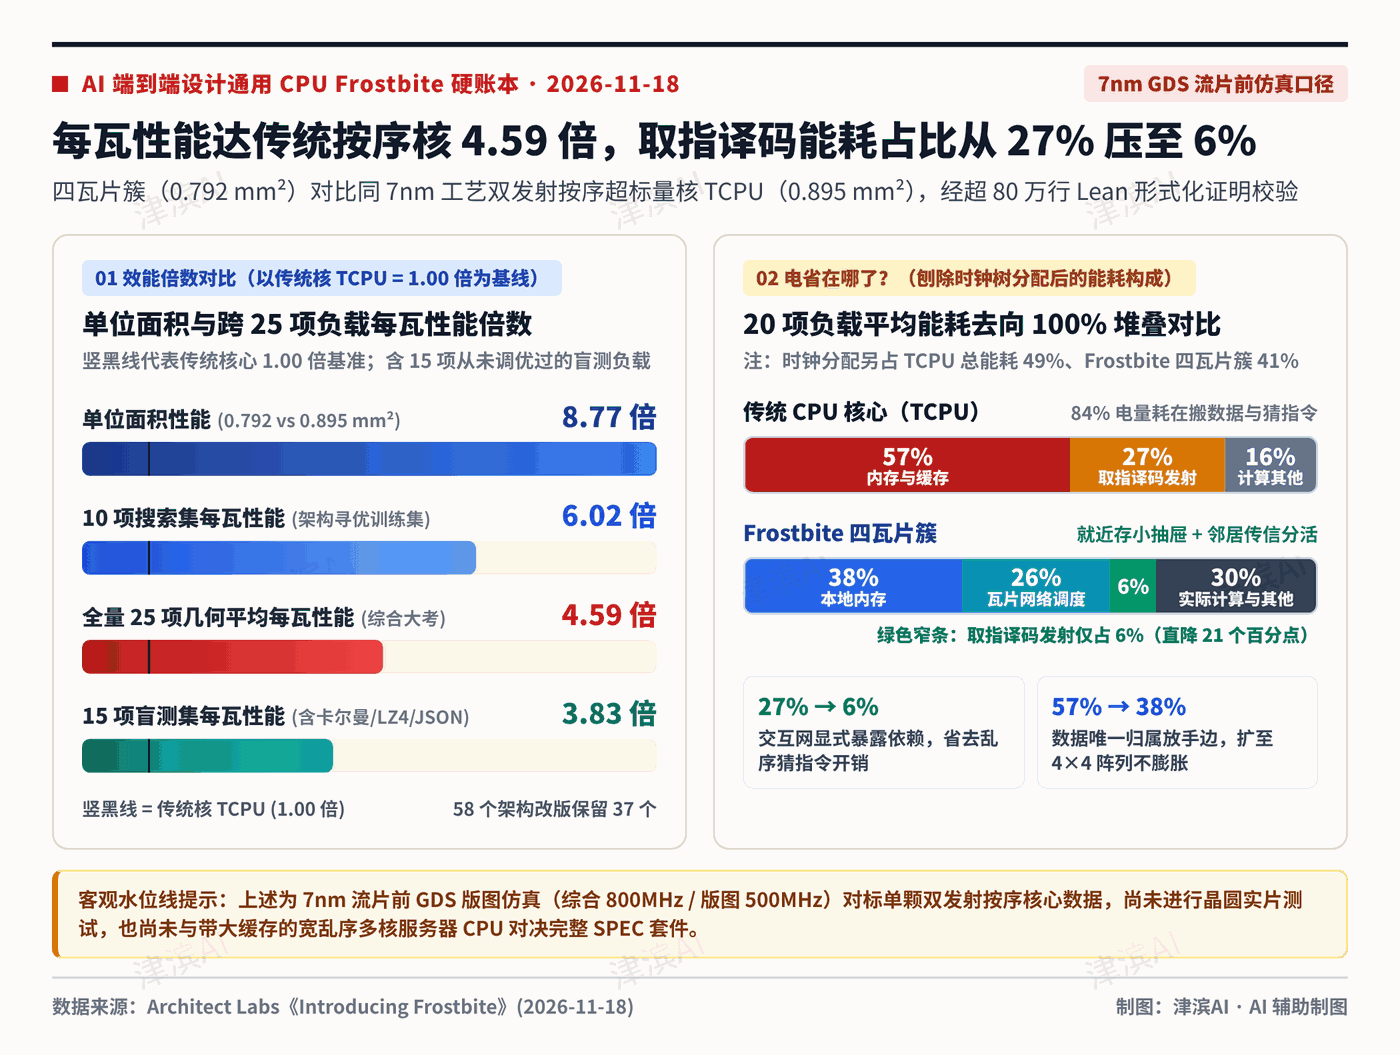
看一眼图 1 的实测硬账本,省电逻辑一目了然。在 7nm 工艺下(综合频率 800MHz,最终物理版图频率 500MHz),一组由 2×2 瓦片组成的 Frostbite 四瓦片簇面积仅 0.792 平方毫米,比拿来做对标的同工艺已流片双发射按序超标量传统核心(TCPU,0.895 平方毫米)还要紧凑(Architect Labs,2026 年 11 月 18 日)。
在涵盖 25 项 基准测试的考卷上(其中 15 项 是直到终考才拆封的盲测集,覆盖卡尔曼滤波、有限元分析、LZ4 解压、JSON 解析等实用负载),Frostbite 跑出了几何平均 4.59 倍 的每瓦性能,盲测集单独算也有 3.83 倍,单位面积性能更是达到 8.77 倍(完整梯度见图 1 左侧)。
电到底是从哪儿省出来的?刨掉时钟树分配能耗后,传统核心把 57% 的电烧在折腾内存缓存、27% 烧在取指译码上。Frostbite 把这两项大头分别砍到了 38% 和区区 6%,腾出 26% 电量给瓦片之间传信分活,就算扩成 4×4 阵列,能耗比例也稳稳当当(Architect Labs,2026 年 11 月 18 日)。
惊艳归惊艳,咱们必须替读者把报告脚注里的三道现实水位线标清楚(Architect Labs,2026 年 11 月 18 日):
- 第一,这是流片前的物理版图(GDS)仿真账,还没拿到晶圆厂烧出来的真硅片。 真正流片回板后的实测功耗,还得等后续投片闭环来验明正身。
- 第二,当前打赢的对手是单颗“双发射按序”小核。 它还没跟数据中心里带超大缓存、宽乱序执行的多核旗舰 CPU 在完整规格的 SPEC 或 PARSEC 工业级套件上掰手腕(探索阶段为加快迭代,连部分经典算子规模也缩小了 64 倍),这场硬仗被团队排在了后续数月。
- 第三,软件搬家门槛不低。 芯片跑的是编译自 Vine 语言的代码,操作系统资源管理与多程序虚拟化还在搭建中。
由此给出的判断很明确:指望这种全新指令集芯片在两三年内取代数据中心里跑着海量 C/C++ 老代码的 x86 或 Arm 通用主机 CPU,显然不切实际;但在视频编解码、网络交换机、专用推理加速卡这类软件栈纯粹、过去人类嫌试错太贵而不敢换底盘的专用芯片赛道,AI 软硬协同重画架构的颠覆力会来得比预想更快。
多张160GB显卡撑爆1TB旧账本,Linux 7.5为什么要扩门牌号?
如果说 Frostbite 是在芯片内部“拆掉共享大冰柜”,那 Linux 内核在 2026 年 11 月的动作,就是被芯片外部暴涨的大显存逼着“扩建门牌号登记簿”。
据 Phoronix 于 2026 年 11 月 20 日披露,Intel Linux 显卡驱动工程师 Matthew Auld 提交的一项改动已通过 drm-misc-next 合入 DRM-Next,面向计划在下一周期发布的 Linux 7.5 内核,把 64 位系统内核图形驱动(GEM/TTM 缓冲区对象)的虚拟地址映射(mmap)偏移池上限,从 1TB 扩大 8 倍至 8TB(Phoronix,2026 年 11 月 20 日)。
为什么好端端用了多少年的 1TB 上限突然不够用了?导火索正是新一代多卡大显存服务器,比如 Intel 自家代号 Crescent Island 的 GPU D 系列加速卡,单张卡就塞进了高达 160GB 的 LPDDR5X 显存。
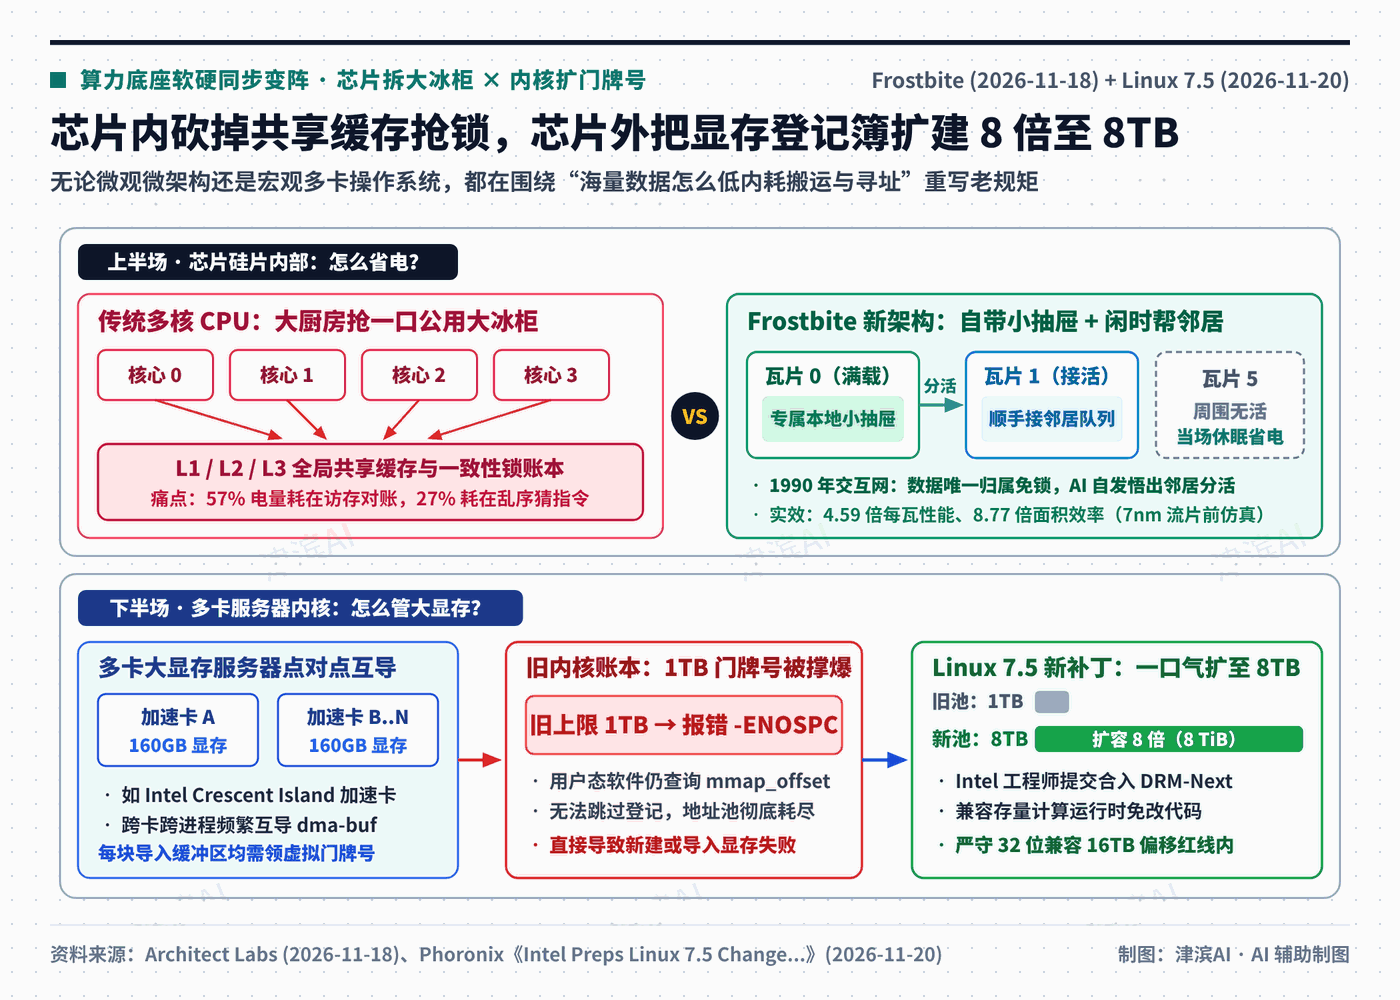
当一台机器插满多张百 GB 级加速卡、跨卡跨进程频繁做点对点显存直连共享(peer-to-peer dma-buf)时,Linux 内核每导入或新建一块显存缓冲区,都得在每张卡的虚拟地址管理簿上领一串“虚拟门牌号”。哪怕上层计算框架直接拿文件句柄传数据,为了兼容像 Intel compute-runtime 这样仍会例行查询门牌号的存量用户态软件,内核也不敢贸然省掉这步登记。结果多张大显存卡成百上千次交叉互导下来,老旧的 1TB 门牌号池直接被领光撑爆,当场抛出 -ENOSPC(空间耗尽)报错把任务卡死!一口气扩到 8TB 后,既给多卡互导留出了八倍周转空间,又严丝合缝卡在 32 位兼容模式 16TB 页偏移红线以内(Phoronix,2026 年 11 月 20 日)。
一边在 0.792 平方毫米的硅片上砍掉五成以上的访存与译码内耗,一边在操作系统底座把显存寻址账本扩到 8TB。算力军备竞赛的胜负手,已经彻底从“晶体管每秒能算多少次乘法”,变成了谁能让海量数据少跑冤枉路、不卡在半道上。
知识延伸:为什么显卡明明插在自己主板上,Linux 内核还要给显存发“虚拟门牌号”?
不少读者会纳闷:160GB 显存焊在显卡上,程序直接按物理地址去读写不就完了,干嘛非要劳烦 Linux 内核发一串“虚拟门牌号(mmap 偏移量)”?
这其实跟大楼前台发访客门禁卡是一个道理。现代服务器里往往同时跑着十几个容器和不同用户的 AI 任务,如果允许普通程序直接拿物理地址去捅显卡显存,任何一个写错指针的程序都能瞬间偷看甚至改坏隔壁任务的模型权重。因此操作系统规定,无论显卡自己的物理显存还是从隔壁显卡借过来的共享缓冲区(dma-buf),都必须先在内核登记簿上领一个受保护的虚拟偏移门牌号,由内核和硬件内存管理单元在底下做安全翻译。当 8 张卡两两互相借用显存时,每张卡不仅要登记自家显存,还要把从另外 7 张卡导入的缓冲区挨个登记一遍,虚拟门牌号的消耗速度自然远超单卡物理容量,这也是 1TB 旧账本在百 GB 显存时代率先告急的原因。
说明:本文由 津滨AI 编辑部借助 AI 辅助检索公开芯片研究报告与 Linux 内核技术报道并完成初稿整理,经人工逐条核对 Architect Labs 2026 年 11 月 18 日技术原文及 Phoronix 2026 年 11 月 20 日内核补丁报道数据后审校定稿;文内概念题图由 AI 辅助生成(非实拍),性能能耗统计图与软硬联动架构图由 津滨AI 基于公开核实资料自制。本文仅作计算机体系结构与系统工程科普参考,不构成任何投资或硬件采购建议。
参考资料
- Architect Labs (2026-11-18):Introducing Frostbite: A new CPU architecture discovered, designed, and verified end-to-end by AI
- Michael Larabel, Phoronix (2026-11-20):Intel Preps Linux 7.5 Change To Better Handle Multiple GPUs With Lots Of VRAM
