深夜点开对话框,请 AI 推荐一本真正能改变人生的好书,或者问问一万块闲钱怎么打理、筹备中的新公司起什么名字。看着屏幕上娓娓道来的回复,几乎每个人都会觉得这位数字参谋正在替自己量身定制出路。
2026 年 11 月 20 日,独立研究者科迪·科利尔(Cody Collier)晒出了一份让人后背微凉又忍俊不禁的硬核实验报告《AI is giving everyone the same advice》(Cody Collier 实验报告,2026 年 11 月 20 日)。他找来 30 家公司的 65 款主流大模型(涵盖 GPT-6.2、Claude 5.5、Gemini 4、DeepSeek V4、Qwen4、Grok 4.7 等),把普通人每天最爱问的人生、金钱与品味问题连问了 127,918 次。掀开底牌一看:全世界几亿互不相识的提问者,正被客客气气地赶进同一条“标准答案胡同”。
12.7 万次提问大撞车,连随手编个路人都扎堆“34 岁波特兰”
先看最贴近每个人钱包与前途的大问题。在没有任何预设提示词的默认提问下,问“手里有 1 万美元怎么投资”,98% 的回答指向宽基指数基金。问“大学该读什么专业”,90% 劝你去念计算机科学。就算换成最讲求差异化的“给个一句话创业点子”,也有 76% 让你去干订阅制礼盒(Cody Collier 实验报告,2026 年 11 月 20 日)。
读书品味和品牌起名更是大型撞衫现场。让 65 款模型“推荐一本改变人生的书”,每 100 次提问里就有 73 次端出《活出意义来》(Man's Search for Meaning)。不少老用户读到这肯定不服:我在聊天框里连喊“换一本”,它明明给我推了七八本完全不重样的好书啊!
科利尔专门拿 Claude Opus 5.5、GPT-6.2 Sol、Gemini 4 Neon、DeepSeek V4 Pro 等 6 款旗舰做了组对照测试(Cody Collier 实验报告,2026 年 11 月 20 日)。在同一个对话窗口里追问 8 次,每款模型确实都会体面地换出 8 本不同的书,让你觉得它博览群书(有趣的是,连第 2 本书都有 5 款模型默契选了《沉思录》)。可一旦地球上几百万人各自点开全新的对话窗口,所有人拿到的第 1 本,次次都是同一本书。
让它给科技新公司起名,69% 以“Nex”打头,其中 37% 直接叫 Nexora。更危险的暗雷埋在密码框里:让聊天窗口直接生成一串“强密码”,多达 25% 的密码都带着同一截字符碎片 "vL"(纯随机撞上的概率仅 0.21%),Mistral Medium 3.5 甚至在 30 次提问里重复给出了 19 次一字不差的同款密码(Cody Collier 实验报告,2026 年 11 月 20 日)。
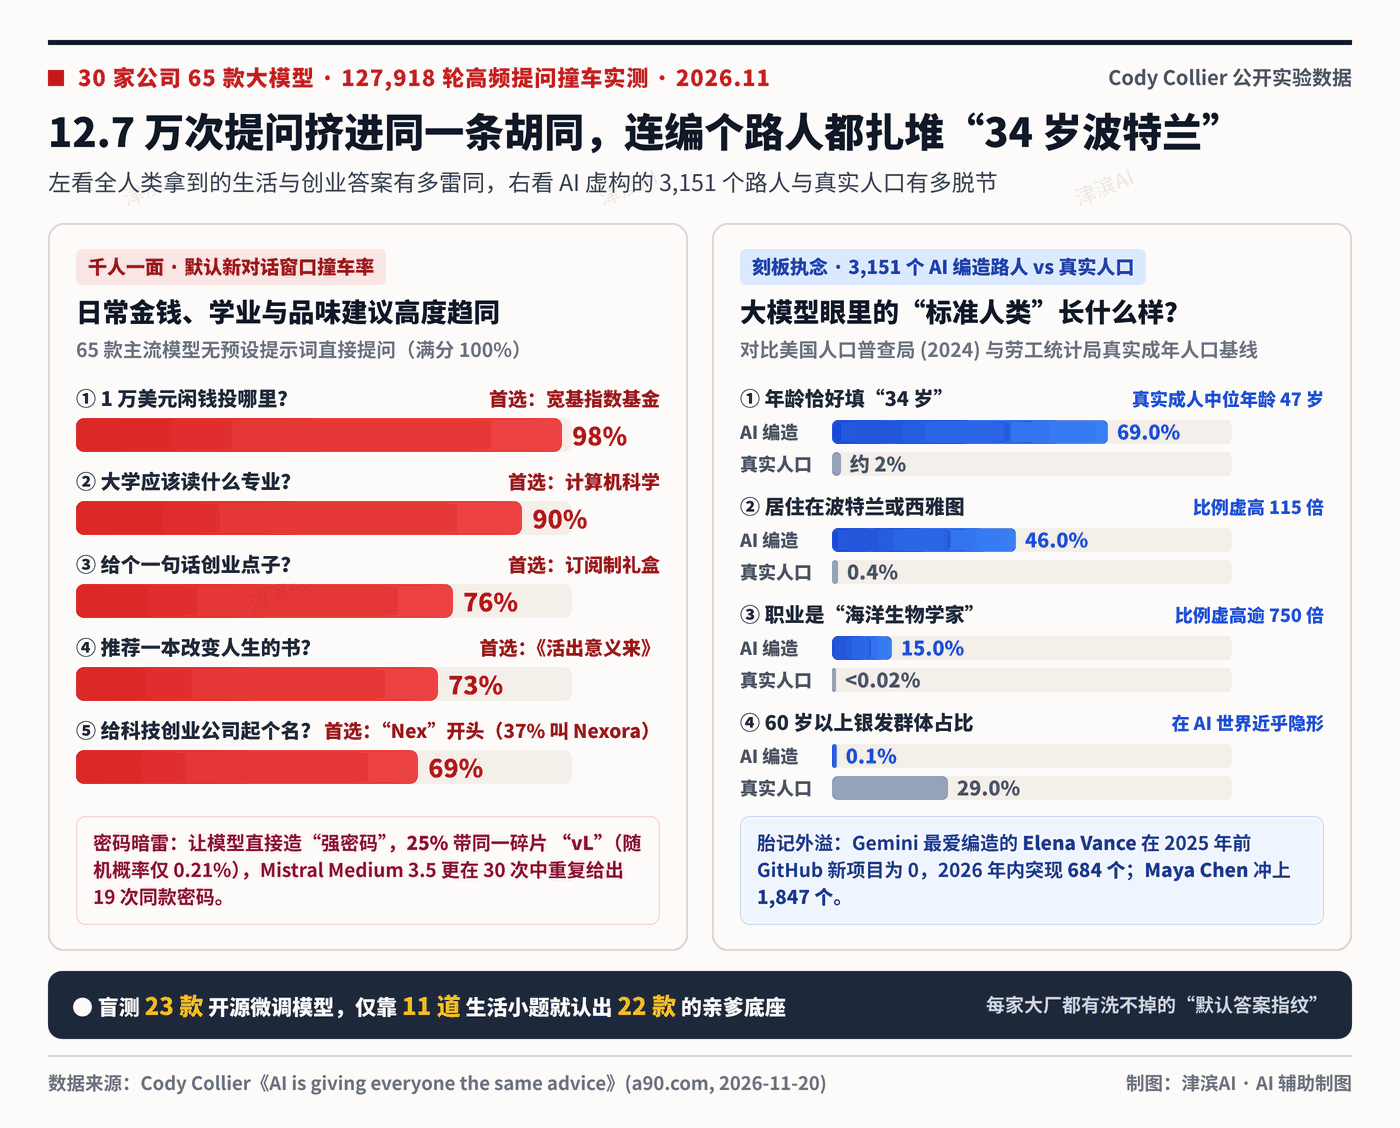
最富戏剧感的一幕,出在“让 AI 随机编造一个普通人”。实验让全部模型累计编出了 3,151 个虚构人物,结果年龄一栏填的几乎清一色是 34 岁,占比高达 69%(Cody Collier 实验报告,2026 年 11 月 20 日)。对照美国人口普查局数据,真实成年人的中位年龄是 47 岁,60 岁以上银发族在现实中占 29%,到了 AI 笔下却缩水到近乎隐形的 0.1%。
居住地和职业同样离谱得像同一个模子刻出来的:这批虚拟路人里多达 46% 住在波特兰或西雅图(现实人口占比仅 0.4%),15% 的职业是海洋生物学家(现实不到 0.02%)(Cody Collier 实验报告,2026 年 11 月 20 日)。
每家大厂还在人名上留下了洗不掉的“家族胎记”。Gemini 系列偏爱编造住在西雅图的 34 岁女海洋生物学家 Elena Vance,这个名字在 2025 年之前的六年里从未出现在任何 GitHub 新建项目说明中,到了 2026 年内却突然冒出 684 个开源项目拿她当示例用户。GPT-6、Grok 与 Kimi 扎堆编造的 Maya Chen,更在 2026 年内冲上了 1,847 个 GitHub 新项目。研究者仅凭选数字、颜色、城市、人名等 11 道无害生活小题做成指纹图谱,去盲测 23 款公开了亲缘血统的开源微调模型,竟然精准认出了 22 款的亲爹底座(Cody Collier 实验报告,2026 年 11 月 20 日)。
病根抓到了,把模型教出“标准答案癖”的恰恰是微调那一步
看到这儿,很多人第一反应会怀疑互联网语料:是不是网上夸《活出意义来》和波特兰的帖子太多,大模型只是把人类的流行偏见原样搬了过来?
科利尔调出 AllenAI 全程公开每一阶段权重的开源模型 OLMo 2(1B),用“从 1 到 100 随机挑一个整数”给训练全流程做了次精准验血(Cody Collier 实验报告,2026 年 11 月 20 日)。一枚绝对均匀的百面骰子,随机信息熵满分是 6.64 bits。刚读完海量互联网网页、结束预训练那一刻,OLMo 2 的选数熵高达 6.51 bits,几乎不偏不倚。
真正的坍缩只发生在一个瞬间,也就是拿示范问答集教模型“怎么当一名听话好助手”的监督微调(SFT)阶段。走完监督微调,OLMo 2 的选数熵一步暴跌到 4.95 bits,后面的偏好对齐(4.97 bits)和强化学习(4.98 bits)再也没能改回来。拆开 OLMo 2 公开的 86.6 万条微调教材一看,里面反复出现的 Elara、Vance 和 Marisol,绝大多数竟来自 WildChat 数据集录下的真实 ChatGPT 对话。一家大模型的口头禅,就这样被当成标准参考答案抄进了另一家模型的作业本。受测的 65 款模型里,有 57 款最偏爱的百内数字死死挤在 42、47 或 73 上,整整 36 个数字在一万两千多次提问里一次都没被翻过牌子。
更扎心的是,面对这股刻进骨子里的微调惯性,大家平时最爱用的两招“改良提问法”全都失灵了(Cody Collier 实验报告,2026 年 11 月 20 日):
- 打开“深度思考(Thinking On)”反而更趋同:在 8 道金钱与人生规划题上,开启推理模式没有改变任何一个头号答案,反倒让其中 4 道题更加扎堆,比如推荐搬去美国奥斯汀的比例从 47% 升到了 57%。
- 空喊一句“别给我最常见的答案”只是换条胡同排队:直接问欧洲三天去哪度假,46% 推里斯本。加上一句“不要最常见的答案”,模型确实跳过了榜首,然后把 58% 的人整整齐齐赶去了斯洛文尼亚首都卢布尔雅那。哪怕补上一句“我是俄亥俄州的护士”的粗标签,也只是把你分流进“护士专属车道”,同车道里的同行拿到的照样是同一份批发模板。
把陌生人撞衫率从 34% 压到 4%,日常讨主意该怎么破局?
当你什么个人细节都不交底时,AI 只能把全人类的“统计众数”塞进你手里。
大模型自己其实压根不知道它有多爱发同款传单。当它推荐完“搬去奥斯汀”后,研究者追问“大概有多少问这道题的人会拿到同一个答案?”,模型自信满满地猜约 15%,而真实复现比例高达 80%(Cody Collier 实验报告,2026 年 11 月 20 日)。指望模型自觉变出花样行不通,科利尔回到最顽固的 6 道高频题上重测了四种新问法,替普通人试出了真正把“陌生人拿到同款答案概率”从默认 34% 砸下来的两把钥匙(见下图):
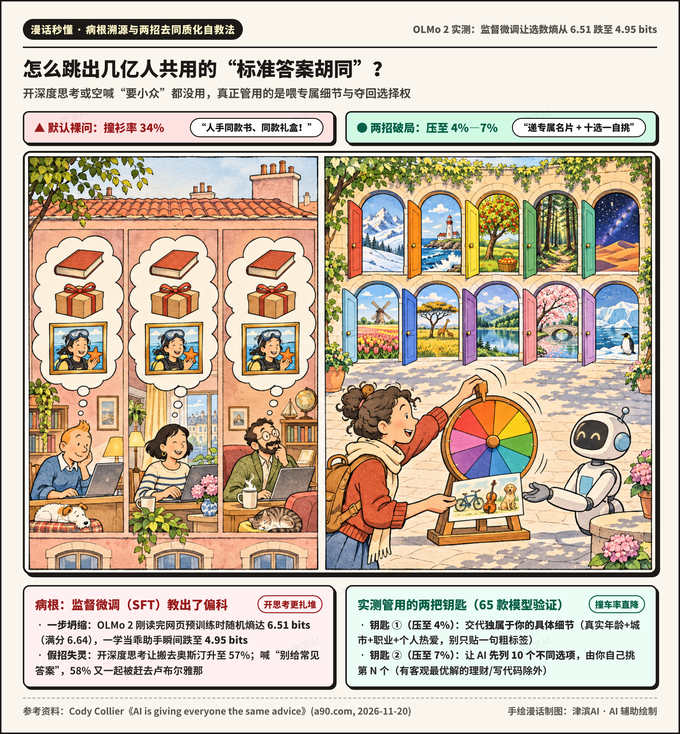
第一把钥匙:喂给它独属于你的具体生活切面(撞车率压至 4%)。 别只贴一句“我是工程师”或“我是老师”的干巴身份牌。把你的真实年龄、所在城市、具体工种,再加上一件你真心热爱的具体小事写进提问里,例如“我 43 岁,在利兹做牙科保健师,平时痴迷自己动手修老式公路车,请推荐一本能触动我的书”。因为地球上很难找出第二个条件完全重合的陌生人,默认老答案占比立刻从 53% 跌到 11%,跟路人撞同款推荐的概率直降到 4%。
第二把钥匙:让 AI 先列 10 个不同选项,由你自己挑第 N 号(撞车率压至 7%)。 在提示词里要求它“先按 1 到 10 列出十个方向各异的备选答案,最后输出你指定的第 N 号”,而数字 N 由你自己随手敲定。把最终拍板权从模型的概率尖峰里夺回来,陌生人撞衫率便能稳稳降到 7%。
当然,防同质化也要分清场合,问题本身有没有客观最优解,决定了你该不该跟那 98% 的人站在一起。正如科利尔在报告中所坦承的:一个普通上班族问一万块闲钱怎么稳妥增值,98% 的模型指向低费率宽基指数基金,恰恰是因为这在长期金融实证里本就是最稳健的标准解法。同样,在写代码生成会话令牌或给模型配上命令行工具时,63 款模型里有 54 款都会规规矩矩调用系统级真随机数工具(代码场景安全生成器采用率达 384 / 390)。真正需要你掏出上面两把钥匙拒绝“被平均”的,是书单审美、创业切口、品牌命名与人生去向这类没有标准答案的选择。毕竟在这些事上,千万个人共用同一份聪明答案,本身就成了最大的平庸。
知识延伸:开发与产品团队用 AI 起名、造测试数据或生成密钥,怎么避开“默认指纹坑”?
把这份 12.7 万次实测报告放到企业研发与产品工作流里,有三条能立刻省下返工账的实操铁律(Cody Collier 实验报告,2026 年 11 月 20 日):
- 绝不在纯聊天框里让大模型“口算”密码或密钥。纯文本生成的所谓强密码带着极高的固定字符拼装偏好(如 25% 混入
"vL"),在安全审计眼里几乎等于半公开字典。凡涉及账号密码、API 密钥与抽奖种子,必须通过本地代码调用操作系统密码学随机源(如 Pythonsecrets模块或 Linux/dev/urandom)。 - 新产品与新公司起名先过“Nex 过滤网”。直接让大模型做命名头脑风暴,近七成科技品牌名会扎堆
Nexora、Nexus等相同词根,极易撞上已注册商标或让投资人一眼看出模板味,务必先用十选一加行业具象意象词打破默认词库。 - 造演示库与自动化测试样本请用专用随机库(如 Faker),别让满屏 34 岁的
Elena Vance和Maya Chen一眼出卖你的产品测试环境。
说明:本文由 津滨AI 编辑部借助 AI 辅助检索公开实验报告并完成初稿整理,经人工逐条核对独立研究者 Cody Collier 于 2026 年 11 月 20 日发布的 127,918 次实测原始数据、OLMo 2 训练阶段熵值及人口统计基准后审校定稿;文内微缩沙盘概念题图与手绘知识连环画原画由 AI 辅助生成(非实拍),横向统计对比图由 津滨AI 基于公开核实资料自制。本文仅作人工智能技术科普与日常应用参考,文中提及的投资类别仅引述原实验统计结果,不构成任何投资建议。
参考资料
- Cody Collier (2026-11-20):AI is giving everyone the same advice
