算力芯片最憋屈的开销,往往花在等数据进门的那几十纳秒里。前英特尔首席执行官帕特·基辛格(Pat Gelsinger)曾亲历傲腾(Optane)通用内存折戟,对半导体行业的存储坟场再熟悉不过。2026 年 11 月 21 日,他在接受 IEEE Spectrum 采访时感慨,整个计算产业已经整整三十年没跑出过真正站稳脚跟的新型存储介质(IEEE Spectrum,2026 年 11 月 21 日)。
偏偏大模型推理与具身机器人把这套老地基逼到了墙角。正如《津滨AI》此前在三星内存采购均价暴涨 263% 与 HBM 定价冲击一文中所算过的那笔硬账,外挂高带宽内存身价连番跳涨,依然解不掉处理器核心贴身缓存吃紧的近渴。2026 年 10 月 26 日,由佐治亚理工学院教授 Suman Datta 与 Shimeng Yu 联合创立的 Nagare Labs 走出隐身模式,拿到由基辛格担任普通合伙人的风投机构 Playground 领投 500 万美元首轮融资,端出了一套名为 Z2RAM 的原型存储技术(IEEE Spectrum,2026 年 11 月 21 日)。
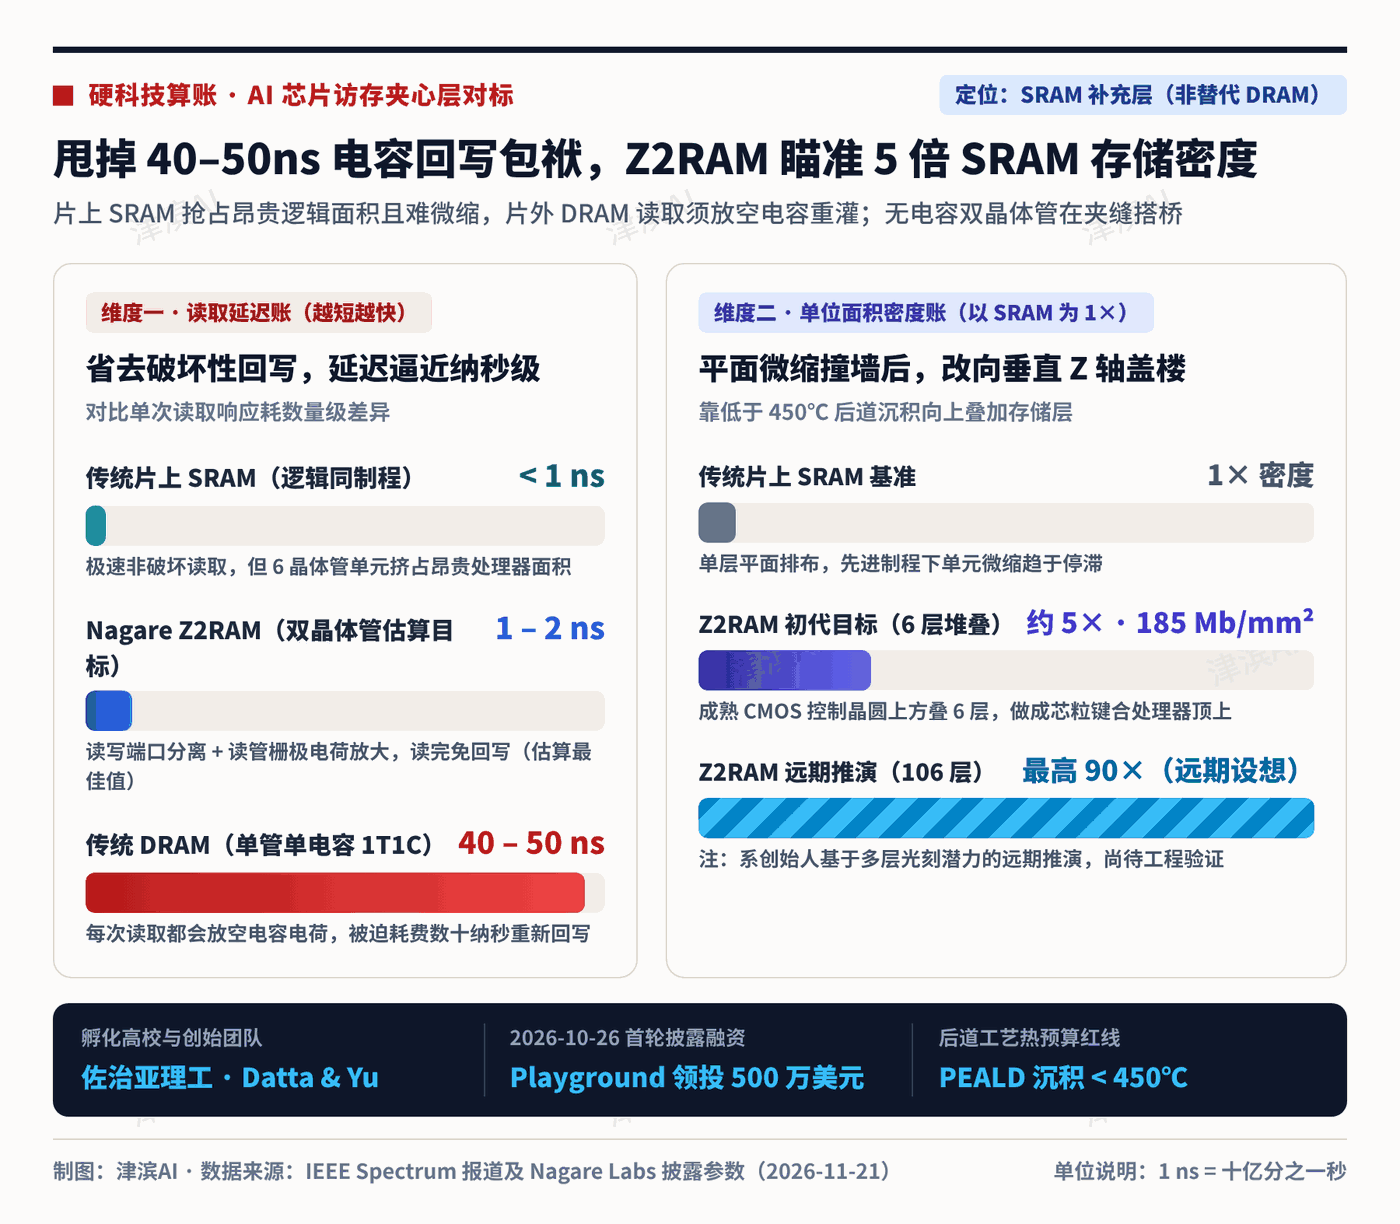
这家学院派初创没有重蹈“一统内存江湖”的覆辙,反倒把商业定位算得很克制:初代目标靠 6 层垂直堆叠做出约 5 倍于片上 SRAM 的存储密度,理想读取延迟瞄准 1 至 2 纳秒,专门在昂贵的 SRAM 与慢吞吞的 DRAM 之间加塞一层低延迟缓冲垫。
贵得肉疼与慢得跺脚,AI算力卡在怎样的存储夹心层?
要看懂 Z2RAM 想赚哪份钱,得先拆开现役芯片里那笔两头受气的“夹心账”。离处理器运算单元最近的是片上静态随机存取存储器(SRAM),响应极快,但它必须跟昂贵的逻辑计算核心挤在同一片先进制程晶圆上。打个生活比方,这就像在寸土寸金的核心写字楼里拿高管办公室改建杂物间,每多塞 1 比特缓存,都要直接抢走实打实的算力裸片面积;况且步入先进工艺节点后,传统 SRAM 单元的面积微缩已经越来越难挤出空间(IEEE Spectrum,2026 年 11 月 21 日)。此前AI 自主设计的 Frostbite 处理器架构之所以大刀阔斧重构访存路径,根源正是传统片上缓存既占地又烧电。
既然芯片屋里寸土寸金,把数据挪到片外的动态随机存取存储器(DRAM)行不行?容量倒是宽裕了,可传统 DRAM 靠一颗小电容存电荷来记录比特,天生带着“破坏性读取”的硬伤。好比每次想看一眼杯子里剩多少水,都得先把水倒干量一遍,再重新往杯里倒满水:DRAM 每读一次都会把电容电荷放空,逼着电路每次读完都得重新回写数据,这一放一充直接把单次访问延迟拉长到了 40 至 50 纳秒(IEEE Spectrum,2026 年 11 月 21 日)。
一边是极快却扩不动容的片上 SRAM,一边是便宜大碗却慢上几十倍的 DRAM。曾任英特尔晶体管研究员的 Suman Datta 给 Z2RAM 划定的坐标非常清醒:“这是对 SRAM 的补充扩充,绝非用来取代 DRAM。”(IEEE Spectrum,2026 年 11 月 21 日)
砍掉电容往高处盖楼,5倍密度与450℃低温账怎么算?
Z2RAM 名字里的两个“Z”,直接亮出了它的两张物理底牌:第一个 Z 代表沿垂直方向(Z 轴)向上叠层盖楼,第二个 Z 代表零电容(Zero Capacitor)(IEEE Spectrum,2026 年 11 月 21 日)。
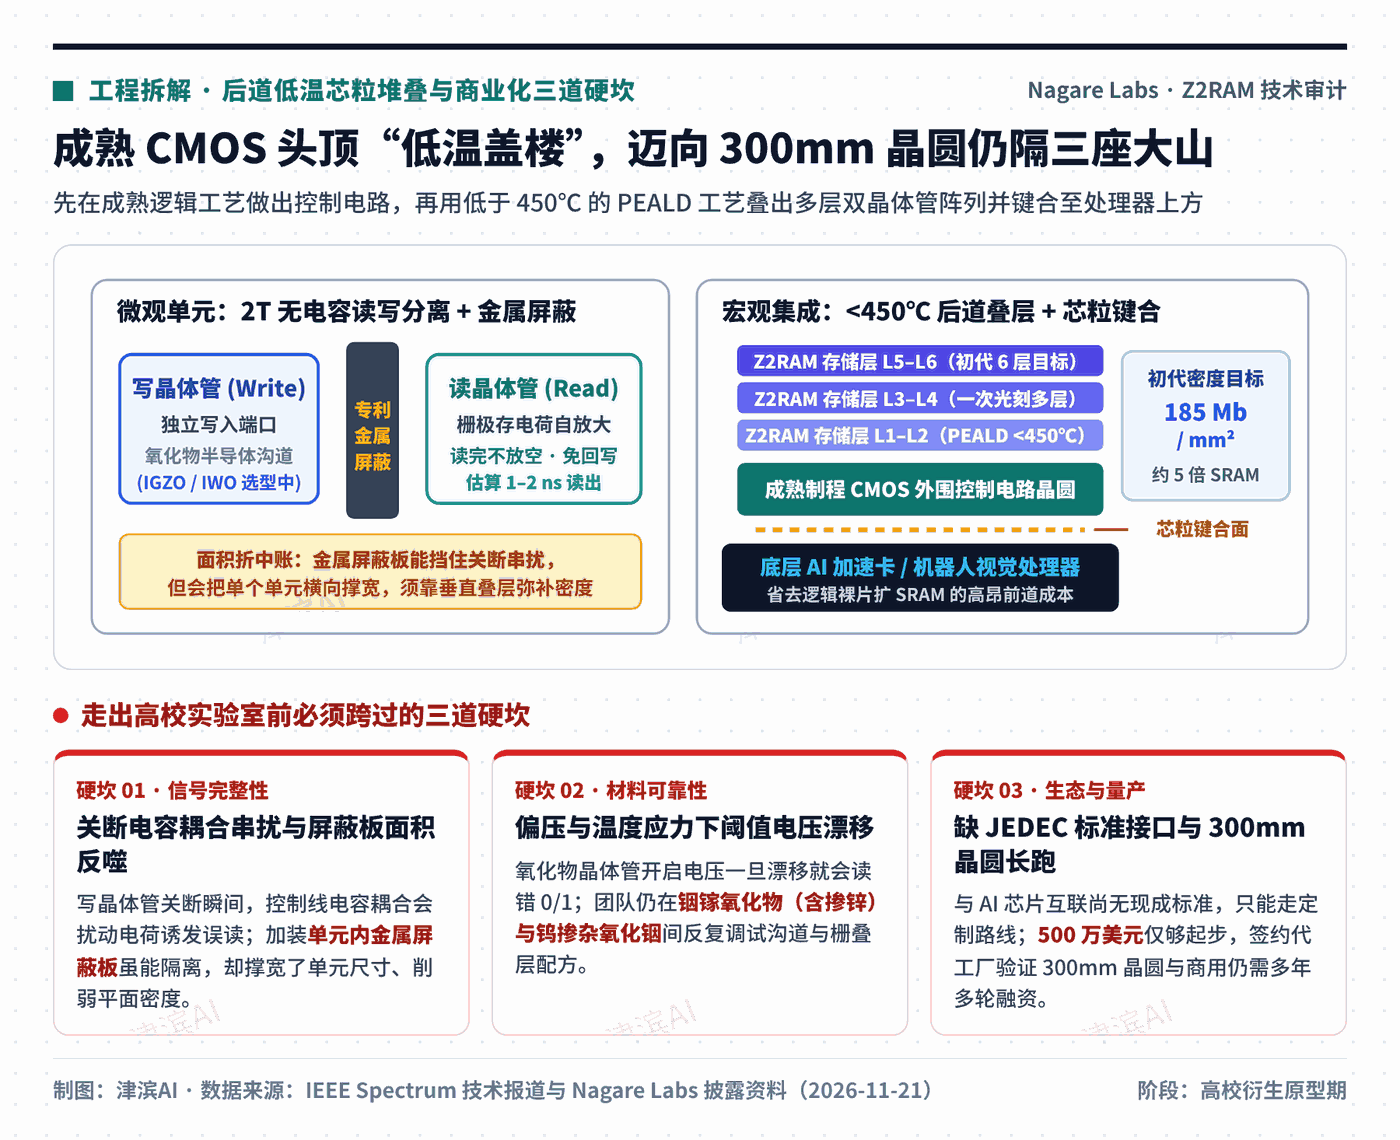
甩掉拖后腿的电容后,Nagare Labs 在每个存储单元里布置了两颗职责分明的晶体管:第一颗专门负责写入比特,第二颗专门负责读取比特,读写操作彻底告别了传统 DRAM 共用同一端口的拥堵。由于电荷直接保存在读晶体管的栅极上,天然带有信号放大作用,哪怕存下的电荷量很小也能被迅速捕捉,而且读完原封不动、省去了回写开销。按 Datta 披露的估算值,这套设计在理想工况下的读取延迟仅需 1 至 2 纳秒,虽然仍比原生片上 SRAM 略慢一线,却比 40 至 50 纳秒的 DRAM 快出了一个数量级(IEEE Spectrum,2026 年 11 月 21 日)。
平面微缩抠不出面积,团队就转身向垂直高度要密度。Nagare Labs 初代产品计划垂直堆叠 6 层,目标存储密度定在 185 Mb/mm²,大约相当于传统片上 SRAM 的 5 倍。Datta 还给出了更远期的理论推演:倘若后续工程验证可行、一路向上堆到 106 层,存储密度有望达到 SRAM 的 90 倍(IEEE Spectrum,2026 年 11 月 21 日)。
敢在现成电路头顶盖高楼,靠的是一笔精明的温度账。常规前道硅工艺动辄上千摄氏度,直接叠层会把底下造好的电路烤坏;Z2RAM 改用等离子体增强原子层沉积(PEALD)工艺制备氧化物半导体晶体管,加工温度压在 450℃ 以下。按照团队规划,可以先用成本可控的成熟逻辑工艺流片做出底层控制电路晶圆,再在上方后道工序里一次光刻叠加多层存储阵列,完工后作为独立芯粒(Chiplet)直接键合到处理器顶上(IEEE Spectrum,2026 年 11 月 21 日)。
从高校论文到300毫米晶圆,量产前还横着哪三道硬坎?
纸面架构再巧妙,半导体产线终究只认良率与长期稳定性。细读 IEEE Spectrum 披露的研发细节,Z2RAM 想走出高校实验室变成商用芯片,面前还横着三道实打实的工程硬坎(IEEE Spectrum,2026 年 11 月 21 日)。
头一道硬坎是写管关断瞬间的电容耦合串扰。 当写入动作结束、写晶体管关闭的那一刹那,控制线产生的电容耦合会像关门带起的穿堂风一样扰动存好的微弱电荷,压缩读取安全裕度甚至引发误读。Nagare Labs 的对策是在每个单元内部嵌入一块专利金属屏蔽板来隔离两颗晶体管,但这招有得有失:金属隔板会把单个存储单元横向撑宽,反过来吃掉一部分平面密度,只能指望垂直多叠几层往回找补。要在纳米尺度算清这类寄生耦合与三维屏蔽得失,极其考验底层物理验证工具链,国内如华大九天在天津泰达芯谷基地重点布局的芯片 EDA 工具链,攻坚的同样是这类复杂器件仿真与寄生参数提取难题。
第二道硬坎是氧化物晶体管的阈值电压漂移。 Datta 直言,现阶段氧化物半导体晶体管最大的拦路虎,是在偏压与温度应力考验下的开启阈值电压稳定性。一旦晶体管的开启电压门槛在长期通电受热后发生漂移,原本存进去的比特就会被读错。为了调稳器件脾气,团队仍在协同微调沟道、栅叠层与电极接触结构,在铟镓氧化物(部分掺锌)与钨掺杂氧化铟等多种材料配方之间反复比选(IEEE Spectrum,2026 年 11 月 21 日)。
第三道硬坎则是缺失的行业接口标准与漫长烧钱周期。 传统存储芯片依靠固态技术协会(JEDEC)的统一接口规范上车,而 Z2RAM 该如何与 AI 处理器互联尚无现成标准,只能寄希望于算力芯片厂商在定制化 HBM 浪潮下愿意接纳专属连接方案。基辛格明确指出,首轮 500 万美元只是起步资金,后续签下晶圆代工伙伴并在标准 300 毫米晶圆上完成验证,势必要经历多轮大额融资与数年研发长跑。除了各大存储技术扎堆争夺的数据中心 AI 加速卡,对总容量要求不高、却苛求极低延迟实时感知环境的具身机器人边缘视觉模型,有望成为 Z2RAM 更早切入的差异化场景(IEEE Spectrum,2026 年 11 月 21 日)。
知识延伸:为什么芯片后道叠层工艺总把“450℃”当成安全红线?
关注三维芯片与新型存储的读者常会发现,无论是氧化物晶体管还是新型铁电存储,只要想往逻辑晶圆头顶叠层,都会特意强调工艺温度“低于 450℃”。这道温度门槛究竟卡在哪里?
一颗现代 CMOS 芯片的制造分为上下半场:前半场(前道工序 FEOL)直接在裸硅晶圆上高温掺杂烧结底层晶体管,承受上千摄氏度毫无压力;可一旦进入后半场(后道工序 BEOL),底层晶体管上方已经铺满了多层纳米级铜互连导线与超低介电常数绝缘介质。如果此时为了加盖上层存储阵列而把整片晶圆重新塞进超过 450℃ 的高温炉管,底层纤细的铜导线就会发生剧烈热膨胀与原子扩散,多孔绝缘层也会退化开裂,直接毁掉底下已经造好的逻辑电路。把沉积温度死死按在 450℃ 热预算以内,正是让存储阵列得以“低温拎包入住”成品晶圆顶楼的工程前提。
说明:本文由 津滨AI 借助 AI 辅助检索与起草,所有核心数字与事实均经公开一手信源核对;文中概念题图与插画系 AI 辅助生成示意,非现场实拍。本文仅作半导体工程技术交流参考,不构成任何投资建议。
参考资料
- Matthew S. Smith, IEEE Spectrum (2026-11-21):Z2RAM Claims SRAM Memory Speeds at Much Greater Density
