在抗癌靶点 PRMT5 的先导化合物攻关桌上,摆着两份让人左右为难的实验账单:23 号化合物在细胞内封堵致病蛋白所需的浓度更低、抑酶劲头更猛,偏偏穿过细胞屏障的能力弱了一截,遇到肝脏代谢酶还容易被迅速拆解;旁边的 24 号化合物跨膜通透顺畅,在肝酶测定里也扛得更久,唯独锁死靶点的活性退了一步(OpenAI,2026 年 11 月 20 日)。
这种“按下葫芦浮起瓢”的多属性拉锯,是每一位药物化学家在实验台前反复博弈的日常。2026 年 11 月 20 日,OpenAI 正式发布药物化学推理评测基准 MedChemBench,从 117 篇已发表科研论文与专利中提炼出 761 个独立分子结构,浓缩成 99 道还原真实研发节点的推理考题,检验前沿大模型能否读懂化学图纸、解释实验证据,并预判下一轮最值得合成测试的候选分子(OpenAI,2026 年 11 月 20 日)。
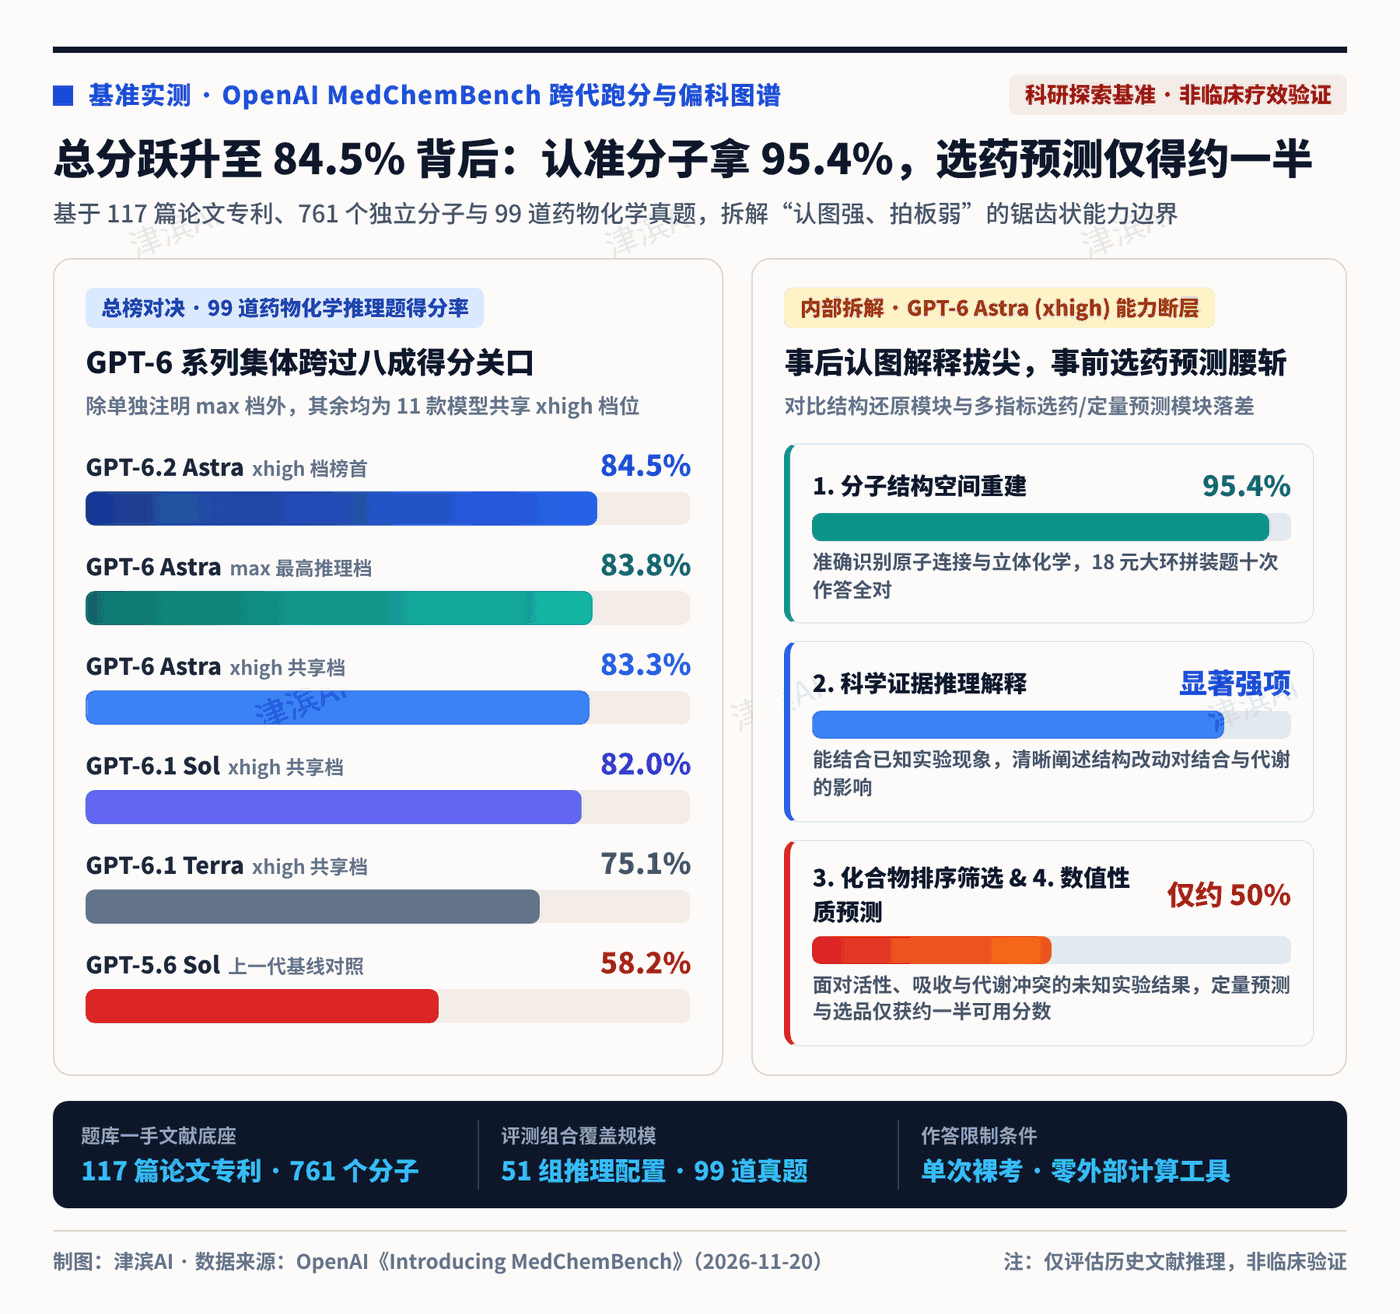
跑分榜单揭开了一道鲜明的能力断层:在受测模型共用的 xhigh 高推理档位下,最新的 GPT-6.2 Astra 拿下 84.5% 总分,GPT-6 Astra 也取得 83.3%;可一旦拆开四大模块细看,模型在“重建分子结构”上拿到了高达 95.4% 的分数,一到“化合物排序优选”与“数值性质预测”,得分立刻跌落到约一半水平(OpenAI,2026 年 11 月 20 日)。
十次作答保住18元大环,新模型先把“认错分子”的老病治好了
想让人工智能参与改药,头一道基本功是别把分子图纸看走眼。化学结构式浓缩了严密的原子连接关系、环系尺寸与三维立体化学构型,哪怕在拼装基团时漏数一个原子,后续推演的就完全成了另一种化合物。
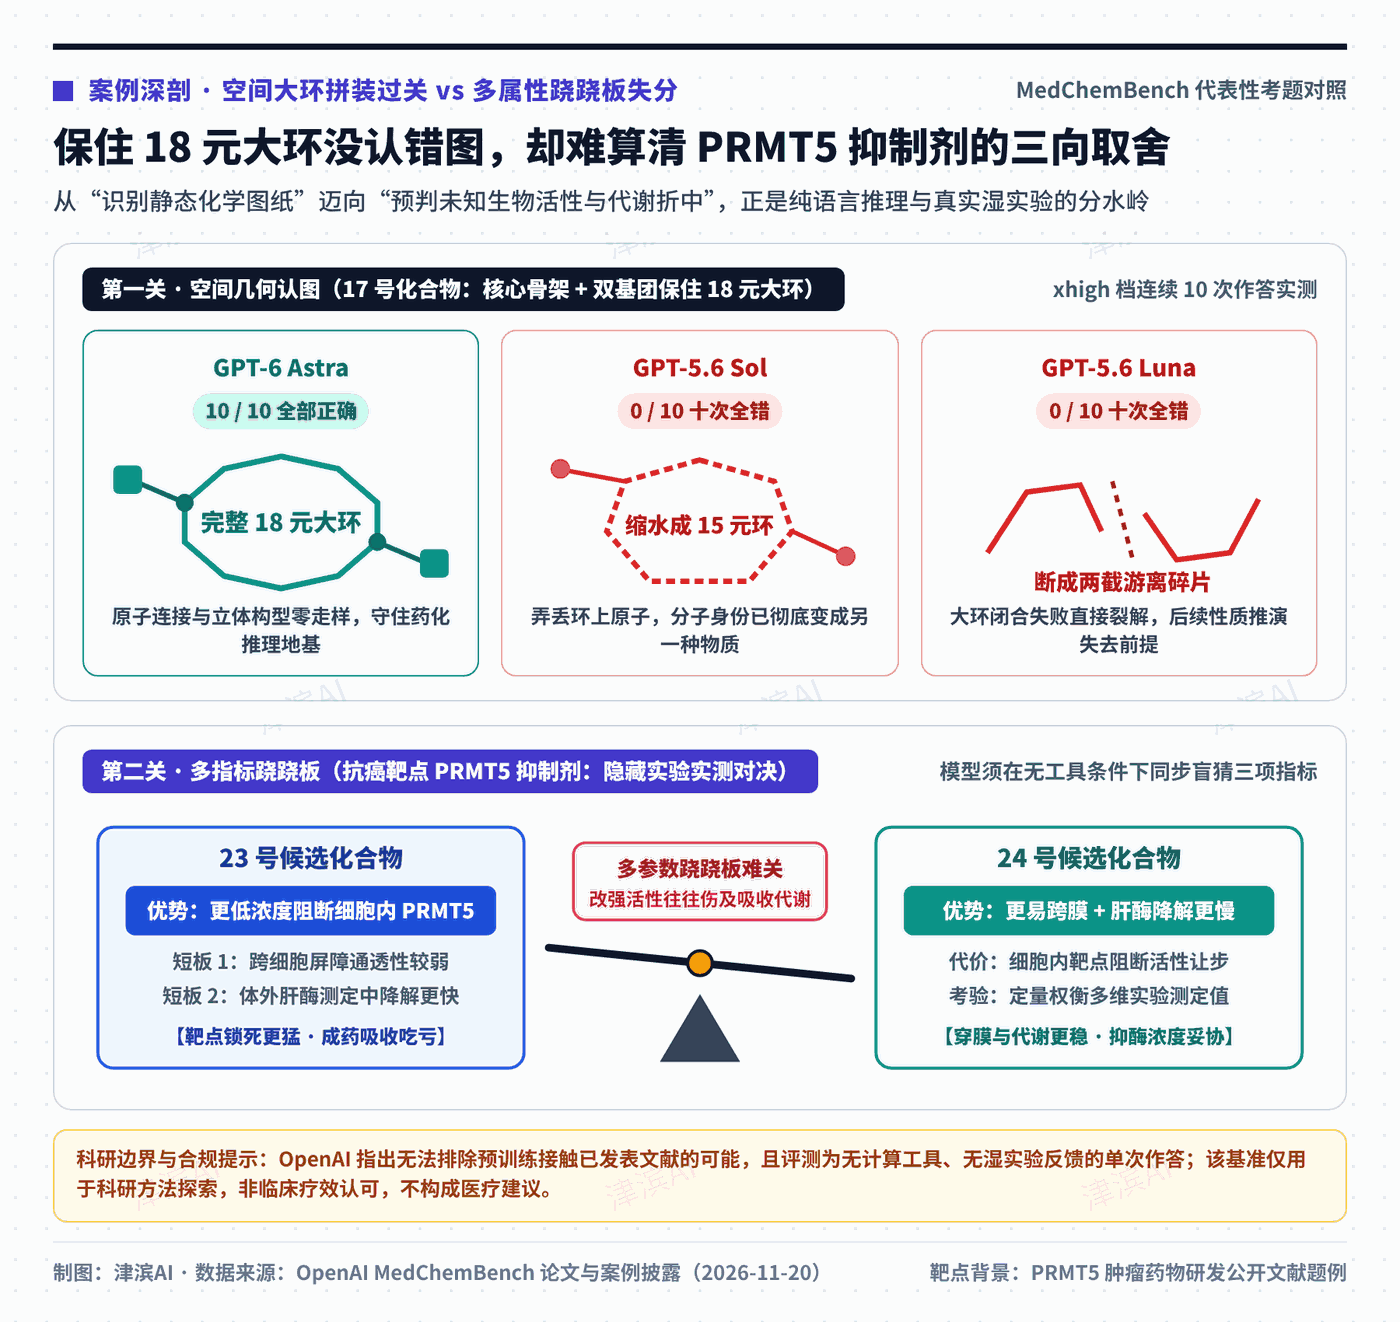
MedChemBench 专门设置了一道考验空间几何定力的拼装题(17 号化合物):要求模型把一个核心母核与两个外接基团组装起来,同时原封不动保住核心部位那圈复杂的 18 元大环。在 11 款模型共用的 xhigh 档位下,上一代模型十答十败:GPT-5.6 Sol 把好端端的 18 元大环硬生生缩成了 15 元环,GPT-5.6 Luna 更干脆,直接把一颗完整分子劈成了两截互不相连的残片,还没开始算药效就已经认错了研究对象(OpenAI,2026 年 11 月 20 日)。
到了新一代模型手里,这道空间识别关终于被稳稳跨过。GPT-6 Astra 在十次独立作答中全部准确拼出了这圈 18 元大环,在整个基准的分子结构重建模块里拿下了 95.4% 的可用分数(OpenAI,2026 年 11 月 20 日)。
拉通总分榜同样能看清这轮跨代跃升:同在 xhigh 推理档位下,上一代 GPT-5.6 Sol 仅得 58.2%,GPT-6.1 Terra 与 GPT-6.1 Sol 分别升至 75.1% 与 82.0%,而 GPT-6 Astra(调至最高 max 档可达 83.8%)与榜首 GPT-6.2 Astra(84.5%)双双站上了八成得分线(完整梯度见下图)(OpenAI,2026 年 11 月 20 日)。
活性、吸收与代谢三头拉扯,为什么一到“挑化合物”得分就腰斩?
认准结构式、顺着现成实验数据写出条理清晰的机理分析,恰恰是大模型最得心应手的“事后复盘”;真正卡住顶尖模型的,是在实验结果揭晓前对多项冲突指标做定量权衡。这种局部惊艳、局部掉队的反差,与《津滨AI》此前在拆解 METR 第四季度能力曲线及追踪OpenAI 科研加速“锯齿状前沿”报告时点明的现象如出一辙:漂亮的总平均分底下,往往掩盖着剧烈起伏的子项短板。
回到开篇那道 PRMT5 抗癌靶点抑制剂考题。评测框架只向模型提供研发中期的已知结构与前期测得数据,把后续实测结果严格隐去,要求模型同时预测三颗相关化合物在三项关键指标上的表现:细胞内阻断 PRMT5 的活性强弱、跨越细胞屏障的通透能力,以及在体外肝酶实验中被代谢拆解的快慢(OpenAI,2026 年 11 月 20 日)。
打个通俗比方,设计候选新药就像调校一台既要直线加速猛、又要急弯抓地稳、还得极端省油的赛车,把涡轮增压拧大一格,散热与油耗往往当场报警。在药物分子改造里,微调一个侧链基团固然能让分子更紧地咬合致病蛋白,却可能顺带毁掉它的穿膜吸收率,或者让它沦为肝脏代谢酶眼里的易碎品。
MedChemBench 的分项成绩单直白暴露了这道软肋:哪怕 GPT-6 Astra 在还原分子结构上拿到 95.4% 高分,也能结合已知证据合理推演基团改动对蛋白结合、吸收和代谢的影响方向,可一旦进入真刀真枪的“化合物排序筛选”与“数值性质预测”两个模块,它的得分便骤降至约一半水平(OpenAI,2026 年 11 月 20 日)。
单轮裸考与语料暴露之外,AI进湿实验室还缺哪块拼图?
难得的是,OpenAI 在这份技术报告末尾主动给自家的八成高分划出了三条清醒边界,没有把基准跑分包装成“AI 自主造药神器”(OpenAI,2026 年 11 月 20 日)。
第一重边界在于历史公开语料的潜在记忆干扰。由于 99 道考题全部取材于公开发表的 117 篇论文与专利,研究团队坦承无法彻底排除模型在预训练阶段接触过部分原始文献的可能性;面对药企内部从未公开过的全新靶点与私有分子骨架时,模型的真实泛化能力仍需大打折扣审视。
第二重边界在于评测采用无工具、无反馈的单轮裸考模式。每道题目只给模型一次直出回答机会,既不允许调用分子对接与自由能微扰等专业计算化学工具,也没有真实湿实验室合成测试后的多轮迭代纠偏。这恰恰印证了此前天津大学发布“天华开物”酶设计大模型并打通生物制造转化闭环时的产业实践逻辑:脱离自动化湿实验验证与实测负样本回流,单靠语言模型凌空推演,很难跨过多参数定量优选的鸿沟。
对一线新药研发团队而言,2026 年底这一代高推理模型的实用坐标已经很清楚:它足以胜任“零低级认图失误、快速消化上百篇专利构效脉络”的高效科研助手,却还远未具备独立拍板下一轮合成管线的决策能力。需要明确指出的是,该基准仅基于历史公开文献评估模型推理表现,尚处科研方法与试验探索阶段,并非临床疗效认可,也不构成医疗建议或任何真实新药上市验证。
知识延伸:为什么新药研发总绕不开“活性与成药性跷跷板”?
刚接触生物医药报道的读者容易产生一种错觉:只要用 AI 筛出一颗能死死粘住致病靶点蛋白的分子,新药就成了大半。实际上,靶点抑酶活性(Potency)只是万里长征的第一张门票,临床前阶段淘汰率最高的地方,恰恰是吸收、分布、代谢、排泄与毒性(统称 ADMET 成药性指标)。
一颗小分子药物想在人体内起效,既得有足够的亲水性才能溶解在消化道体液里,又得有恰到好处的脂溶性才能钻过由脂质双分子层构成的细胞膜屏障,半路上还要躲开肝脏细胞色素酶家族的“剪刀手”,保证在血液里留出足够长的半衰期。麻烦在于,化学家为了提升靶点结合力往分子上添加疏水基团时,往往会让分子变得更难溶解、更容易被肝酶捕获降解。这种牵一发而动全身的多参数优化(MPO)困境,正是纯文本推理模型缺乏物理化学仿真工具与湿实验数据时最难算准的硬骨头。
说明:本文由 津滨AI 借助 AI 辅助检索与起草,所有核心数字与事实均经公开一手信源核对;文中概念题图与插画系 AI 辅助生成示意,非现场实拍。本文仅作科研基准评测与药物化学方法学科普解读,非疗效认可,不构成医疗建议或投资依据。
