看见 “Small” 和“开放权重”,很容易把它理解成又一个可以塞进消费级电脑的开源模型。Thinking Machines Lab 放在 Hugging Face 上的 Inkling 2 Small 模型卡[1] 给出的门槛,不是这个方向。
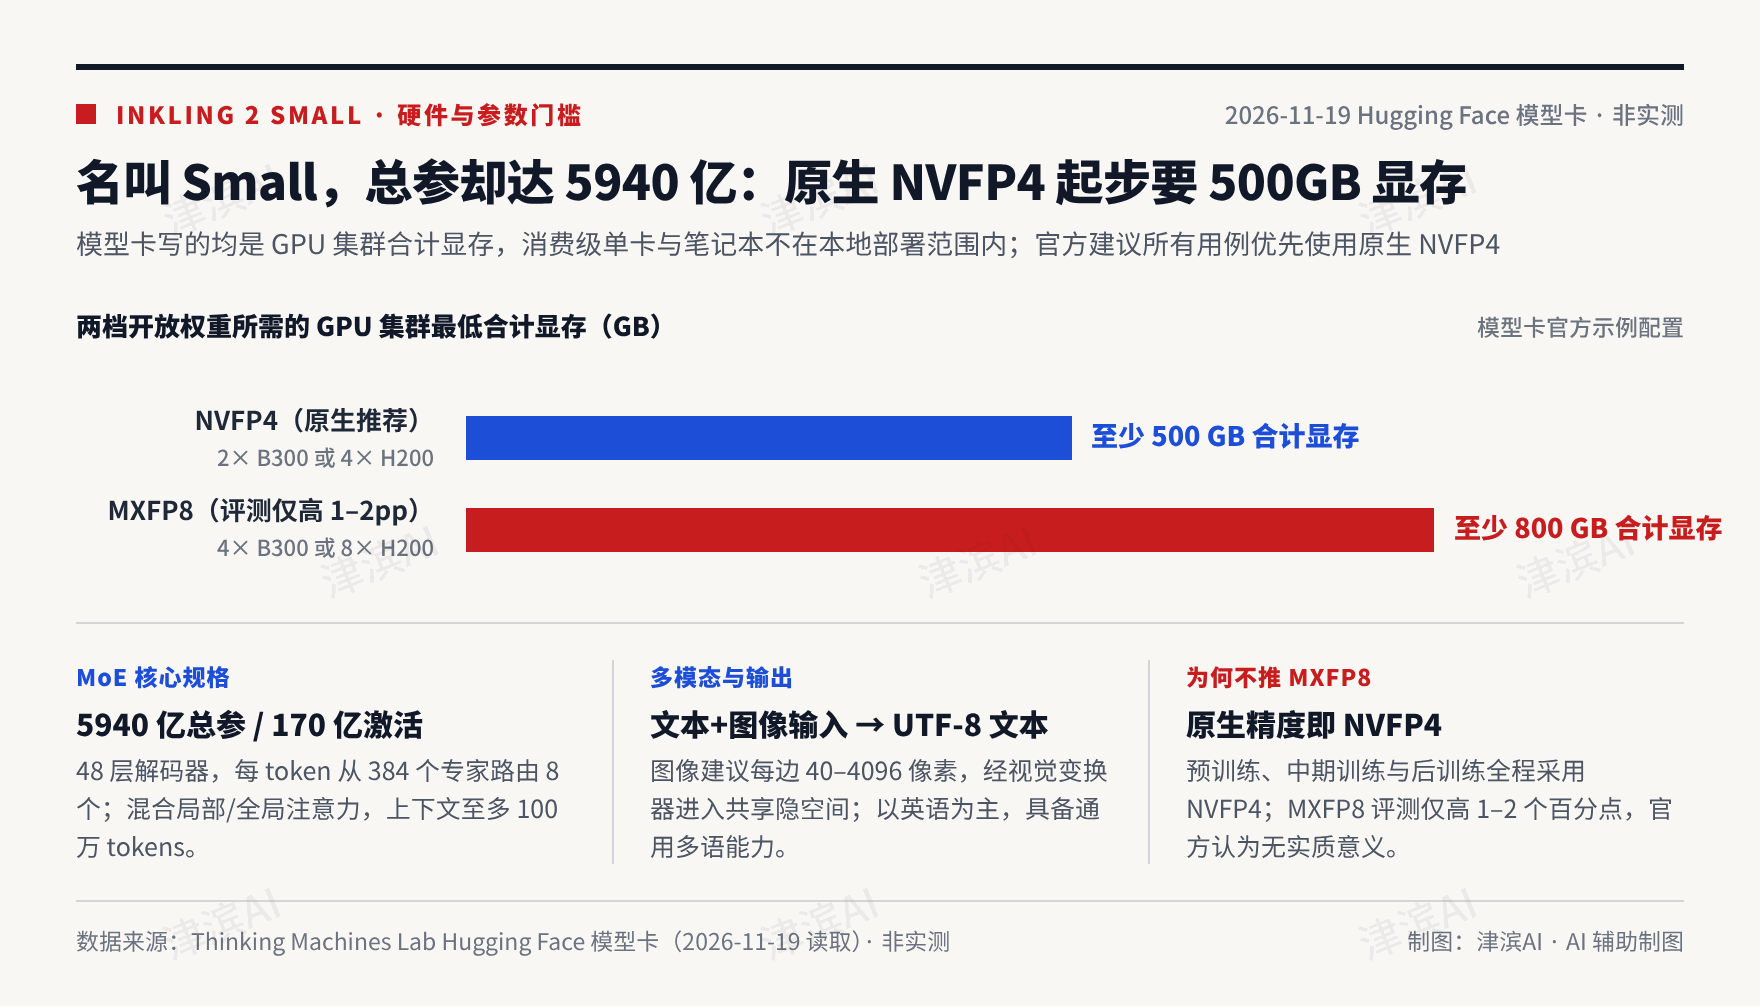
官方写明,主推的 NVFP4 权重需要 GPU 集群提供至少 500GB 的合计显存,示例配置是 2 张 NVIDIA B300,或 4 张 NVIDIA H200。另一份 MXFP8 权重则需要至少 800GB,示例是 4 张 B300 或 8 张 H200。模型在预训练、中期训练和后训练中都使用 NVFP4,官方把它当作原生精度,并建议所有用例都用这份权重;MXFP8 在评测上只高出 1 到 2 个百分点,官方认为对实际使用没有实质意义。
所以,如果你手里是一台普通笔记本或单卡工作站,按这份模型卡,现在还不必把它写进“本地下载即可部署”的清单。已经具备上述量级集群、只做研究或下游集成的人,可以跳过这层,直接看规格和许可。
开放权重解决的是研究与集成,不是把集群需求砍掉
模型卡把 Inkling 2 Small 写成通用多模态模型:接受文本和图像,生成文本,面向开发者去构建带工具调用的系统、编码助手、聊天机器人和检索增强应用。它以开放权重发布,支持研究、微调以及集成进第三方产品。语言上以英语为主,并写明对其它语言有通用的多语能力。
规格也很明确。它是 48 层的解码器混合专家模型,每个 token 路由到 384 个专家中的 8 个,总参数 5940 亿,激活参数 170 亿。注意力是局部层与全局层的混合,图像由视觉变换器编码后,与文本一起进入共享隐空间。上下文窗口至多 100 万 tokens。图像输入可以是常见像素格式,官方建议每边最好在 40 像素到 4096 像素之间。输出是 UTF-8 文本。
名字里的 Small,是相对于其系列的型号称呼,不是“参数小、显存小、笔记本就能跑”的保证。5940 亿这个总参数量,已经足够说明它和常见的消费级开源聊天模型不是同一档硬件需求。
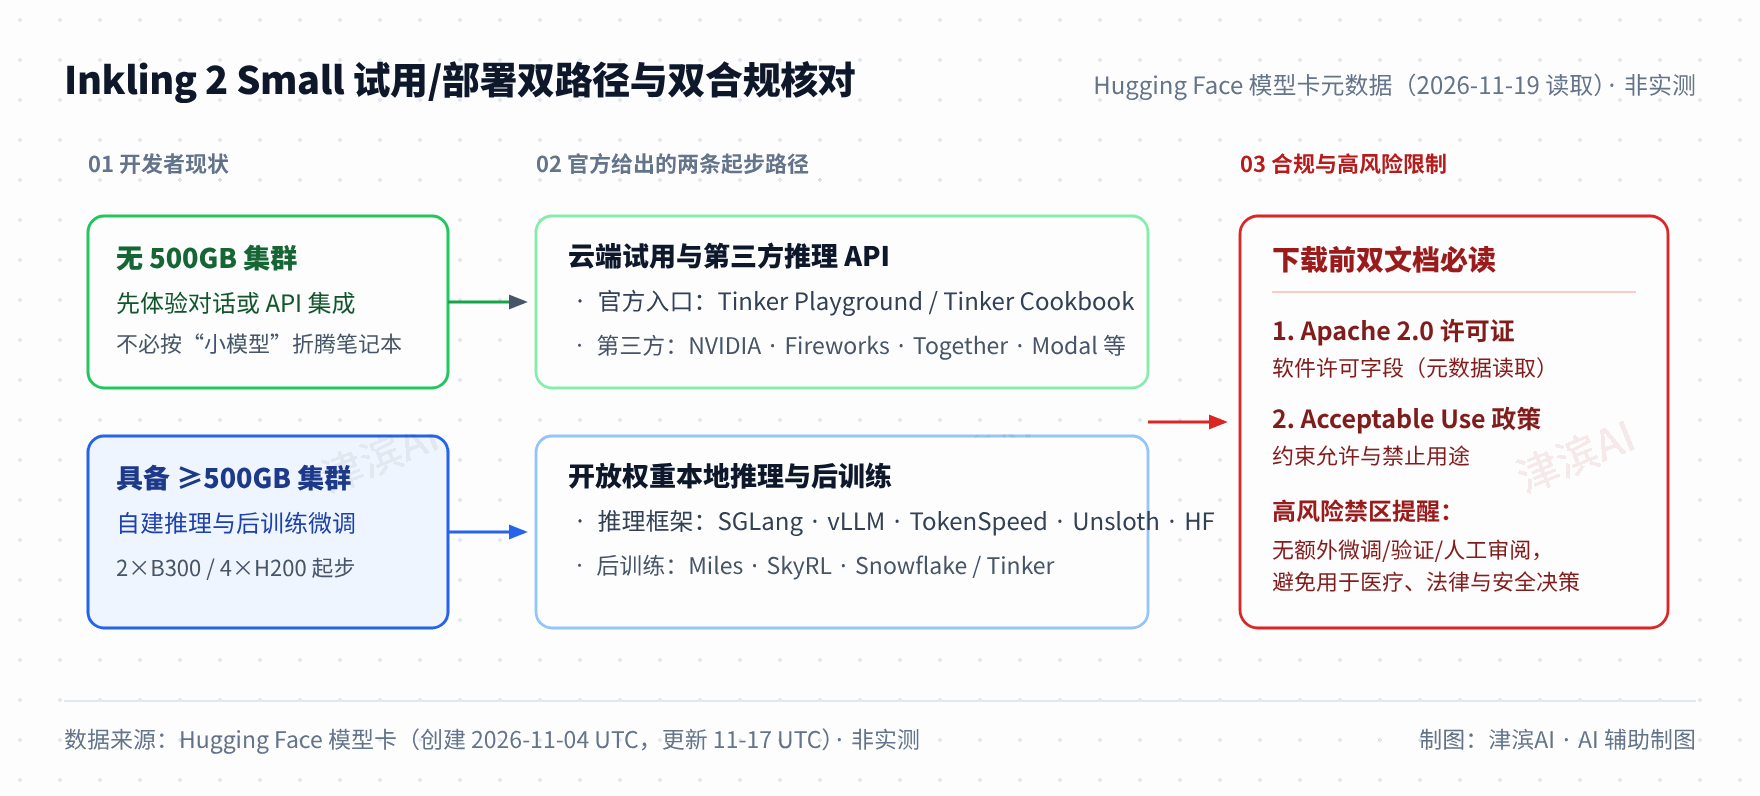
试用和部署路径被分成几条。你可以在 Tinker Playground[2] 里先试,或按 Tinker Cookbook[3] 通过 API 访问;本地直接跑则需要推理框架,官方点名 SGLang、vLLM、TokenSpeed、Unsloth 或 Hugging Face,以及它们各自的依赖。模型卡还提到可由 NVIDIA、Fireworks、Together 等第三方推理服务提供 API。模型卡还列出了可做后训练的方向,包括 Miles、SkyRL 和 Snowflake Cortex Training;若要用 Tinker 微调,还需安装 tml-renderers 包。第三方推理服务点名了 NVIDIA、Fireworks、Together、Baseten、Nebius、Modal 和 Cloudflare。这些路径并不改变 500GB 合计显存这一本地门槛,只是给你在没有自建集群时另外的试用或调用方式。名单以模型卡当时页面为准,并不等于每一家都已在你所在地区开放,也不等于本刊已经开通测试。
许可和日期,以模型卡元数据为准
2026 年 11 月 19 日读取的 Hugging Face 模型卡元数据里,license 字段为 apache-2.0,并给出 Apache 2.0 许可证链接。页面顶部同时链向 Thinking Machines 的 Acceptable Use[4] 政策。开放权重不等于没有任何使用限制:许可文本和可接受使用政策都要在下载前打开看,不能只凭“开源”两个字做合规结论。
仓库创建时间是 2026 年 11 月 4 日 19:51(UTC),对应北京时间 11 月 5 日 3:51;最后修改时间是 11 月 17 日 18:39(UTC),对应北京时间 11 月 18 日 2:39。本文不以“11 月 12 日上线”这种未在模型卡或 API 中出现的日期作为发布日。
安全建议同样写在卡片上。官方建议下游开发者在高风险或安全关键场景中加入适当的人工审阅,而不是直接采信模型输出;尤其在涉及脆弱群体的应用里,应针对具体用途、语言和人群自行评估表现、安全与公平。他们还建议在应用层增加过滤、限流和监控,并写明:在缺少额外微调、领域验证和人工审阅的情况下,应避免把该模型部署到医疗、法律或安全关键决策中。本文不转写本次抓取中不够稳定的评测榜数字。
这就回到开头的判断。开放权重降低的是获取和二次开发的门槛,不是把集群需求降到消费级。若你的目标只是体验对话,官方 Playground 或第三方推理更接近这条模型卡给出的起步方式;若你的目标是自建部署,先核对合计显存、框架依赖、Apache 2.0 和可接受使用政策,再决定要不要拉权重。
知识延伸:合计显存和单卡显存不是一回事
消费级讨论里常说的“这张卡有多少 GB 显存”,指的是单卡容量。Inkling 2 Small 模型卡写的是 GPU 集群的合计显存:NVFP4 至少 500GB,MXFP8 至少 800GB,并分别给出 2 张 B300 或 4 张 H200、4 张 B300 或 8 张 H200 的示例。合计意味着多卡显存加总,还要满足该精度格式和推理框架的实际分布方式,并不能理解成“随便把几张消费卡的标称容量加到 500 就一定能启动”。官方把 NVFP4 当成本土精度并建议优先使用,是因为它就是训练用的格式;MXFP8 虽然在部分评测上略高,却被写成对实际使用没有实质意义。许可上,Apache 2.0 解决的是软件许可,可接受使用政策解决的是允许和不允许的用途,两份都要看。对没有集群的人,更贴近官方起步路径的是 Playground 和推理 API,而不是按“小模型”去准备笔记本。
说明:本文由津滨 AI 借助 AI 辅助检索与起草,并经人工对照 Hugging Face 模型卡正文及 2026 年 11 月 19 日读取的模型卡元数据核实审校。文中信息图由津滨 AI 根据已核实的官方数字制作,图中均标明“制图:津滨AI / 非实测”,为 AI 辅助生成的概念示意图,并非实拍或官方原图。封面为 typographic 光影卡片,同样为 AI 辅助生成、非实拍。作者未部署该模型,也未复核评测榜原始跑分,硬件门槛以模型卡为准。
参考资料
[1] Inkling 2 Small 模型卡:https://huggingface.co/thinkingmachines/Inkling-2-Small
[2] Tinker Playground:https://tinker.thinkingmachines.ai/playground
[3] Tinker Cookbook:https://github.com/thinking-machines-lab/tinker-cookbook
[4] Acceptable Use:https://thinkingmachines.ai/model-acceptable-use-policy
