想在自己桌子上跑本地模型的人,看英伟达 2026 年 11 月 18 日这篇 RTX Spark 紧凑桌面博客[1],真正先要确认的不是“性能有多惊人”,而是:现在能买到哪几家,以及这页有没有标价。
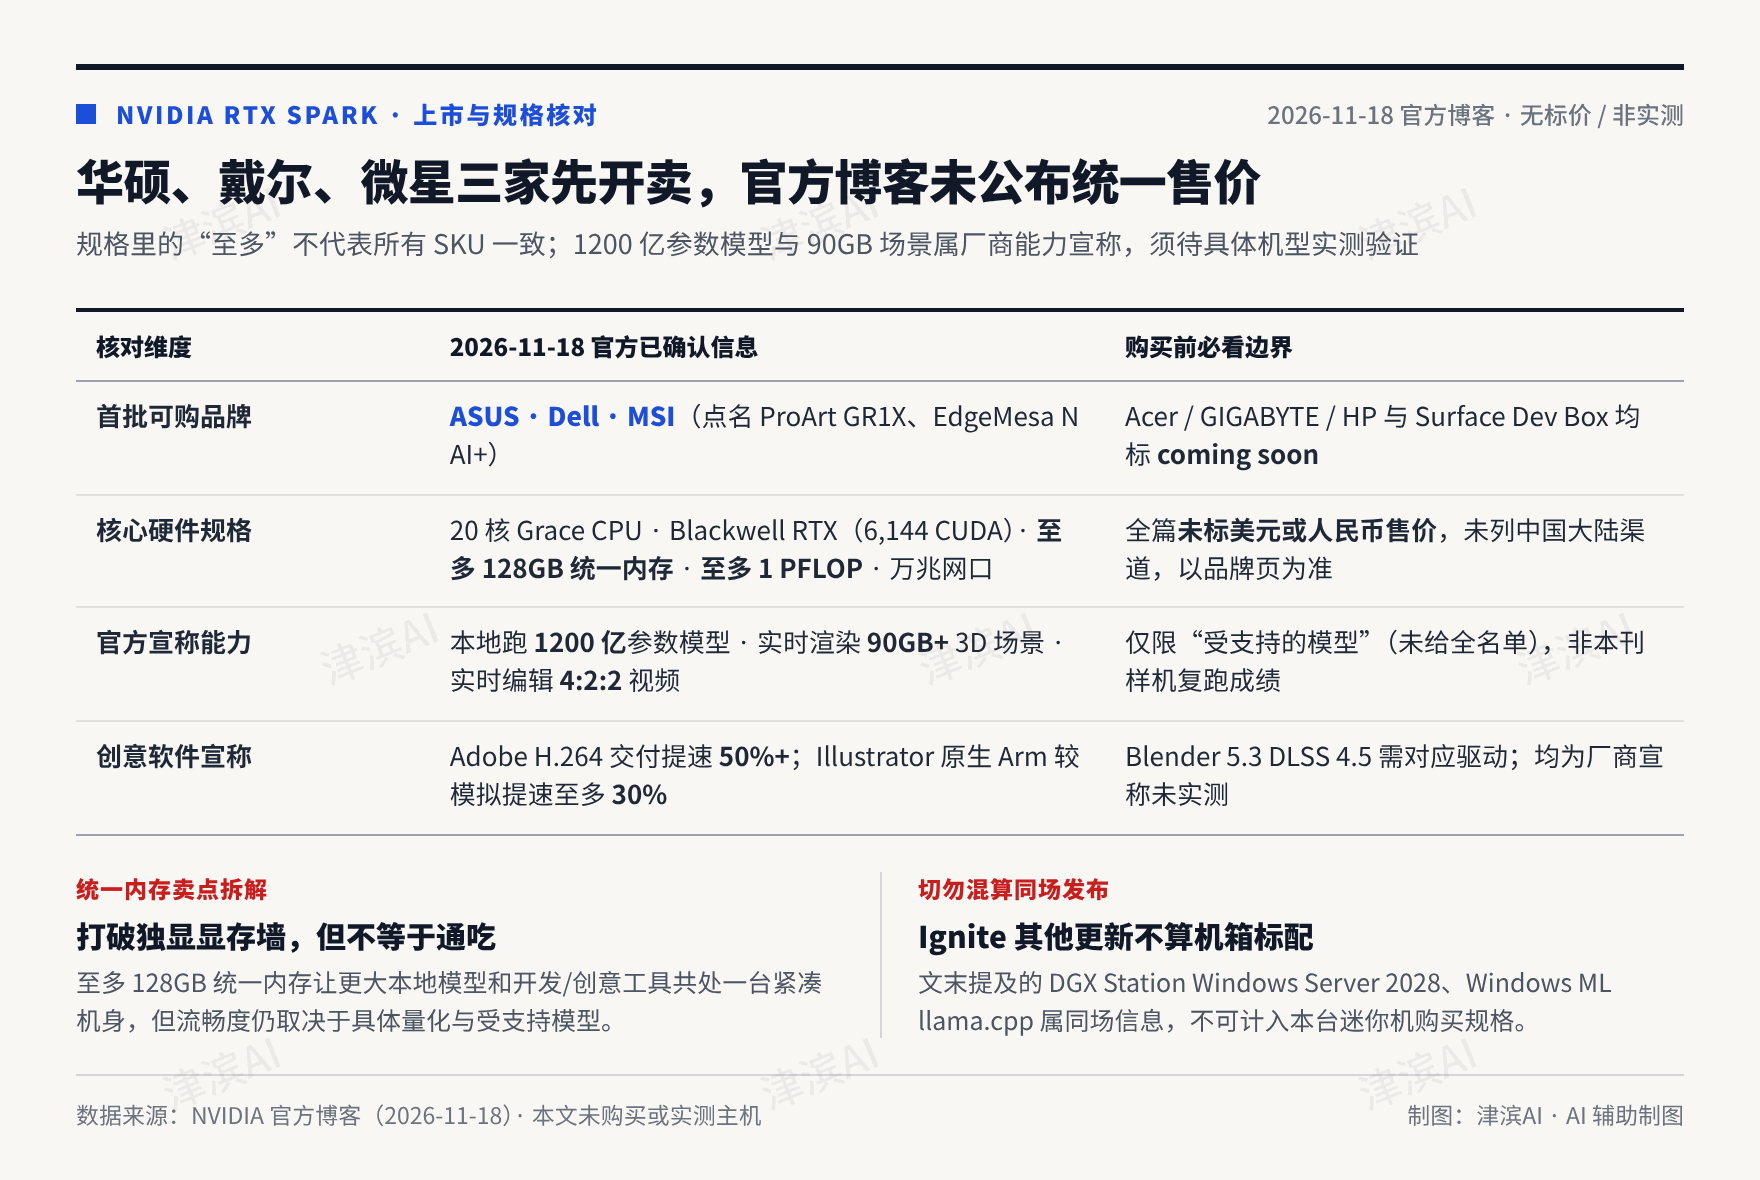
答案很硬。当天可购买的是 ASUS、Dell、MSI 三家的紧凑桌面,它们加入已经在售的 RTX Spark 笔记本产品线。Acer、GIGABYTE、HP 的迷你机,以及 Microsoft Surface RTX Spark Dev Box,官方写成 coming soon,没有给出到货日。整篇博客没有出现美元或人民币售价,也没有列出中国大陆的销售渠道。在看到品牌页面上的具体配置和价格之前,不必把这篇文案当成可以立刻下单的价目表。
作者是 Justin Walker。标题用的是 Out Now,正文用 available today,对应的是公告当天这三家已经开卖,而不是六家一起上架。文中点到的产品例子包括华硕 ProArt GR1X 迷你机,以及微星 EdgeMesa N AI+ 系列,用来说明这类紧凑桌面被设计成可以全天运行个人 AI 代理。它们是官方点名的型号例子,具体在售配置仍以品牌页面为准。
官方规格和宣称能力,要分开记
RTX Spark 桌面被写成一台面向开发者、创作者和 AI 爱好者的专用 Windows 电脑,用来跑本地模型和保持常开的代理,并把图像与视频生成、模型微调、创意应用和开发工具收进同一台紧凑机器。一台专用桌面可以让代理和计划任务继续跑,笔记本则拿去出差或处理其他工作。
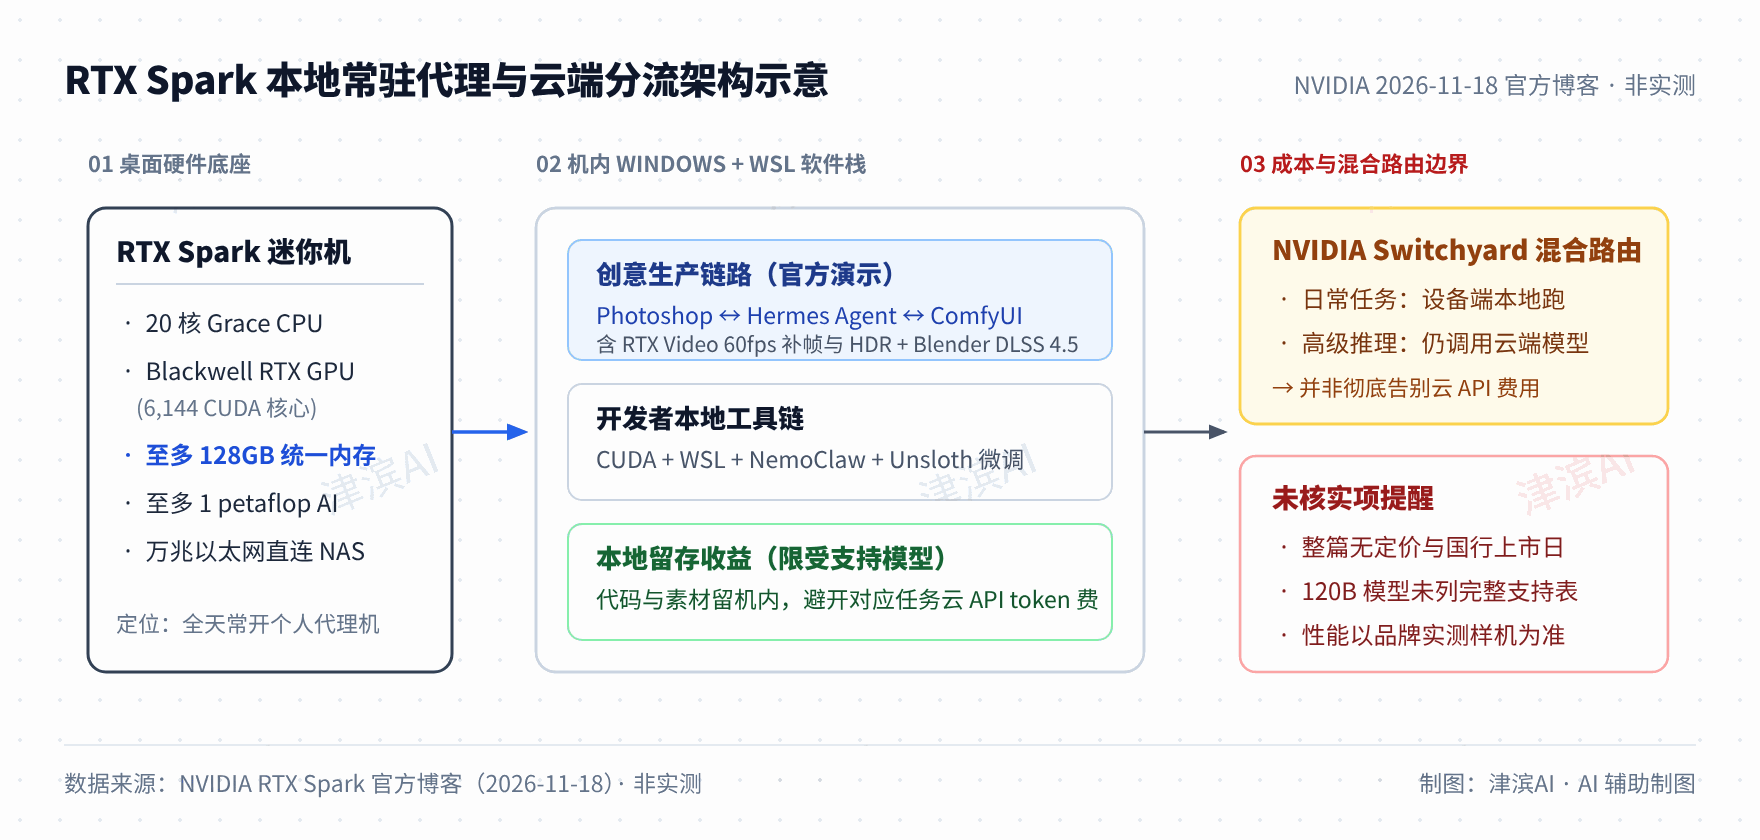
规格段写得比较具体:20 核 NVIDIA Grace CPU,NVIDIA Blackwell RTX GPU(6,144 个 CUDA 核心),统一内存至多 128GB,AI 性能至多 1 petaflop,并配备万兆以太网,方便在迷你主机和网络存储之间搬动大数据集、模型文件和素材。这里的“至多”不能写成所有 SKU 都是同一个数字,最终仍以各品牌页面为准。
官方接着列举了三项“解锁的能力”:在本地运行大规模 1200 亿参数的语言模型;实时渲染 90GB 以上的 3D 场景;实时顺畅编辑 4:2:2 视频。这是英伟达自己的能力声明,不是本刊在某台样机上复跑后的成绩单。页面也没有给出这三项分别对应哪一个具体型号、哪一个模型版本。
同一段还写:在本地运行受支持的模型时,本地处理的代码和文件可以留在这台电脑上,并避免这些任务产生按 token 计费的云 API 费用。这句话有两个限定:一是“受支持的模型”,该页并未给出完整名单;二是“这些任务”,并不能理解成所有工作都不再产生云费用。后面提到的 NVIDIA Switchyard 甚至写明,日常任务可以在设备上运行,高级推理仍可调用云端模型,以管理创意工作流中的云成本。
软件栈写进了同一台 Windows 电脑,但不要把同场发布都算进机箱
博客把软件生态和主机放在一起讲:Adobe 的原生 Windows on Arm 应用、Blender 中的 NVIDIA DLSS 光线重建,以及 ComfyUI 的本地生成工作流,都可以在这台 Windows 电脑上展开。开发者则获得原生 CUDA,并可通过 Windows Subsystem for Linux 使用 Linux 开发工具;官方提到可用 Hermes Agent 或 NVIDIA NemoClaw 蓝图设置代理,并用 Unsloth 微调受支持的模型。博客还描述了一条把 Photoshop 与 ComfyUI 经 Hermes Agent 连起来的创意路径:用自然语言把草图做成渲染图和动画,或在设备上完成从抠出主体、定义运动到生成视频的步骤。英伟达称,这些流程曾在 Adobe MAX 上演示,用于把草图变成共享的数字迈阿密景观。ComfyUI 里已经提供的 RTX Video Frame Generation 和 RTX Video HDR,则可以把生成片段扩展到每秒 60 帧,并转为高动态范围以便调色。这些都是官方工作流说明,本文没有复现。
Adobe 相关段落还有两条量化宣称:日常 H.264 视频交付周转可加快 50% 以上;Illustrator 原生 Windows on Arm 版本较模拟运行性能最高可提升 30%。这些同样是官方说法,本文未做对比测试。Blender 5.3 将 DLSS 4.5 光线重建接入 Cycles 视口,官方要求使用 Blender 5.3 以及最新的 Game Ready 或 Studio 驱动。
同一篇文章后半还写了在 Microsoft Ignite 宣布的其他更新,例如面向 DGX Station for Windows 的 Windows Server 2028,以及在 Windows ML 中用 llama.cpp 后端运行来自 Hugging Face 的 GGUF 模型。那些是同场信息,不是这台 Spark 迷你机箱子里已经贴好的标配清单,本文不把它们算进购买规格。
对准备下手的人,判断可以收得更短:如果你需要的是一台能把本地模型和常驻代理留下的 Windows 迷你主机,现在应去华硕、戴尔、微星的渠道核对配置、质保和价格;如果你必须先看到统一官方售价或已经开卖的另外三家迷你机,这篇博客还不能帮你完成下单。1200 亿参数、90GB 场景和 4:2:2 实时编辑,也仍只是厂商宣称,真正能不能在你的素材和模型上成立,要等机器到手上再验证。
知识延伸:统一内存为什么被写成卖点
普通独立显卡笔记本常把系统内存和显存分开,本地跑大模型时,首先碰到的往往是显存够不够。RTX Spark 这篇官方介绍反复强调的是至多 128GB 的统一内存,再加上 Grace CPU 与 Blackwell RTX GPU 的组合,把“更大的本地模型”和创意、开发工具放在同一台紧凑电脑里。统一内存并不自动等于“任何 1200 亿参数模型都能流畅对话”,官方写的是能力方向,并且加了“受支持模型”这一限制。本地运行的好处被写成两点:数据可以留在这台机器上,以及避免这些任务的按 token 云费用;一旦工作流被路由到云端模型,费用问题就会重新出现。购买前最实际的对照,仍是三家已开卖品牌的配置页,而不是把同场发布的服务器和开发者框架都算进这一台迷你机。
说明:本文由津滨 AI 借助 AI 辅助检索与起草,并经人工对照英伟达 2026 年 11 月 18 日官方博客核实审校。文中信息图由津滨 AI 根据已核实的官方数字制作,图中均标明“制图:津滨AI / 非实测”,为 AI 辅助生成的概念示意图,并非实拍或官方原图。封面为 typographic 光影卡片,同样为 AI 辅助生成、非实拍。作者未购买或实测任何 RTX Spark 主机,性能数字以官方宣称定期限,售价以各品牌页面为准。
参考资料
[1] RTX Spark 紧凑桌面博客:https://blogs.nvidia.com/blog/rtx-spark-desktop-local-ai-available-now/
