新模型发布最容易被翻成一句“又更快更便宜”。2026 年 11 月 16 日腾讯混元的 Hy4 flash 官方页[1] 里,真正先值得记下的是两件事:官方把标价写进了表,并且明确建议——大多数日常生产力任务用 flash,复杂工作负载继续用 Hy4。
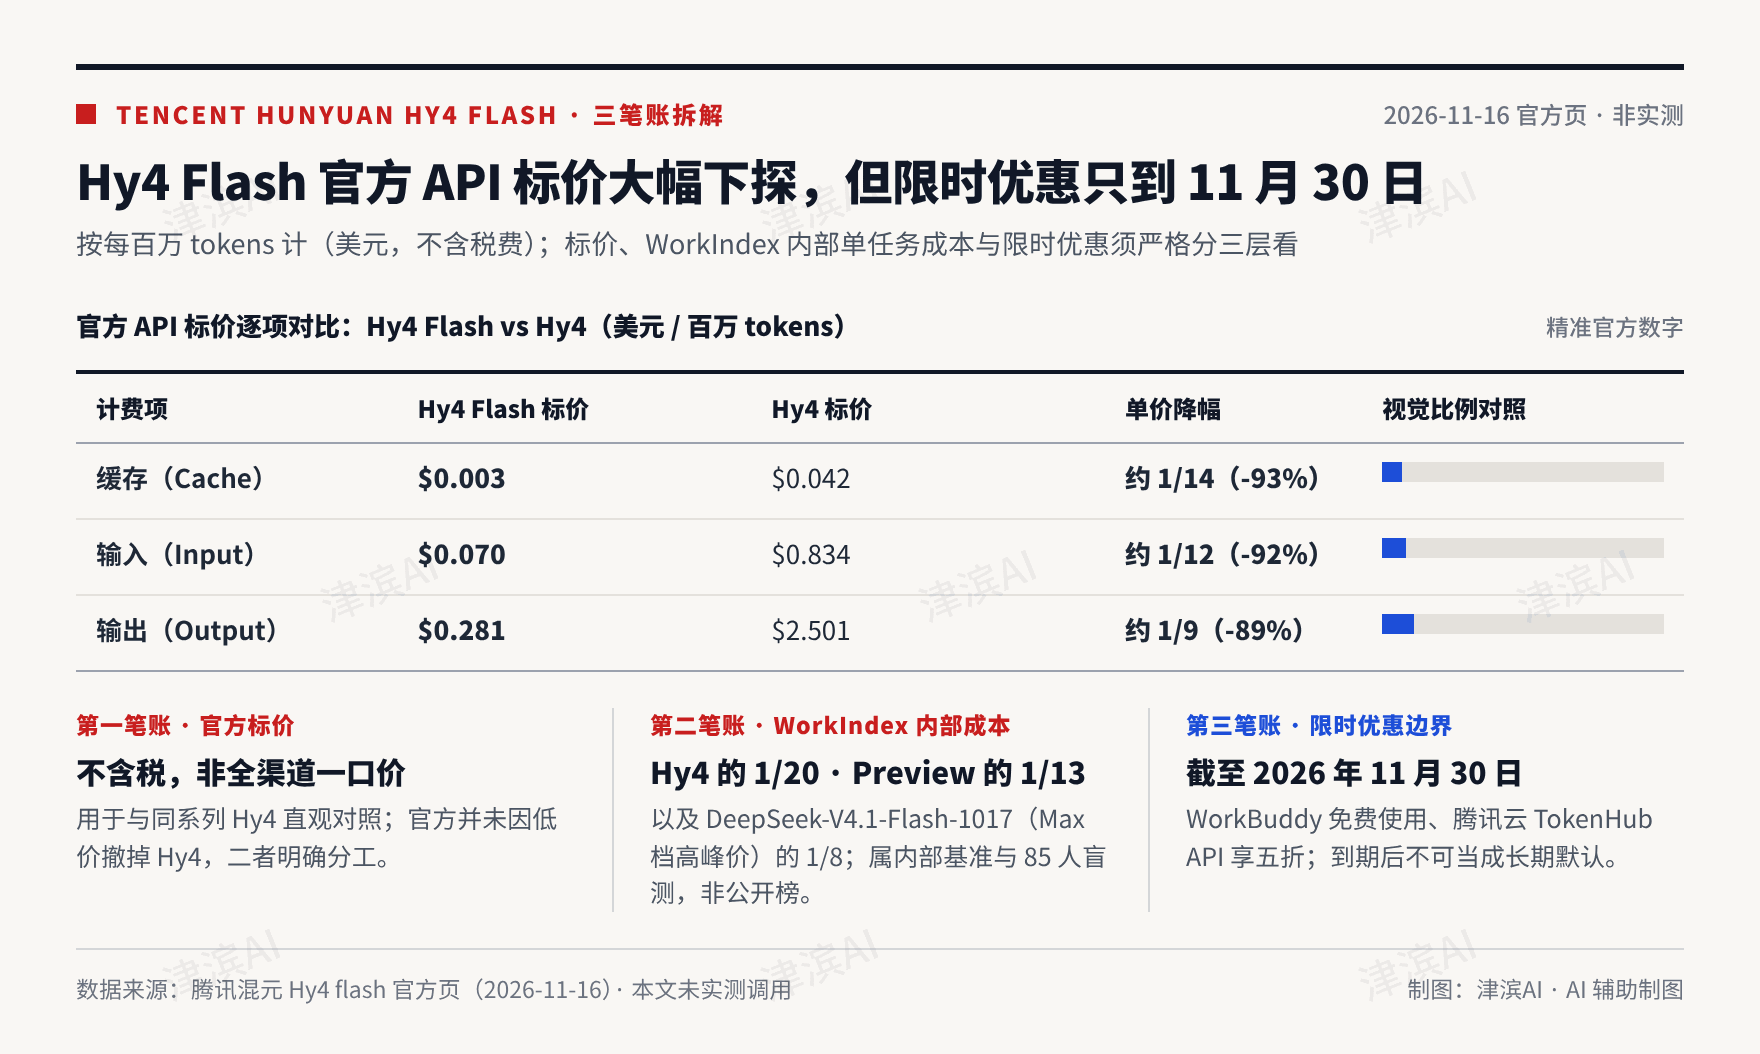
定价按每百万 tokens 计。Hy4 flash 的缓存是 0.003 美元,输入 0.070 美元,输出 0.281 美元;对照表里的 Hy4 则是缓存 0.042 美元、输入 0.834 美元、输出 2.501 美元。这是官方标价,不含税费,也不等于你在每一个渠道、每一个时段实际扣费都与此完全相同。但它已经足够用来做第一层对照:flash 被放在更低单价的位置上,并不是把 Hy4 从产品线里撤掉。
截至 2026 年 11 月 30 日,官方还写了两档限时条件:在 WorkBuddy 里可以免费使用,通过腾讯云 TokenHub 调用 API 可享受五折。过了这个日期,不能把“免费”和“五折”当成长期默认。
规格降的是激活量和缓存,不是把上下文砍掉
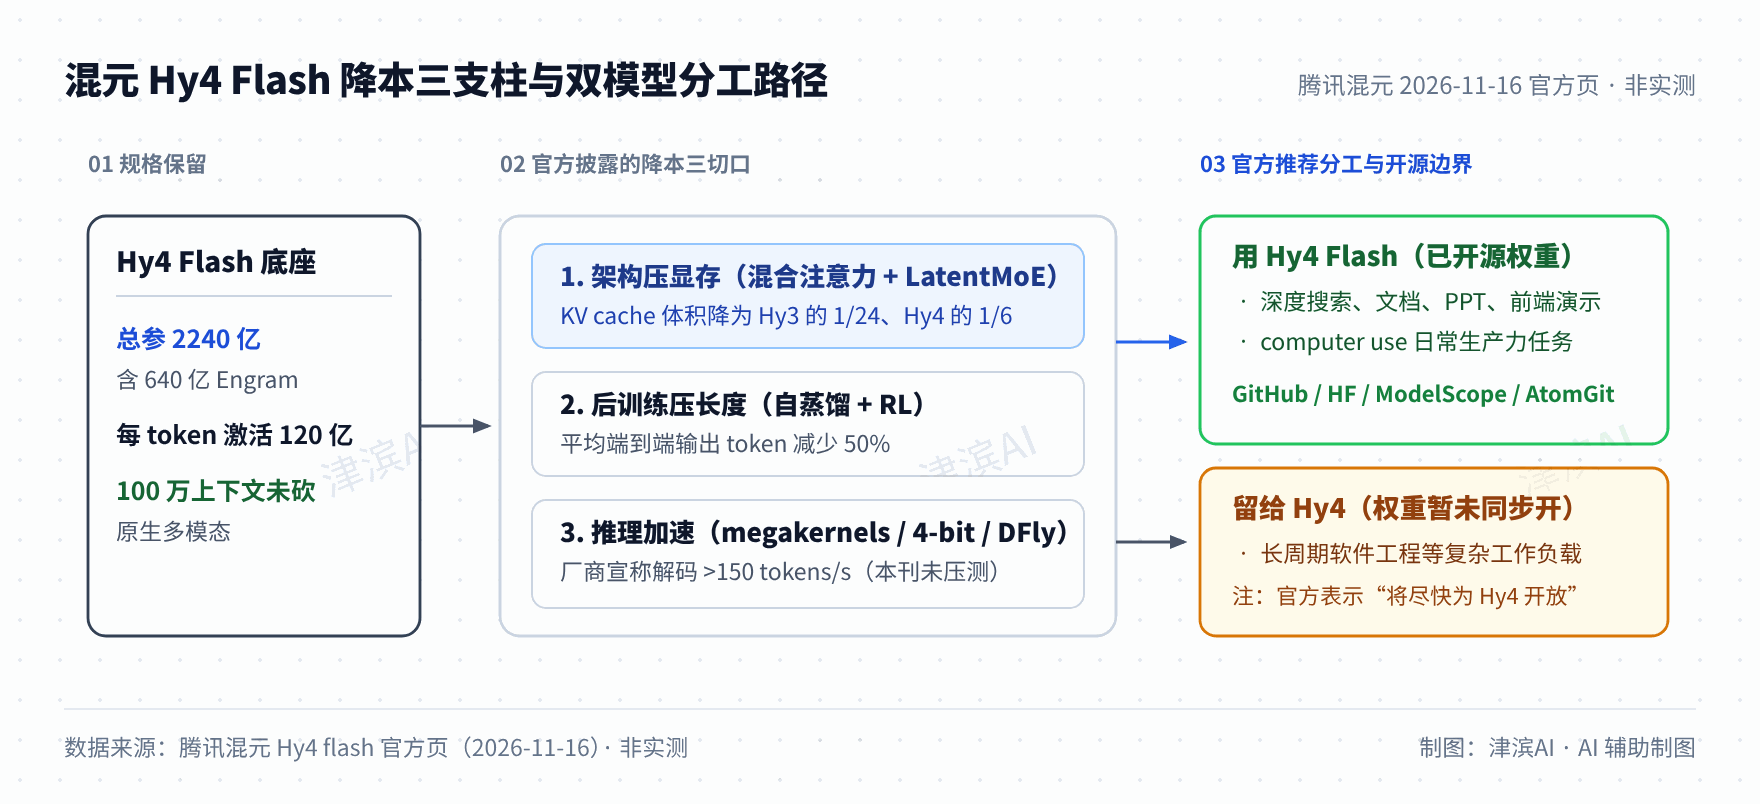
Hy4 flash 被写成迄今性价比最高的 Hy 模型:总参数 2240 亿,其中包含 640 亿 Engram 参数,每个 token 只激活 120 亿。它和 Hy4 一样是原生多模态,上下文窗口同样是 100 万 tokens。也就是说,官方并没有用缩短上下文来换低价,而是把每步激活的参数量和推理成本作为主要切口。
在训练和推理说明里,有三条被用来解释成本为什么能降下去。架构上,它把混合注意力、LatentMoE 和 Engram 结合在一起,把 KV cache 体积降到 Hy3 的 1/24、Hy4 的 1/6。后训练上,先从 Hy4 做自蒸馏,再用强化学习把平均端到端输出 token 减少 50%。服务上,官方宣称结合 megakernels、4-bit 量化和 DFly 等优化,解码速度超过 150 tokens/s。最后这一条是厂商给出的速度声明,本文没有做独立压测。
内部基准可以引用,但不能当成公开榜
官方随后写了一句总括:这些改进使 Hy4 flash 在综合任务表现上略高于 Hy4 preview;在 WorkIndex 上,其单任务平均成本是 Hy4 preview 的 1/13、Hy4 的 1/20,以及 DeepSeek-V4.1-Flash-1017(Max 档、高峰价)的 1/8。
WorkIndex 被明确写成内部基准,任务来自典型的 WorkBuddy 工作,关注交付质量、单轮输出长度和任务周转时间,而不是脱离日常工作的公开榜分数。页面还提到它包含 8 组评测,覆盖做幻灯片等任务。因为这是内部基准,1/13、1/20、1/8 只能作为官方自己的成本对照来读,不能改写成已经由第三方复现的公开结论。与 DeepSeek 的对比还带有 Max 档和高峰价这两个条件,摘掉档位会改变原意。
另一组数字来自盲测:85 名内部 WorkBuddy 用户,259 项任务,覆盖 27 个类别。官方称,Hy4 flash 的用户满意度接近 Claude Haiku 5.5,端到端完成时间最短,单任务成本显著低于其他受测模型。这是内部用户盲测,不是公开招募的第三方评测,也不能外推成所有产品场景的排序。
先从哪里用,权重又开放到了哪
官方列出的使用入口包括腾讯云 TokenHub、WorkBuddy、元宝、企业微信、QQ、ima、Marvis 等,并写明将登陆 OpenRouter,但未给上线日期。具体在你所在地区、所在工作区能否打开,仍以各产品当时页面为准。推荐场景写得比较具体:深度搜索、文档处理、制作幻灯片、简单前端演示和 computer use,属于日常生产力,建议用 flash;长周期软件工程这类复杂工作,则继续建议用 Hy4。
文末还写了一件对想本地部署的人很关键的事:Hy4 flash 的权重现在已经在 GitHub、Hugging Face、ModelScope 和 AtomGit 开放,官方计划持续更新,以提高它在真实工作流中的实用性和效率,并表示将尽快为 Hy4 也开放权重。GitHub 仓库被链到 Tencent-Hunyuan/Hy4-flash。也就是说,开放权重这一句在该页文本里对应的是 flash,不要提前写成 Hy4 已经同样开放。许可证和运行依赖要以仓库和模型卡当时文本为准,本文未逐项复核第三方镜像是否同步。
对大多数读者,选择可以收成两步。先看官方价和 11 月 30 日的优惠边界,再看自己的任务是不是落在官方建议的日常范围。若你的工作主要是长周期、复杂的工程开发,只因为单价更低就全面改用 flash,并不符合官方自己的推荐。内部基准和内部盲测可以用来理解他们为什么这样推荐,却不能代替你在自己的文档、代码和账号里做验证。
知识延伸:标价、内部成本和限时优惠是三笔账
看模型报价时,至少要分三层。第一层是官方按百万 tokens 公布的缓存、输入和输出单价,它方便拿来和同一系列的 Hy4 对照。第二层是内部基准给出的单任务平均成本,例如 WorkIndex 上的 1/13 或 1/20,它依赖任务集、是否算进输出长度,以及对照对象的档位和时段,不能直接换算成你的账单。第三层是限时政策:WorkBuddy 免费和 TokenHub 五折都写到 11 月 30 日为止。把三层混成一句“已经便宜到二十分之一并且永远免费”,就会离开原文。官方把 flash 和 Hy4 同时留在产品线里,本身已经说明低单价不是唯一标准:日常文档、幻灯片和简单演示走 flash,复杂长周期工程仍建议走 Hy4。开放权重则让有能力自建推理的人多了一条路,但它同样首先属于 flash。
说明:本文由津滨 AI 借助 AI 辅助检索与起草,并经人工对照腾讯混元 2026 年 11 月 16 日官方页面核实审校。文中信息图由津滨 AI 根据已核实的官方数字制作,图中均标明“制图:津滨AI / 非实测”,为 AI 辅助生成的概念示意图,并非实拍或官方原图。封面为 typographic 光影卡片,同样为 AI 辅助生成、非实拍。作者未调用 TokenHub 或 WorkBuddy 做复跑,定价与优惠以官方页当时文本为准,内部基准和盲测结果按官方口径转写。
参考资料
[1] Hy4 flash 官方页:https://hy.tencent.ai/research/hy4-flash?langVersion=en
