手里只有一台 24GB 统一内存的 Mac,想用开源模型做 1 分钟以上的中文口播数字人,往往第一步就会被显存卡住。按照开发者麦麦提在 2026 年 11 月 19 日 11:30(北京时间)公开的方案描述,14B 参数量的视频扩散模型在推理时峰值内存占用自称需要 36GB 到 55GB,24GB 统一内存很难直接扛住;但同一台 Mac 却足以稳定运行约 2B 参数量的开源语音模型 VoxCPM2[1][2][3]。
跑不动重型视频扩散,不代表 Mac 只能旁观。
题图:本地负责声音、云端负责画面的概念示意(AI 辅助生成,非实拍,亦非任何产品界面截图)。
解法很干脆,把流水线在物理上拆成两段:本地 Mac 负责合成带呼吸感和自然语调的 48kHz 中文人声,云端大显存 GPU(作者自称使用其称为 Colab G4、96GB 显存的实例,本刊未在公开页面核对到同名 SKU)只负责 Wan2.1-I2V-14B 加 InfiniteTalk 的音频驱动画面渲染[1][4][3]。
怎么安装:本地声音端与云端画面端两份清单
本地 Mac 端只需要准备语音合成和音视频后处理工具。OpenBMB 开源的 VoxCPM2 采用约 2B 参数量、基于 MiniCPM-4 的无分词器扩散自回归架构,支持 30 种语言与原生 48kHz 音频输出(内部 AudioVAE V2 为 16kHz 输入、48kHz 输出),代码与权重均采用 Apache-2.0 许可证[1][2]。官方仓库明确要求 Python 大于等于 3.10 且小于 3.13、PyTorch 大于等于 2.5.0,在 Apple Silicon Mac 上将设备设为 auto 时会自动调用 MPS 加速[1]。
本地环境可直接通过官方命令安装[1][2],再补齐 ffmpeg、soundfile 与 numpy 用于音频导出和后期混流,作者自称从 Hugging Face 拉取 openbmb/VoxCPM2 模型权重约需 6.4GB 本地空间(本刊未复现):
pip install voxcpm soundfile numpy
# macOS 可用 Homebrew 安装 ffmpeg:brew install ffmpeg
云端画面端则围绕阿里通义万相团队于 2025 年 2 月开源的 Wan2.1(含 14B 图生视频 I2V,Apache-2.0)[3],以及 MeiGen-AI 于 2025 年 8 月开源的 InfiniteTalk(基于 Wan2.1 的稀疏帧音频驱动视频框架,Apache-2.0)[4][5],再叠加 LightX2V 团队开源的 4 步蒸馏加速权重(Apache-2.0)[6]。
ComfyUI 跑 InfiniteTalk 现阶段有两条互相独立、切勿混装的生态路线[7][8]:
ComfyUI 官方原生路线:无需安装自定义节点,直接使用内置
WanInfiniteTalkToVideo节点,文本编码器使用 Comfy-Org 重打包的umt5_xxl_fp8_e4m3fn_scaled.safetensors,音频驱动使用model_patches目录下的wan2.1_infiniteTalk_single_fp16.safetensors(单人)或multi版本,搭配Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors、wav2vec2-chinese-base_fp16.safetensors、Wan2_1_VAE_bf16.safetensors与lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors[7][9]。作者采用的 Kijai 包装器路线:云端 ComfyUI 需克隆安装
kijai/ComfyUI-WanVideoWrapper[8]、kijai/ComfyUI-KJNodes(GPL-3.0)[10] 与Kosinkadink/ComfyUI-VideoHelperSuite(GPL-3.0)[11],同时按作者清单补充安装color-matcher和pyloudnorm;主干模型选用 Kijai 的fp8_scaled权重[12][13],作者自称全套 7 个权重文件合计约 26GB(本刊未复现)。
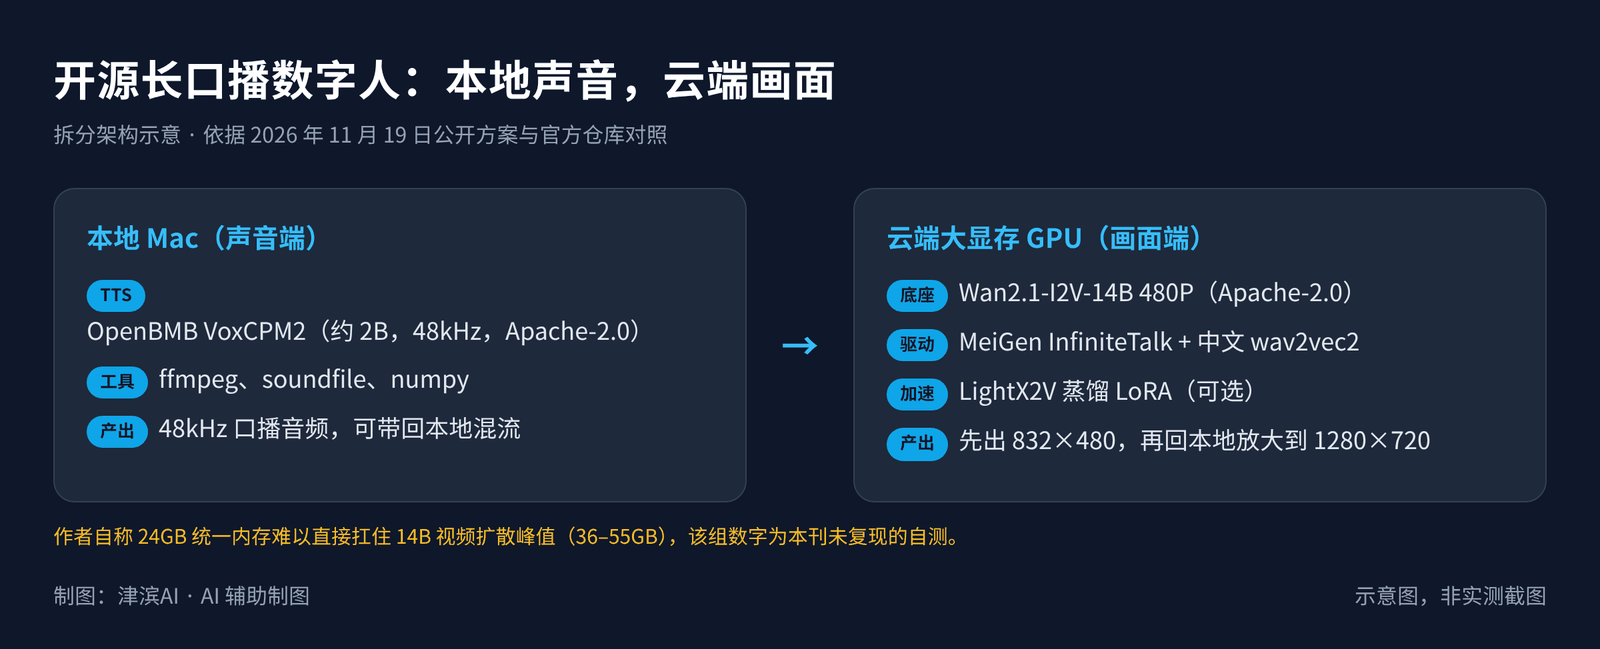
制图:津滨 AI。拆分架构示意(AI 辅助制图,非实拍)。
两条路线的排雷红线:作者在方案中特别提醒,在
ComfyUI-WanVideoWrapper路线里,文本编码器必须选用 Kijai 对应的非scaled版umt5,如果误放了 ComfyUI 官方原生教程里的scaled版umt5,工作流会直接报错;两条路线的 InfiniteTalk 权重文件形态也并不相同,虽然大部分文件名看上去几乎一致,但切勿交叉混用[7][8]。
再顺手标一个版本兼容坑:作者提到在 transformers 5.x 环境下,Wav2Vec2Encoder 默认不再返回中间隐藏层特征,会导致 MultiTalkWav2VecEmbeds 节点报 NoneType 错误,其个人做法是对 wav2vec2.encoder.layers 挂载 register_forward_hook。由于本次核对未能在官方仓库 issue 中独立锁定对应的具体小版本号,本文不把未核验的完整补丁代码当作标准修法,仅作为排雷提示:遇到同类报错时,先对照当前 ComfyUI-WanVideoWrapper 文档与环境里的 transformers 版本再处理[8]。
怎么部署:持久化缓存、热同步与单管线隔离
云端按小时计费的 GPU 实例一旦会话重置,几十 GB 模型全部丢失;如果每次开机都从 Hugging Face 重下权重,大半租机费就烧在进度条上。
麦麦提给出的做法是“一次下载、云盘归档、开机热同步”:首次利用 aria2c 多线程拉齐云端全套权重后,直接备份进个人 Google Drive;之后每次新建云端会话,作者自称通过 Drive v3 API 把权重拷到云端本地 /content/fast_wan_models(作者自称约 90 到 110 秒完成同步,本刊未复现),再软链接到 ComfyUI 对应的 models/ 子目录(如 diffusion_models、text_encoders、vae、loras 等,目录结构可对照 ComfyUI 官方教程)[7][8]。
同步完权重,在作者所称的 96GB 大显存实例上,用下面两组命令拉起挂载了 ComfyUI-WanVideoWrapper 的 ComfyUI 服务与 cloudflared 临时 HTTPS 隧道[7][8]:
# 1. 在云端 ComfyUI 根目录启动服务(仅监听本地回环)
python3 main.py --listen 127.0.0.1 --port 8188 --highvram --disable-mmap

# 2. 另开终端暴露临时 HTTPS 入口
cloudflared tunnel --url http://127.0.0.1:8188
部署阶段有两条容易踩坑的工程纪律。第一条,按照作者建议,数字人这一条 ComfyUI-WanVideoWrapper 管线应当与日常使用的其他视频工作流分开独立目录存放,避免别的插件升级 transformers 或依赖库后连带破坏口播环境[8]。第二条,cloudflared 提供的临时公网地址在开启期间外部可访问,切勿把它当成长期稳定的公网服务长期挂着,跑完立刻关掉进程。
怎么使用:三步闭环与官方等价步骤
麦麦提在 2026 年 11 月 19 日公开的文章里提到三个本地脚本名(step1_synth_voice.py、step2_boot_g4_infinitetalk.py、step3_render_infinitetalk.py),但本次核查未在公开仓库找到这些脚本源码。既然拿不到作者私有脚本,按相同三步换成官方接口与标准工具,照样能接成完整工作流[1][7]。
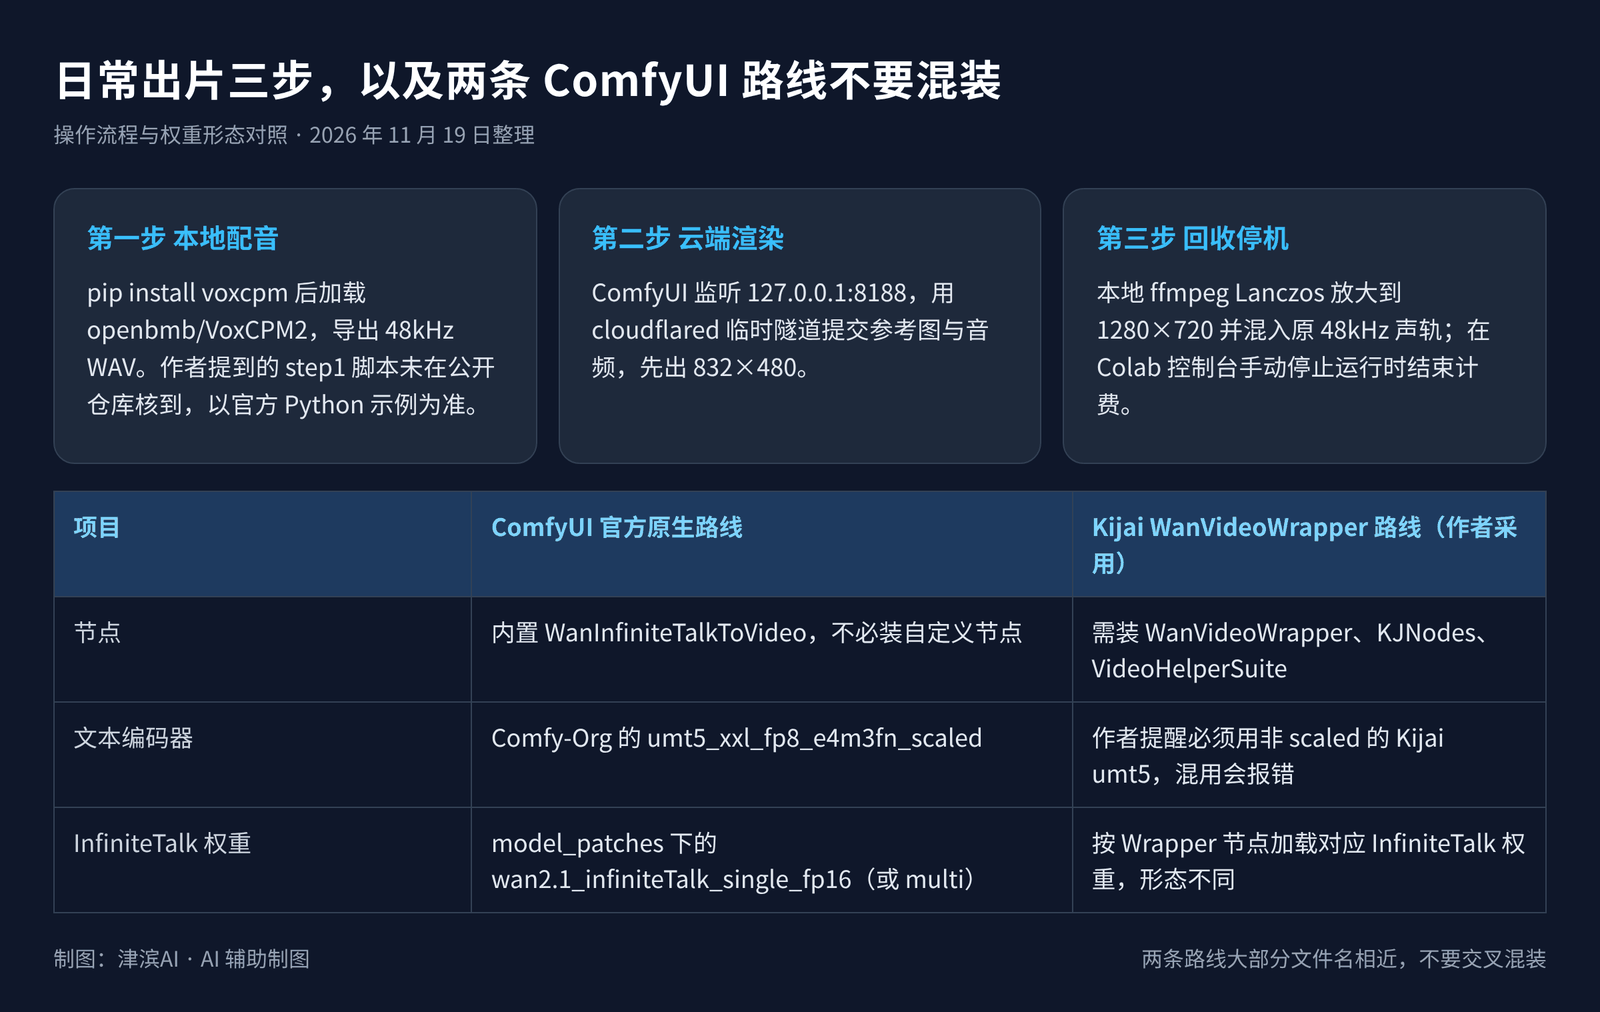
制图:津滨 AI。操作步骤与路线对照示意(AI 辅助制图,非实拍)。
第一步,在 Mac 本地合成 48kHz 配音。 安装 voxcpm 后,参考 OpenBMB 官方 Python 示例加载 openbmb/VoxCPM2 并生成 WAV 音频,如需保留固定说话人音色,可传入 reference_wav_path(或同时传入 prompt_wav_path 与对应文本 prompt_text 开启高保真复刻)[1][2]。作者自测称,本地合成一段 40 秒的中文口播大约耗时 1 分钟(本刊未复现):
from voxcpm import VoxCPM
import soundfile as sf

model = VoxCPM.from_pretrained("openbmb/VoxCPM2", load_denoiser=False)
wav = model.generate(
    text="这里填入改写成口语节奏的中文讲稿。",
    reference_wav_path="speaker.wav",
    cfg_value=2.0,
    inference_timesteps=10,
)
sf.write("voice_48k.wav", wav, model.tts_model.sample_rate)
第二步,在云端 ComfyUI 渲染 832×480 视频。 将人物参考图(正面或微侧、面部清晰)和本地生成的 voice_48k.wav 传入云端工作流。无论是原生 WanInfiniteTalkToVideo 路线[7],还是 Kijai 包装器路线(其 fp8_scaled 模型卡测试也使用过 832×480×81 规格)[12],输出先锚定 480p 档位以控制扩散开销。作者自测称,渲染一段 37.7 秒的视频耗时 584 秒(约 9.7 分钟),跑通一条 1 分钟成片的端到端总耗时约 15 到 20 分钟(均为作者自测,本刊未复现)。
第三步,拉回本地放大混流,并手动停止云端计费。 将云端生成的 832×480 视频下载回 Mac,用本地 ffmpeg 以 Lanczos 算法放大到 1280×720,并把第一步本地保真的 48kHz 原声重新混流进去,避免经过云端压缩后音质受损[1]:
ffmpeg -i cloud_480p.mp4 -i voice_48k.wav \
  -vf "scale=1280:720:flags=lanczos" \
  -map 0:v:0 -map 1:a:0 -c:v libx264 -crf 18 -c:a aac -b:a 192k \
  final_720p.mp4
跑完导出后,务必回到 Google Colab 网页控制台手动停止并断开(或删除)当前运行时(Runtime),彻底结束 GPU 计费;谷歌官方并不存在一键自动停账的命令行指令,别指望敲一行终端命令停账。
怎么控制:四组核心参数,先看官方默认再动手
能出画面不难,难的是口型咬住中文语流、面部不漂移也不发暗。作者重点拧了四组参数,每一组先把官方默认摆出来,再看作者怎么调:
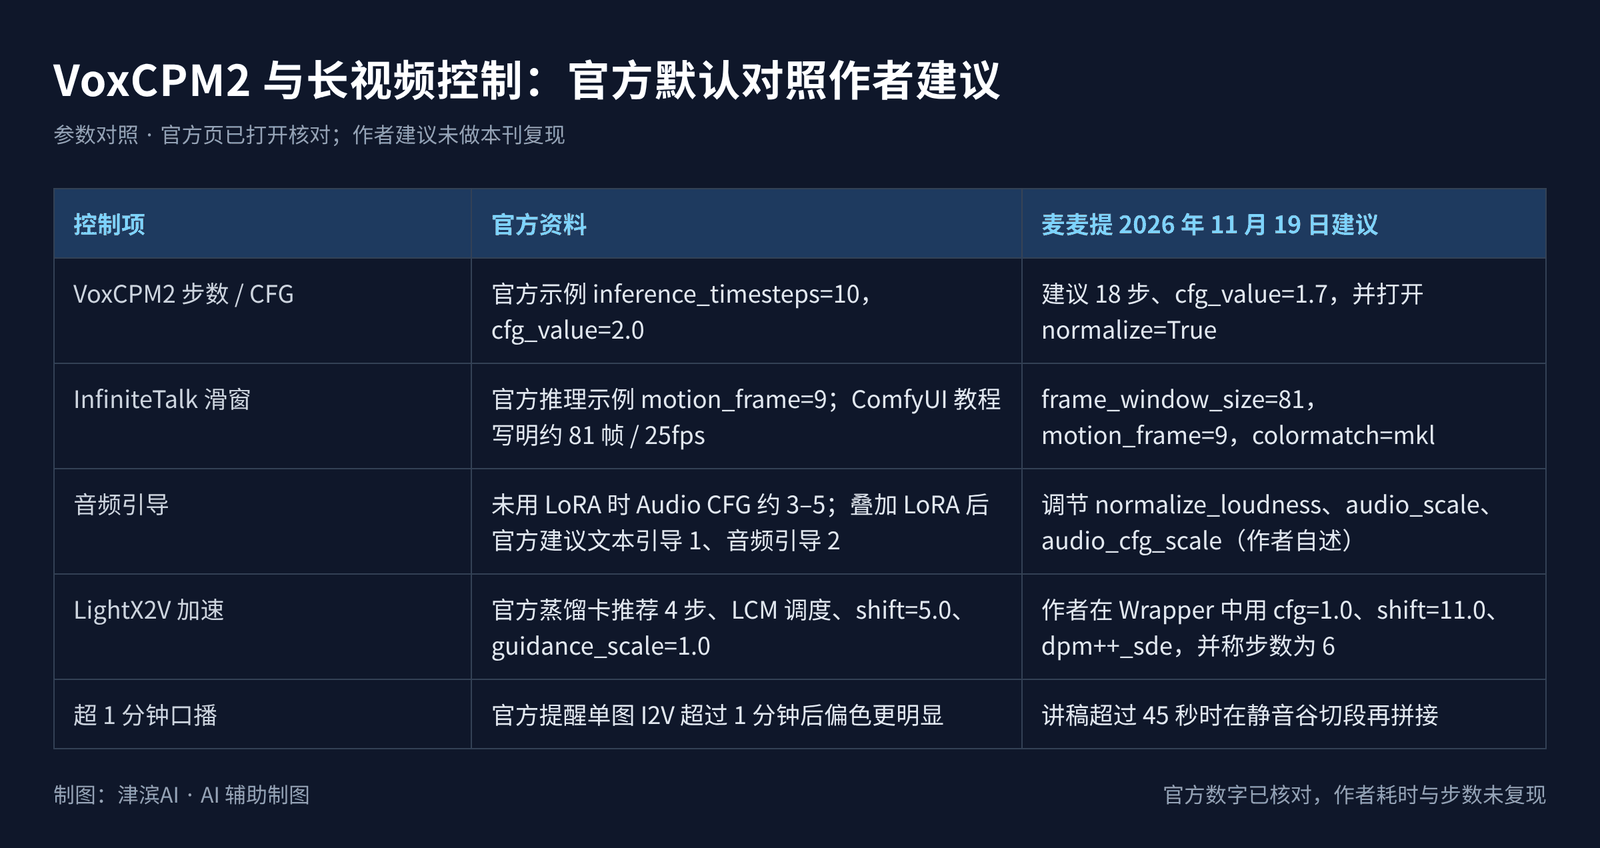
制图:津滨 AI。参数对照示意(AI 辅助制图,非实拍)。
语音合成参数(VoxCPM2):OpenBMB 官方 README 与模型卡示例代码给出的是
inference_timesteps=10、cfg_value=2.0(官方页并非“默认 8 步”)[1][2];麦麦提在自己的中文口播场景里,则建议调成inference_timesteps=18、cfg_value=1.7并打开normalize=True,同时先用参考音频锁住声线,把书面长句改写成带自然气口的口语稿(作者建议未经过本刊盲听对比,建议先用官方10 / 2.0跑一版基线再微调)。音频驱动强度(
MultiTalkWav2VecEmbeds):作者会调节normalize_loudness、audio_scale与audio_cfg_scale来平衡嘴型张合幅度与微表情(如露齿、挑眉、轻微歪头)。对照 MeiGen-AI 官方仓库的使用提示:不使用加速 LoRA 时,Audio CFG 通常在 3 到 5 之间表现较好;一旦叠加加速 LoRA,官方建议将文本引导sample_text_guide_scale降至 1、音频引导sample_audio_guide_scale设为 2[4]。滑窗、色彩保持与长视频切段:作者配置滑窗参数
frame_window_size=81、motion_frame=9、colormatch=mkl,同时配合提示词与CLIPVision的strength=1.0锁住人物外貌一致性。这组数字能在官方资料里找到对应锚点:InfiniteTalk官方推理命令同样使用--motion_frame 9[4],ComfyUI 官方教程也标明每次扩展窗长约为 81 帧(按 25fps 换算约 3.24 秒)[7]。不过InfiniteTalk官方自己也明确提醒,单图 I2V 超过 1 分钟后色彩偏移会变明显[4]。麦麦提给出的实操经验是,讲稿一旦超过 45 秒,就提前在音频的静音谷处切段分别生成,再在本地拼成完整长片。LightX2V 蒸馏加速与显存策略:
LightX2V官方模型卡说明其 Wan2.1 I2V 14B 480P 蒸馏模型可在 4 步且无 CFG(guidance_scale=1.0)下推理,官方推荐搭配LCM调度器与shift=5.0[6]。作者在WanVideoWrapper工作流加载该 LoRA 后,使用的是cfg=1.0、shift=11.0与dpm++_sde调度器,并称采样步数为 6 步,同时自测称不开加速 LoRA 渲染速度会慢约 4 倍(步数与耗时均为作者自述,本刊未复现)。由于其云端环境为高显存规格,配合--highvram启动即可省去模型块置换(block swap)带来的开销[8]。
这套拆法什么时候该用,什么时候不必折腾
把账算到这儿,判断很直接:对于只有 24GB 统一内存 Mac、又需要制作 1 分钟以上中文口播数字人的创作者而言,把声音留在本地、把 14B 视频扩散放到大显存云端,比在单台机器上硬扛显存溢出或极低速置换更稳。[1][4][3]
但这个判断在两个条件下不成立:其一,如果你的桌面工作站或内网服务器已经配有 48GB 以上显存、能够常驻 14B 权重的独立 GPU,拆到 Colab 反而多出云盘同步与隧道联调的麻烦;其二,如果你日常只需要几秒到十几秒的短口播切片,直接套用 ComfyUI 官方原生单段模板即可完成,没必要上滑窗切段和跨端流水线[7]。
还有一道合规底线不能省:VoxCPM2、Wan2.1、InfiniteTalk 与 LightX2V 均采用允许商用的 Apache-2.0 许可证[1][5][3][6],但代码和模型权重的开源许可并不等于获得了任意真人的肖像权与声音授权。用于对外发布的数字人视频,必须确保参考图片与参考音频均来自明确授权的本人或合规合成音色。
知识延伸:为什么原生工作流与 Wrapper 路线看着像,一混装就报错
刚上手 ComfyUI 视频工作流时很容易纳闷:既然 ComfyUI 官方教程里的主模型文件名 Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors 本身就是 Kijai 提供的,为什么不能和 ComfyUI-WanVideoWrapper 里的其他模型文件混着放?[7][12]
原因在于两套前端节点对模型张量格式和挂载接口的约定不同:
文本编码器缩放方式不同:ComfyUI 原生节点适配的是
Comfy-Org重新打包的scaled量化版umt5_xxl_fp8_e4m3fn_scaled.safetensors[7],而WanVideoWrapper的文本加载逻辑对应未做该缩放重打包的原始/Kijai 版umt5,强行互换会在前向计算缩放因子时直接报错[8]。InfiniteTalk 权重封装形态不同:原生工作流通过内置
ModelPatchLoader读取wan2.1_infiniteTalk_single_fp16.safetensors这类 patch 文件并接入WanInfiniteTalkToVideo节点[7];Wrapper 路线则是按自身节点规范直接加载对应的 InfiniteTalk 权重与音频嵌入节点[8]。长视频防偏色的社区取舍:
InfiniteTalk官方仓库还提示过另一条细节——同为加速 LoRA,FusionX LoRA虽然能提速,但在超过 1 分钟的长视频里会加剧色彩漂移并削弱人物 ID 一致性[4];官方仓库甚至另备了convert_img_to_video.py工具,通过给单图加入轻微推拉平移来缓解超 1 分钟后的画质衰退[4]。这也解释了为什么在长口播场景里,作者宁可把单段压在 45 秒以内、用LightX2V配mkl色彩匹配,也不盲目拉满单镜连续时长[6]。
跑第一条测试片时,先按官方示例的 inference_timesteps=10、cfg_value=2.0 录一段 15 秒左右的中文语音试水,确认选定路线的权重和节点没混装报错,再按静音谷切长稿、上云端批跑;最后记得关掉隧道并手动停掉 Colab 运行时[1][7][8]。
说明:本文由 津滨 AI 借助 AI 辅助检索与起草,并经人工逐条核对 OpenBMB/VoxCPM、MeiGen-AI/InfiniteTalk、Wan-Video/Wan2.1、ComfyUI 官方教程、LightX2V 及 Kijai 相关开源仓库原文审校;文内配图为 AI 辅助生成概念示意,非实拍。文中提及麦麦提公开方案里的耗时、容量、脚本名与调参建议均为作者自述,本刊未做独立复现,请读者结合自身硬件环境与肖像声音授权边界谨慎验证。
参考资料
[1] GitHub - OpenBMB/VoxCPM 官方仓库:https://github.com/OpenBMB/VoxCPM
[2] openbmb/VoxCPM2 模型卡 | Hugging Face:https://huggingface.co/openbmb/VoxCPM2
[3] GitHub - Wan-Video/Wan2.1 官方仓库:https://github.com/Wan-Video/Wan2.1
[4] GitHub - MeiGen-AI/InfiniteTalk 官方仓库:https://github.com/MeiGen-AI/InfiniteTalk
[5] MeiGen-AI/InfiniteTalk 模型卡 | Hugging Face:https://huggingface.co/MeiGen-AI/InfiniteTalk
[6] lightx2v/Wan2.1-I2V-14B-480P-StepDistill-CfgDistill-Lightx2v 模型卡 | Hugging Face:https://huggingface.co/lightx2v/Wan2.1-I2V-14B-480P-StepDistill-CfgDistill-Lightx2v
[7] Wan2.1 InfiniteTalk in ComfyUI 官方教程:https://docs.comfy.org/tutorials/video/wan/wan-infinitetalk
[8] GitHub - kijai/ComfyUI-WanVideoWrapper 官方仓库:https://github.com/kijai/ComfyUI-WanVideoWrapper
[9] Kijai/wav2vec2_safetensors 模型仓 | Hugging Face:https://huggingface.co/Kijai/wav2vec2_safetensors
[10] GitHub - kijai/ComfyUI-KJNodes 官方仓库:https://github.com/kijai/ComfyUI-KJNodes
[11] GitHub - Kosinkadink/ComfyUI-VideoHelperSuite 官方仓库:https://github.com/Kosinkadink/ComfyUI-VideoHelperSuite
[12] Kijai/WanVideo_comfy_fp8_scaled 模型卡 | Hugging Face:https://huggingface.co/Kijai/WanVideo_comfy_fp8_scaled
[13] Kijai/WanVideo_comfy 模型仓 | Hugging Face:https://huggingface.co/Kijai/WanVideo_comfy