折腾过本地编码 Agent 的同行,多半都在深夜干过同一件苦差事:一套在闭源大模型上跑得顺风顺水的脚手架(Harness),一旦为控成本或代码不出内网切回开源模型,终端瞬间变成翻车现场。补丁行号漂移、Bash 参数漏引号、遇到报错不看日志原地打转,生生把 100 步调用预算耗光交白卷。大伙以往的惯性动作是回头拆脚手架:往系统提示词里塞几百行格式禁令,再写一摞兼容 XML 与 JSON 的正则解析补丁,结果每换一款开源权重就得推倒重来。
2026 年 11 月 20 日,Hugging Face 工程师 Lewis Tunstall 团队发表官方博客《Introducing harness adapters: adapt your favorite model to your harness to improve performance and cost》,给出了让一线研发顿感解气的反向解法:别再拆生产级脚手架去迁就模型了,冻结基座权重,训一枚轻量级 Harness Adapter,让模型主动适配你的工具协议。同一天,Thinking Machines Lab 开源了约 20GB 体积的端侧多模态循环模型 Inkling 2 Mini,再配上截至 2026 年 11 月 20 日登上 GitHub 趋势榜的三款工程利器,一套周末就能在工作站搭起的本地 Agent 工具箱已经齐备。
一、把原装脚手架装进强化学习回路:涨分又省一半调用
通用开源模型出厂追求泛化对话表现,并未针对你手头特定脚手架的上下文裁剪策略和 Diff 协议做过专门打磨(例如 Pi 默认不保留历史推理轮次,而 OpenCode 与 Hermes Agent 会把过往推理一并留存)。
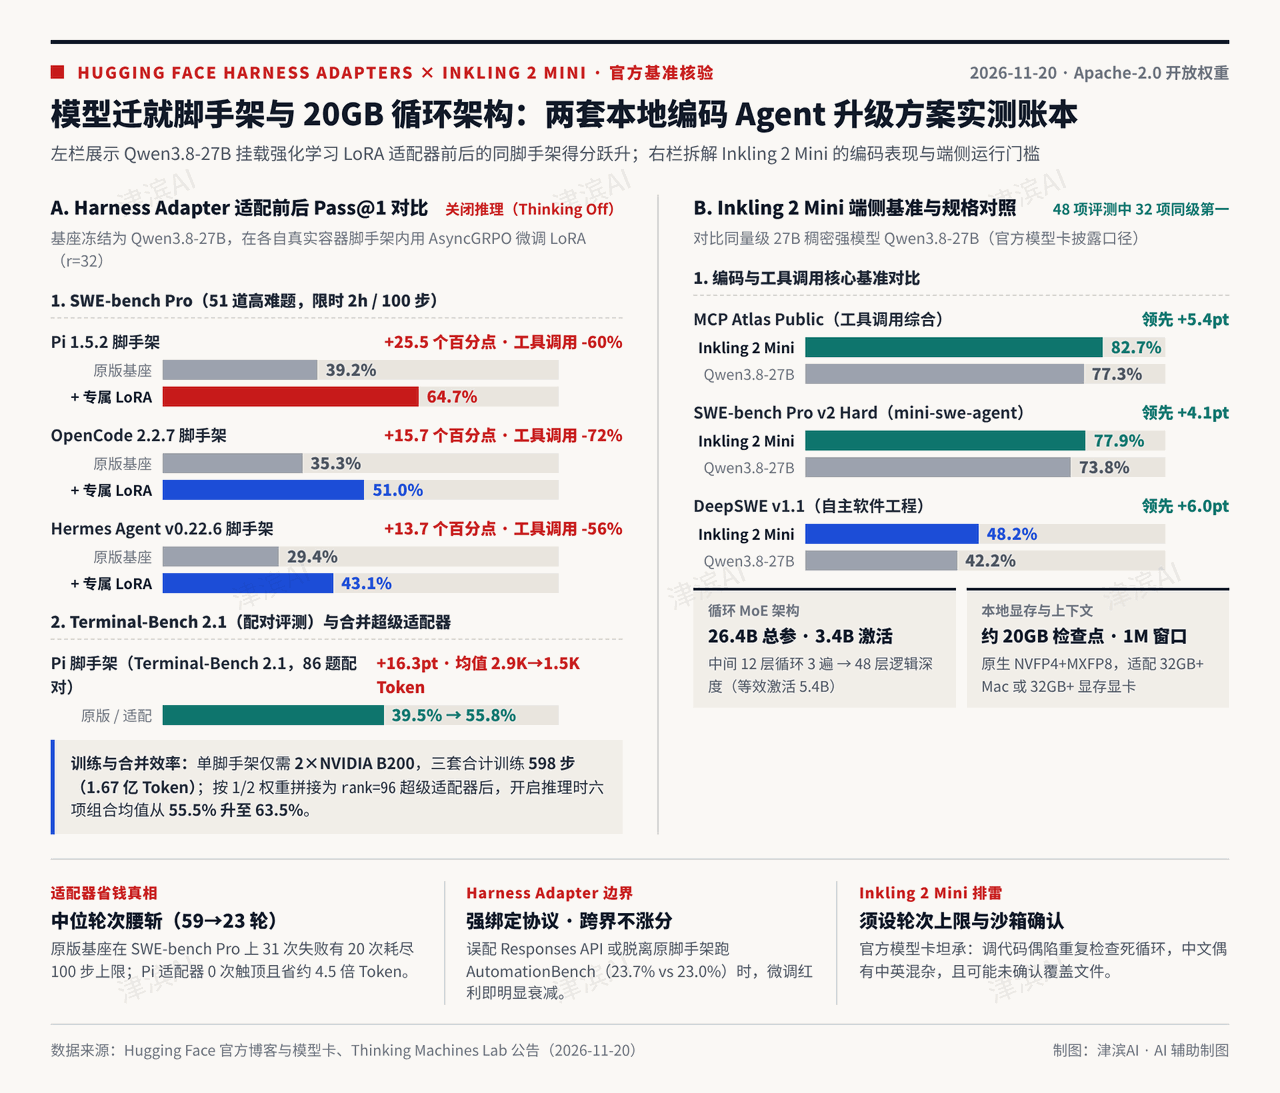
Hugging Face 拿 Qwen/Qwen3.8-27B 算了一笔硬账。在关闭推理(thinking off)的同等条件下,原版基座配 Pi 跑 Terminal-Bench 2.1 得分仅 39%,单题平均消耗 2.9K Token。挂上专属 LoRA 适配器 Qwen3.8-27B-pi-adapted 后,Pass@1 跃升至 55%(配对口径提升 16.3 个百分点),单题消耗砍半至 1.5K Token,共同解出题目的中位交互轮次从 18 轮压到 8 轮。
放到更啃硬骨头的 SWE-bench Pro(51 道高难题,限时 2 小时、上限 100 步)上,反差更为直观:
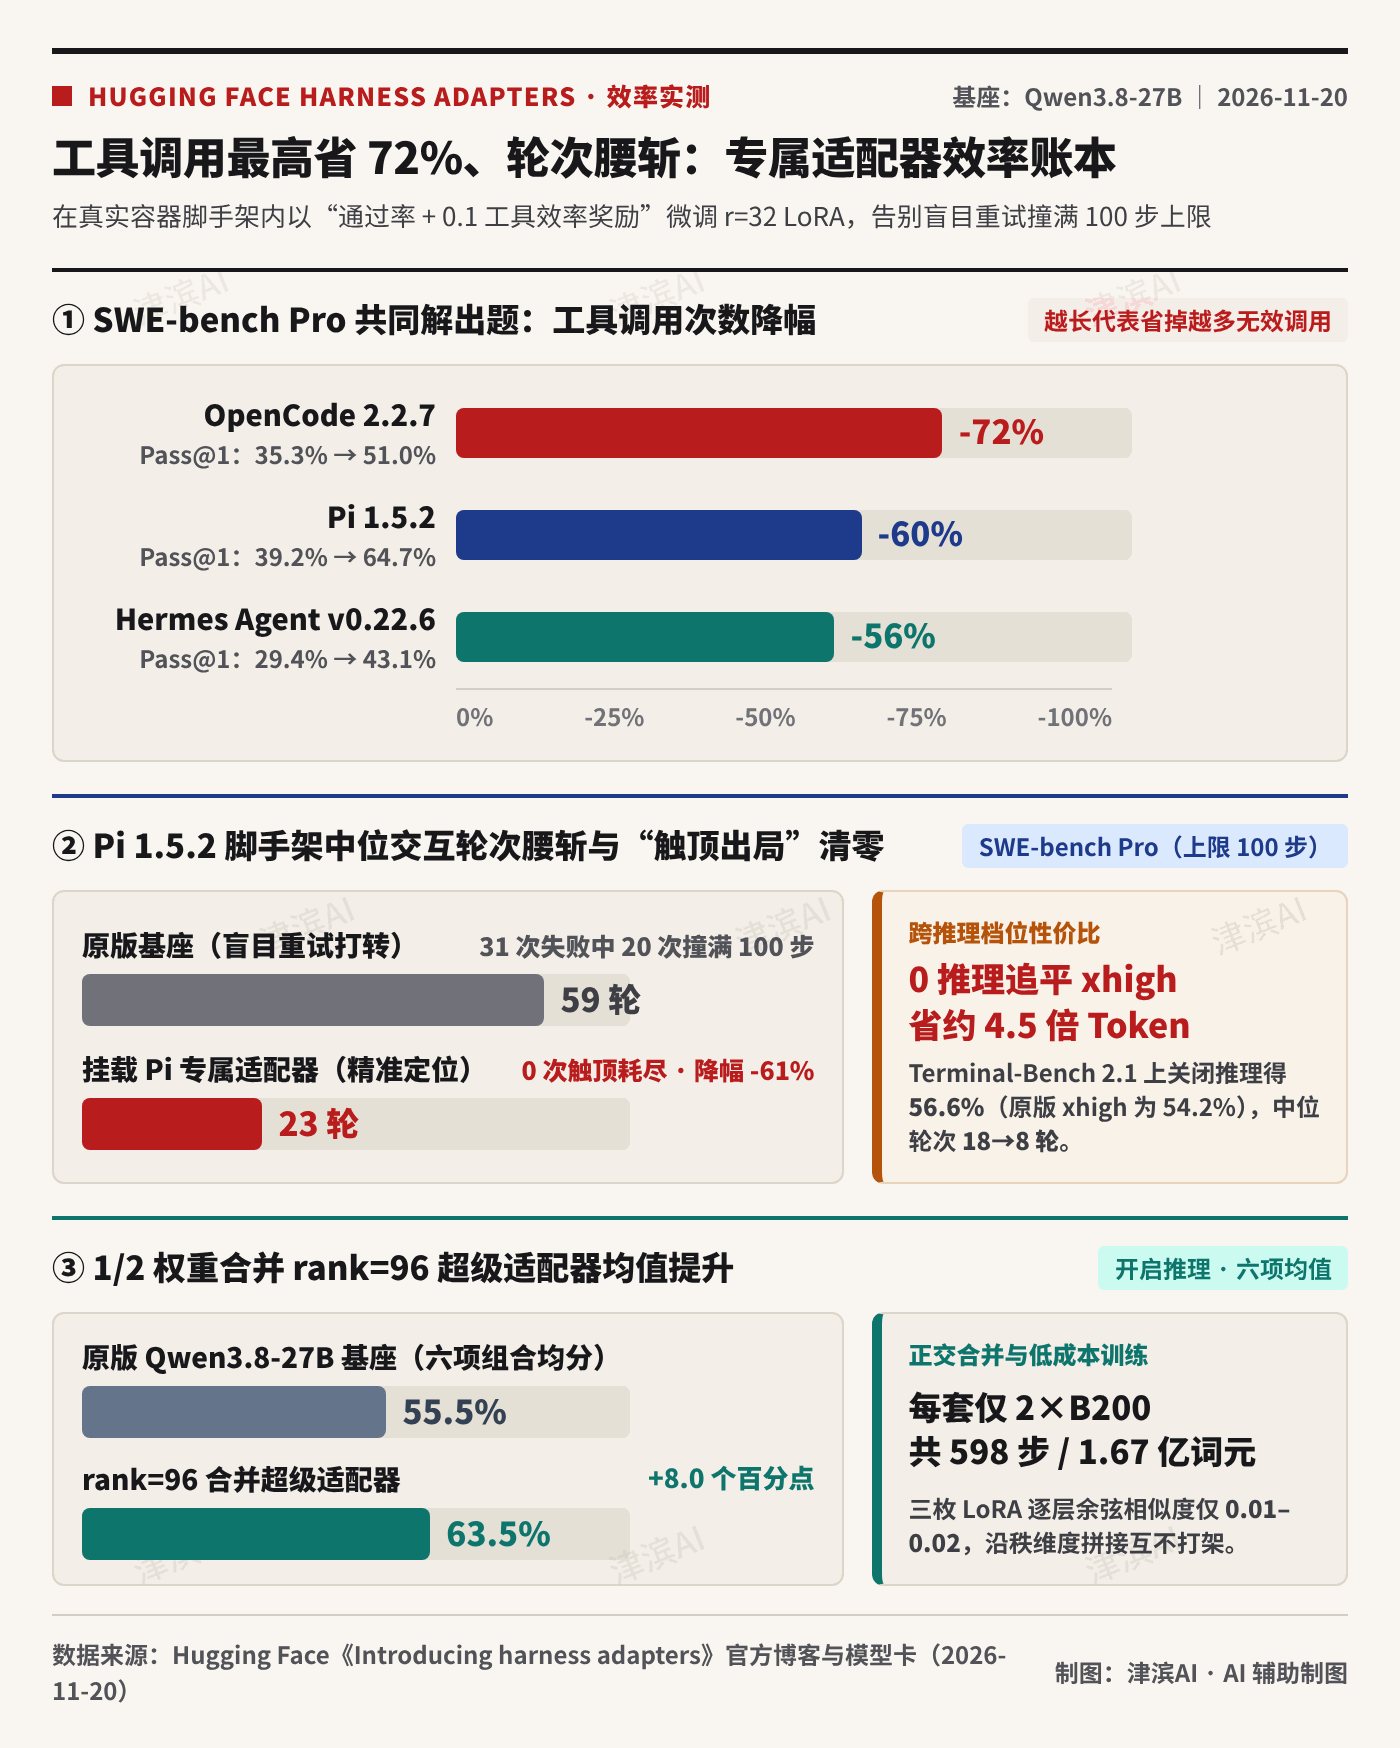
Pi 1.5.2脚手架:得分从 39.2% 飙升至 64.7%(+25.5 个百分点,中位轮次从 59 轮降到 23 轮)。原版基座在 31 次失败尝试中有 20 次因盲目搜索重试撞满 100 步上限出局,挂载适配器后触顶耗尽次数直接归零。OpenCode 2.2.7与Hermes v0.22.6同步涨分:两套脚手架挂载专属适配器后,得分分别提升 15.7 个百分点(达 51.0%)与 13.7 个百分点(达 43.1%),完整适配前后得分对照见图 1。- 调用次数与 Token 开销锐减:在共同解出题目上,三套脚手架的工具调用次数缩减 56% 至 72%(见图 2)。不开启推理的
Pi适配器在Terminal-Bench 2.1上甚至以 56.6% 追平开启xhigh最高强度推理的原版基座,生成 Token 量却节省约 4.5 倍。
这套配方最务实的地方,是避开了“在强化学习框架里重写简化版 Agent 循环”的传统弯路。团队基于 OpenEnv、Harbor 与 TRL AsyncGRPOTrainer 把原装脚手架直接打进容器镜像,通过 vLLM 前置代理原样捕获真实产出的每一个 Token,用“验证器通过率 + 0.1 工具效率奖励”微调 r=32 的 LoRA(训练中接入 safeagents 插件拦截了 647 次越界动作)。候选数据先过 openenv validate 四项语义体检,再经基座试跑剔除全对题与全错题,只保留有梯度信号的有效仓库题与 TermGrade 终端题。
训练账单同样轻量:每个脚手架仅用 2 张 NVIDIA B200 GPU(推理与训练各占 1 卡),三套合计训练 598 步、消耗 1.67 亿 Token。因三枚适配器的逐层更新余弦相似度仅 0.01 至 0.02(近乎正交),按 1/2 权重沿秩维度拼接的 rank=96 超级适配器在开启推理时将六项组合均分从 55.5% 推高至 63.5%(见图 2),团队同步上线了社区对比看板 Harness Leaderboard。
二、单机 32GB 内存怎么玩?Inkling 2 Mini 的 20GB 循环方案
要是手头没有双卡服务器跑 27B 稠密模型,只想在本地 32GB 内存的 MacBook 或单张显卡上挂一个能看图、能改代码的常驻助手,2026 年 11 月 20 日由 Thinking Machines Lab 发布的 Inkling 2 Mini(Hugging Face 模型卡,Apache-2.0 协议)刚好补上了这块端侧拼图。
它采用了稀疏 MoE 循环 Transformer(Looped Transformer) 架构:物理总参数 26.4B(24 层解码器,每层从 128 个专家中激活 8 个,单次激活 3.4B),承担核心抽象推理的中间第 6 至 17 层会共享权重连跑 3 遍,靠门控跨轮消息逐轮精炼计算,相当于用 24 层存储权重跑出 48 层逻辑深度(单 Token 等效激活 5.4B)。前 20 层专家权重原生采用 NVFP4(4-bit)训练部署、最后 4 层采用 MXFP8(8-bit),零后量化折损的完整单检查点仅约 20GB,支持最长 100 万(1M)Token 上下文与原生图像输入,在 32GB 及以上统一内存的 Apple Silicon 设备(支持 MLX 与 llama.cpp 的 IQ4_NL / Q8_0 量化包)或同级显卡上均可本地直跑,服务端搭配 SGLang 的三层 DSpark 投机采样模块还能进一步提速。
在与 Gemma 4 31B、Qwen3.8-27B 等同级模型的 48 项横评中,Inkling 2 Mini 拿下 32 项第一,其中工具调用综合基准 MCP Atlas Public 达 82.7%、SWE-bench Verified 达 79.2%、SWE-bench Pro v2 Hard 达 77.9%(关键基准分项见图 1),斯坦福团队在 NVIDIA DGX Spark 实测其每焦耳智能能效比达 0.703(对比 Qwen3.6-35B-A3B 的 0.430)。
三、动手前先排三颗暗雷:配齐开源“手脚”与“刹车”
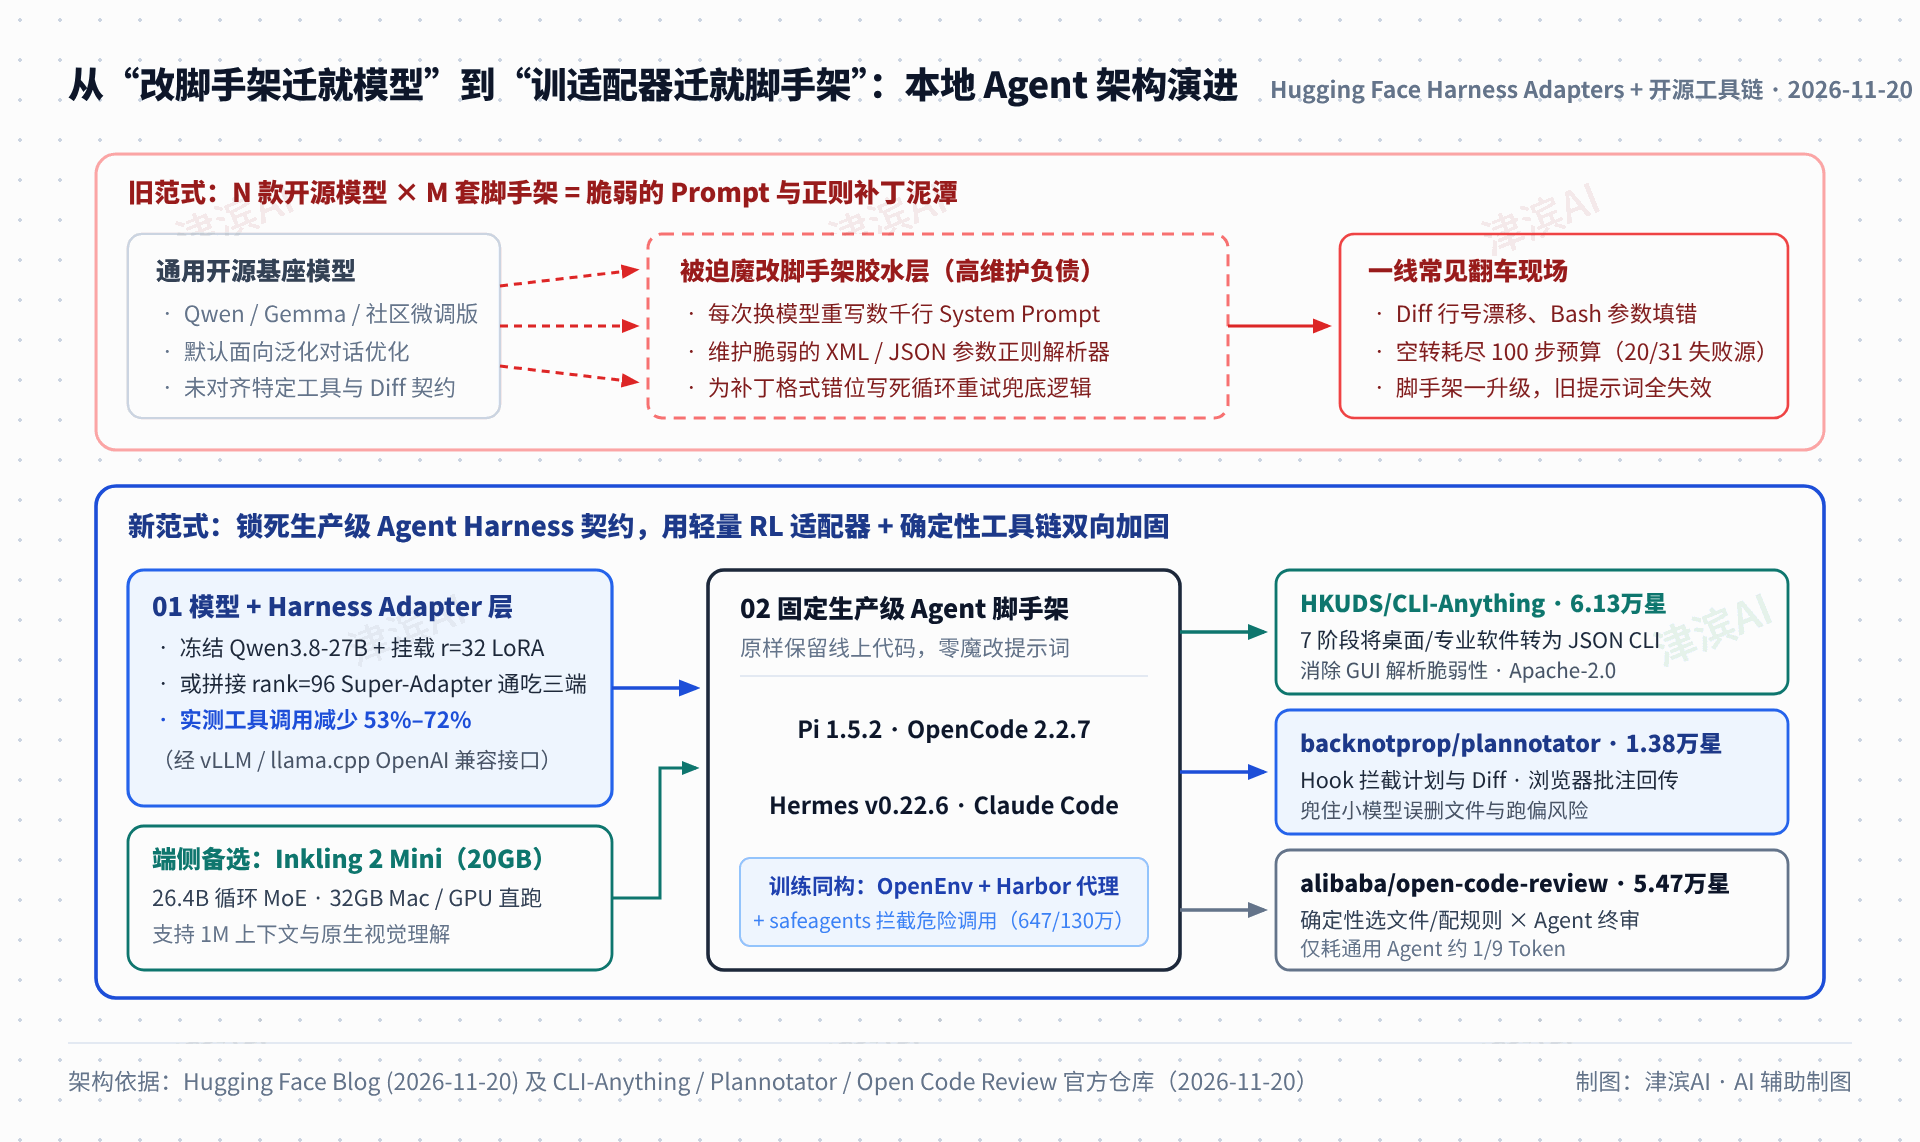
把这两套新工具摆上桌面,可以立下一条供同行检验的选型判断:落地内部编码 Agent 时,最划算的投入是先锁死一套成熟生产脚手架的接口契约,再用轻量强化学习适配器或确定性外围工具让模型迁就脚手架,别再跟着每周上新的基座反复重写提示词。
当然,若团队尚无固定脚手架,或跑的是脱离编码终端的跨系统行政流,这条原则就不成立。在自带独立循环的 300 道业务流程基准 AutomationBench 上,合并适配器得分仅 23.7%,与原版基座的 23.0% 基本持平,Hermes 适配器甚至跌至 17.7%。周末真要在本地搭起这套栈,还有三颗写在官方文档小字里的暗雷得靠开源护栏兜住:
- 防适配器协议错配与升级失效:
Qwen3.8-27B-pi-adapted模型卡专门标红,用Pi连接vLLM(须开启--mamba-cache-mode align)时,models.json里必须显式写明"api": "openai-completions",一旦漏写走到默认的Responses API就会失灵。同理,每当上游脚手架大改提示词模板或工具返回格式,就得重跑一轮百步级微调,锁住脚手架小版本格外要紧。 - 防端侧小模型死循环、中文碎句与误删文件:
Inkling 2 Mini模型卡第 7 节坦承其复杂多约束指令(ComplexConstraints v1.1仅 33.4%)与中文输出偏弱(实测偶现语序截断与中英混杂),调代码时偶发陷入反复自检的推理循环,且可能未经确认直接覆盖或删除文件。除了硬设最大输出 Token 与轮次上限,绝不能让它在宿主机目录裸跑。 - 用三件 GitHub 高热开源工具焊牢闭环:截至 2026 年 11 月 20 日位居趋势榜前列的三个 Apache-2.0 仓库刚好互补。向外操控桌面软件时,用港大
HKUDS/CLI-Anything(累计超 6.13 万星)经 7 阶段生成器把 GIMP、Blender、Obsidian、FreeCAD 等封装为带--help自描述与结构化 JSON 输出的标准 CLI;向内卡住高危写入时,挂上高居七日趋势榜首的backnotprop/plannotator(约 1.38 万星),用 Hook 自动拦住Pi、OpenCode、Claude Code的ExitPlanMode计划与本地 Diff,在浏览器批注确认后再放行,掐断小模型误删文件的风险;合并代码前跑一遍阿里alibaba/open-code-review(约 5.47 万星),靠确定性文件筛选与规则匹配管线约束 Agent 做行级审查,在覆盖 50 个仓库、200 个真实 PR 的AACR-Bench上仅花通用 Agent 约九分之一的 Token 就能筛出高精确率缺陷(主动让渡部分召回率换低误报)。
知识延伸:循环模型把推理藏进内部层,思维链监控还管用吗?
每个 Token 输出成文字前先在中间层转 3 圈,会不会把真实意图藏进不可见的内部激活、导致阅读思维链(CoT)的监控机制失效?Thinking Machines Lab 用支持 1 至 5 遍动态循环的研究变体 TML-d24-varloop-research 做了实测:在强制跳过思维链的 Think Fast 测试中,把循环从 1 遍加到 3 遍,确实让 50% 可靠度时间跨度从 16 秒升至 37 秒;但在正常开启思维链跑科学推理 GPQA Diamond 时,循环 5 遍虽比 1 遍把平均推理长度压缩了一半以上(从 3,703 Token 压至 1,661 Token,犹豫回溯词从 9.7 次降到 3.6 次),英语词典有效词占比仍稳定在 94.4%–94.6%,且考察模型能否按指令刻意隐去特定词的 CoT-Control-QA 操控成功率最高仅 0.1%(Qwen3.8-27B 为 1.3%)。反过来,Hugging Face 团队复盘关闭推理训练出的 Harness Adapter 时还观察到了“推理泄漏”——模型为提高一次调准工具的胜率,竟自发学会在发工具调用前先写出约 160 Token 的简短口语盘算。在 26B 至 27B 量级,开源模型既藏不住真实盘算,也依然离不开扎实的工具契约与沙箱护栏。
说明:本文由 津滨AI 借助 AI 辅助检索与起草,并经人工对照 2026 年 11 月 20 日 Hugging Face 官方博客与模型卡、Thinking Machines Lab 官方技术公告及 GitHub 开源仓库文档逐条核实审校。文内题图由 AI 辅助生成概念示意(非实拍),数据图与架构演进图由 津滨AI 基于已核实公开数据绘制。
参考资料
[1] Hugging Face Blog (Lewis Tunstall): Introducing harness adapters: adapt your favorite model to your harness to improve performance and cost(2026-11-20):https://huggingface.co/blog/harness-adapters-at-scale
[2] Hugging Face Model Card & Leaderboard: harness-hub/Qwen3.8-27B-pi-adapted & Harness Leaderboard(2026-11-20):https://huggingface.co/harness-hub/Qwen3.8-27B-pi-adapted | https://huggingface.co/spaces/joelniklaus/harness-leaderboard
[3] Hugging Face Blog & Thinking Machines Lab: Welcome Inkling 2 Mini & thinkingmachines/Inkling-2-Mini(2026-11-20):https://huggingface.co/blog/inkling2mini | https://thinkingmachines.ai/news/inkling-2-mini/ | https://huggingface.co/thinkingmachines/Inkling-2-Mini
[4] GitHub 开源仓库:HKUDS/CLI-Anything、backnotprop/plannotator、alibaba/open-code-review(2026-11-20 快照):https://github.com/HKUDS/CLI-Anything | https://github.com/backnotprop/plannotator | https://github.com/alibaba/open-code-review