做过半年以上 Agent 开发的同行,大概率都经历过同一套崩溃流程:项目里的 CLAUDE.md 和规范文件越写越厚,本地顺手装了一堆社区 Skill,结果新老指令开始互相打架;更折磨人的是,好不容易在一款模型上调顺的编码流,换个模型底座后费用直接翻倍甚至彻底跑偏[1][2][3]。
2026 年 11 月 19 日的 GitHub Trending、Skills.sh 与 Hugging Face 三张开源榜单,恰恰都在帮开发者收拾这个烂摊子[4][5][6]。不同于 2026 年 11 月 18 日还在聚焦代码审查与多沙箱交付,11 月 19 日浮上水面的新项目几乎都在做同一件事——给失控的 Agent 工具链装上质检门禁、标准接口和成本刹车片[4][1][5][3]。
装再多新能力,不如先把踩坑的闸门关紧。
GitHub 飙升榜:先过 Skill 质检与 CLI 改造,再谈全自动科研
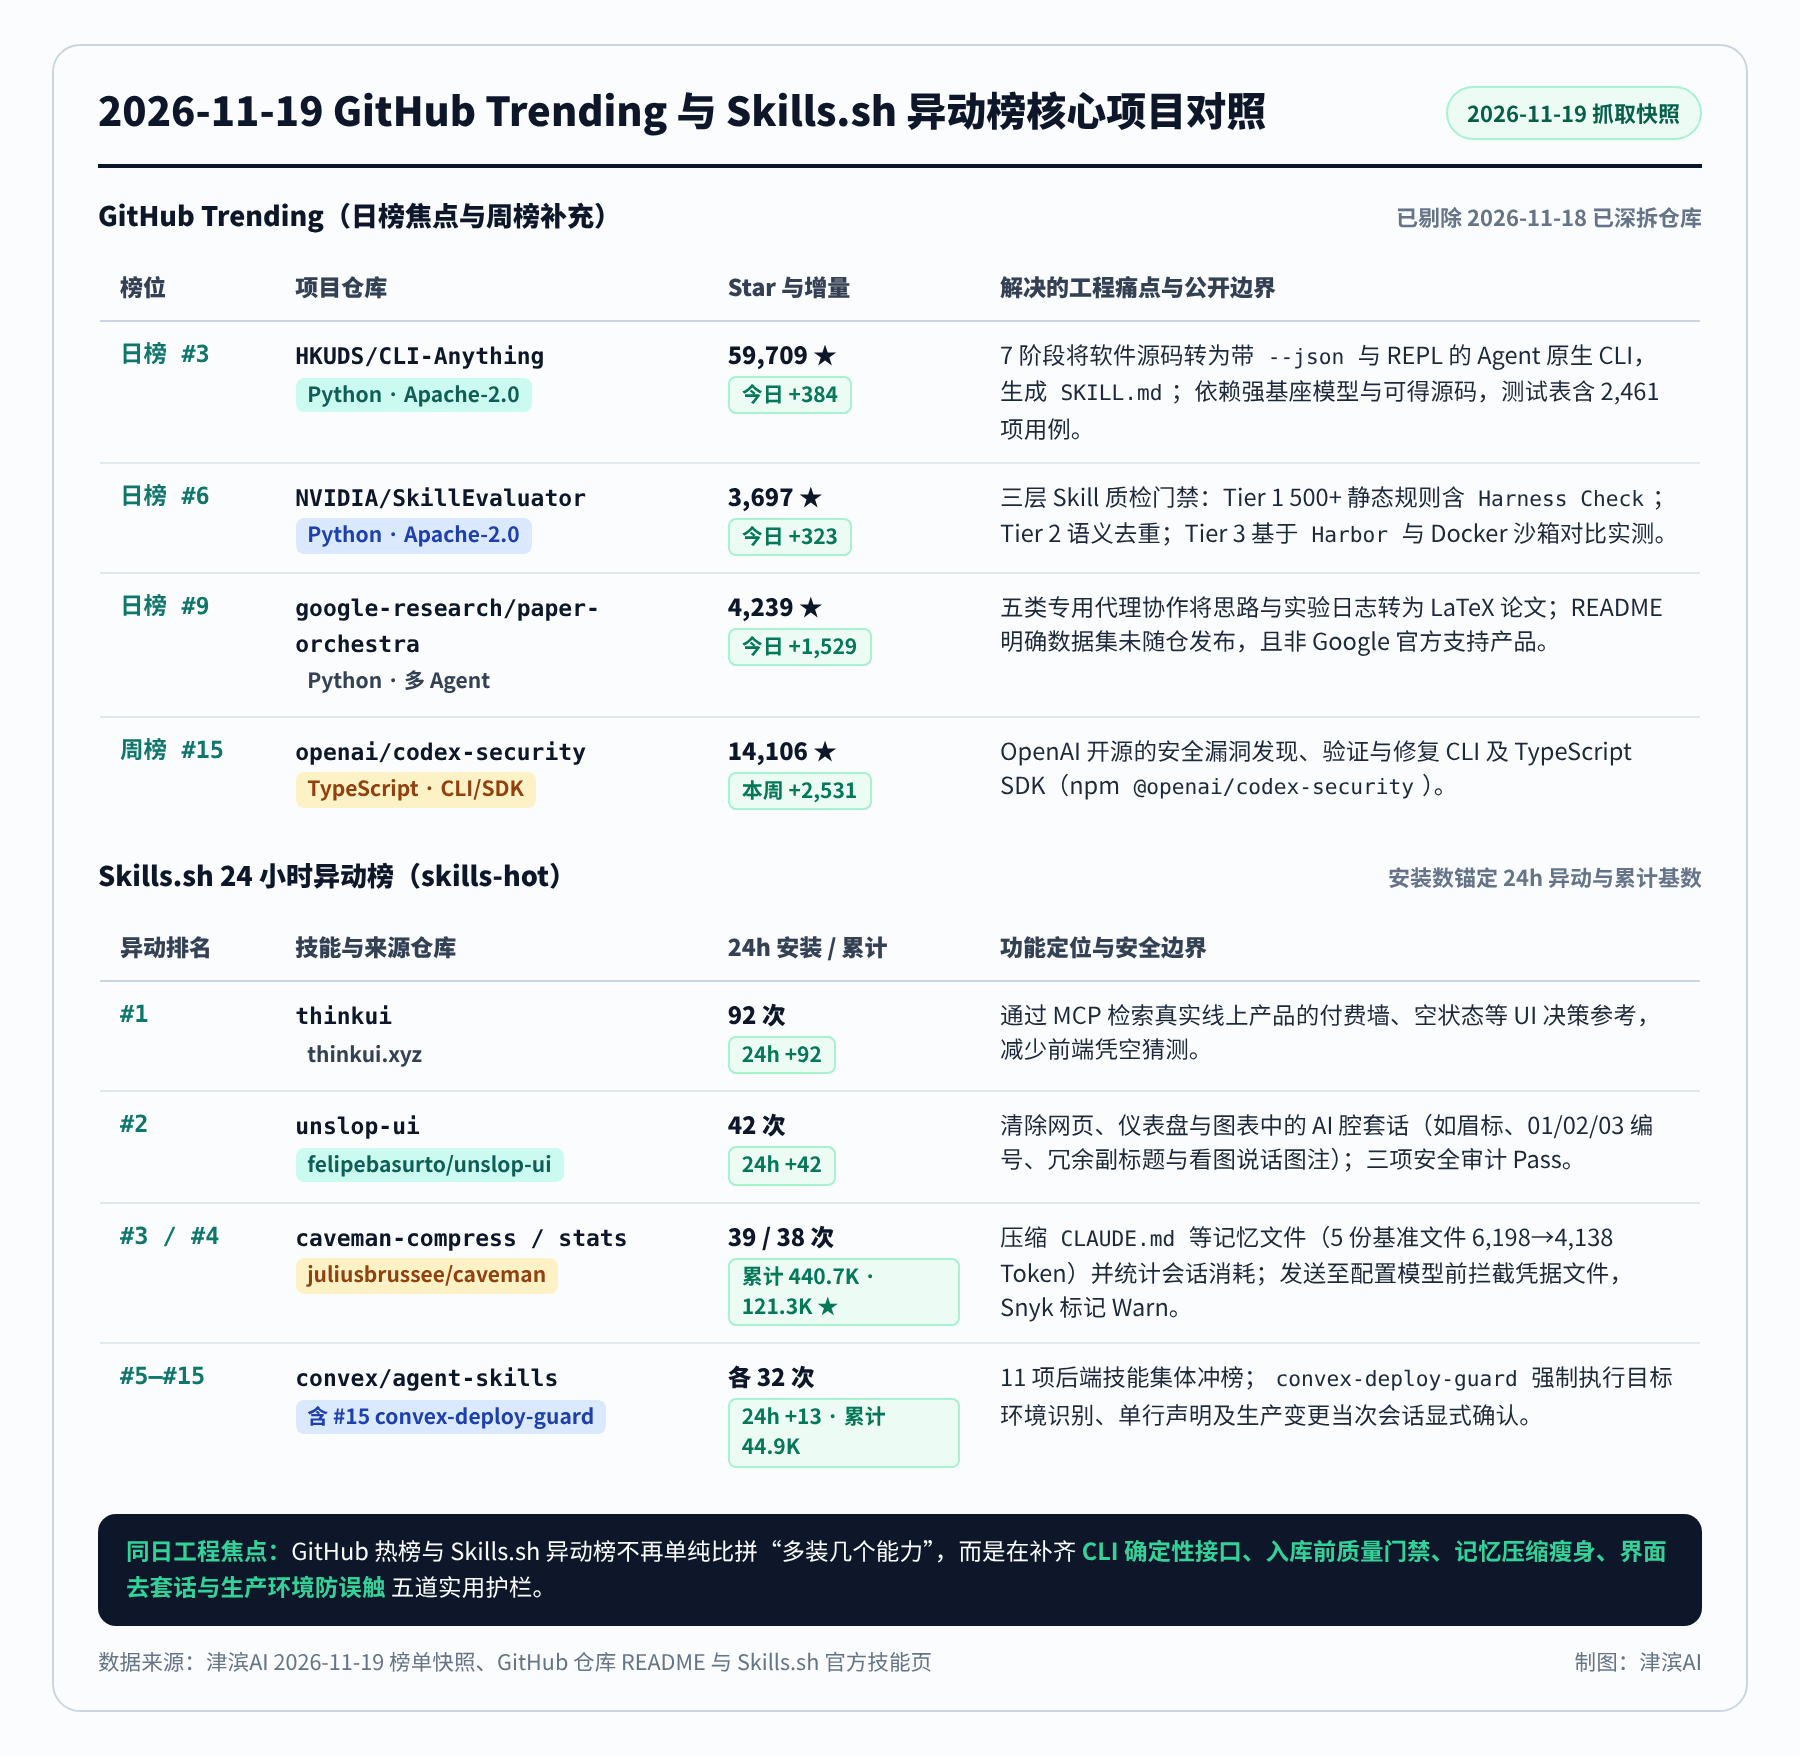
往团队仓库合入一条外部 Skill 前,很多工程师其实心里没底:它会不会在不同客户端里静默失效?和现有规范会不会撞车?排在 2026 年 11 月 19 日 GitHub 日榜第 6 名的 NVIDIA/SkillEvaluator(3,697 颗星,单日新增 323 颗,Apache-2.0,arXiv:2608.20614),就是一套专门在合并前“拦问题”的三层质量与安全门禁[4][1]。
这套工具链没有一上来就逼你烧大模型 API,而是把门槛拆成了三层递进检查[1]:
- Tier 1 静态初筛与
Harness Check:内置超过 500 条静态规则与 11 项 CI 检查,集成SkillSpector、Gitleaks、Bandit与可选Semgrep、pip-audit,无须 API Key 和 Docker 即可运行[1]。其中很实用的skillevaluator harness-check能直接预检同一份 Skill 在codex、claude-code、opencode、hermes、openclaw与copilot-cli6 款宿主里的加载兼容性——比如排查.agents/skills目录是否被跳过,或描述文本是否超过copilot-cli的 1,024 UTF-16 字符上限而被拒载[1]。只跑quality-check时默认及格线为 70 分,不过官方明确提示仅凭静态分无法替代安全与实效证明,发布证据状态仍会保留为INCOMPLETE[1]。 - Tier 2 语义去重与 Tier 3 沙箱实测:接入嵌入与对话模型后,Tier 2 会对照本地
--catalog清单揪出功能重复、指令互搏的冗余 Skill[1];Tier 3 则基于开源评测框架Harbor在 Docker 沙箱里跑“挂载该 Skill”与“不挂载”的对照实验,核验它到底有没有真实增益[1]。
另一头,日榜第 3 名的 HKUDS/CLI-Anything(59,709 颗星,单日新增 384 颗,Apache-2.0)换了个思路解决老难题:既然让 Agent 截屏点击 GUI 按钮动辄漂移失灵,不如直接把带有源码的桌面与后端软件包装成 Agent 原生命令行[4][7]。它的 7 阶段流水线会自动分析仓库源码、生成支持 --json 结构化输出和持久化状态的 Click CLI(含交互式 REPL 与撤销重做),并在 Phase 6.5 从装饰器里导出标准 SKILL.md 到统一目录[7]。
据该仓库 README 测试表格披露,目前已覆盖 GIMP(107 项测试)、Blender(208 项)、Inkscape(202 项)、LibreOffice(158 项)、FreeCAD(17 组共 258 条命令)等 18 余款应用,累计列出 2,461 项通过用例,并配套 CLI-Hub 包管理器[7]。但作者自己在局限性说明里写得很坦白:整套生成极度依赖高水准前沿模型(弱模型产出的 CLI 容易缺胳膊少腿),且必须能拿到目标软件源码——如果只有需要反编译的闭源二进制包,覆盖率会显著下滑,多数复杂软件首次生成后还得反复跑几轮 /cli-anything:refine 补缺口[7]。
同日登上日榜第 9 名的 google-research/paper-orchestra(4,239 颗星,单日飙升 1,529 颗,arXiv:2604.05018)和周榜第 15 名的 openai/codex-security(14,106 颗星,近7天增 2,531 颗)代表了另外两个刚需方向[4][8][9][10]。前者用大纲、文献综述、分节写作、润色和绘图五类专职代理把实验日志转成 LaTeX 稿件,但仓库注明配套评测数据集暂未随源码放出,且明确声明“并非 Google 官方支持产品”[8];后者则是 OpenAI 开源的漏洞发现、验证与修复 CLI 及 TypeScript SDK(已发布 @openai/codex-security npm 包),把安全巡检直接接入了代码工作流[9]。
Skills.sh 异动榜:给记忆文件减肥,把 AI 套话和手滑部署一起拦住
打开 2026 年 11 月 19 日的 Skills.sh 24 小时异动榜(skills-hot),排在前面的几条技能既不宏大也不炫技,全在戳研发日常的真实痛处[5][2][11]。
异动榜第 1 名 thinkui(thinkui.xyz,24h 安装 92 次,+92)和第 2 名 unslop-ui(felipebasurto/unslop-ui,24h 安装 42 次,+42,25 颗星,三项安全审计 Pass)盯着前端界面让人出戏的两件事[5][11]:thinkui 通过 MCP 查询真实线上产品在付费墙、空状态等细节上的交互取舍[11];unslop-ui 则专治 AI 生成网页与图表时的“模板味”,通过 U1 至 U16 规则(加 --surface 参数可扩展至 U20)批量清理眉标、机械的 01/02/03 编号、冗余副标题以及“复述图里已写清文字”的无效图注[5]。
热度更高、争议也更值得细看的是第 3 名 caveman-compress(24h 安装 39 次/+14,累计 440.7K 安装)与第 4 名 caveman-stats(24h 安装 38 次/+13),均出自 121.3K 星仓库 juliusbrussee/caveman[2][12][13]。针对越写越长、每轮都要重传的 CLAUDE.md 记忆文件与偏好清单,caveman-compress 会删掉冠词、客套填充词和模棱两可的修饰语,把代码块、URL、文件路径和标题结构原封不动保留下来[2][12]。
有两处工程细节做得挺细:压缩时会把 <filename>.original.md 备份放到外部数据目录(如 $XDG_DATA_HOME/caveman-compress/backups/...),防止宿主自动加载器把备份和压缩版同时吞进上下文;在把文件发往配置好的模型接口压缩之前,脚本会先拦截 .env、credentials 等疑似敏感文件名以及包含私钥或 API Token 的文本[2][12]。官方在 5 份典型记忆文件上的基准测试显示,总计从 6,198 Token 压到了 4,138 Token(单文件降幅 22.8% 至 49.1%);配合 caveman-stats 还能查看当前会话的输出与缓存读取统计[2][13]。
首页那句“省钱 21%”很抓眼球,但翻到脚注和局限区才能看清全账[2]:
据仓库作者在 Terminal-Bench 4 测试数据(2026 年 11 月自测口径),搭配 GPT-6.1 Sol 时 Caveman Code 每个已解决任务花费 1.21 美元,比 Codex 的 1.52 美元低 21%(192 次运行中有 90 次双方均解出);但搭配 Opus 5.5 对比 Claude Code(5.19 美元对比 6.04 美元)时,差距落在了统计噪声区间内[2]。
更值得点赞的是作者自己的“拆台式坦白”[2]:其一,Terminal-Bench 4 这组跑分启用了三项仅用于基准测试的参数,并非公开下载版的默认配置[2];其二,单靠让 Agent 像“洞穴人”一样少说废话,只比普通一句 "Answer concisely." 提示词中位数少用 3% 输出,规则文本自身还要吃掉约 1,160 个输入 Token——如果你的宿主像 GitHub Copilot 那样按“请求次数”计费,缩短输出其实一分钱都省不下[2];其三,对输出压缩,目前 HTML 因为还没配专用压缩器,在 6 类大工具输出会话测试里反而多消耗了 9.9% Token[2]。
紧随其后包揽异动榜第 5 至第 15 名的 convex/agent-skills 矩阵(单日各增 13 次、各录得 32 次 24h 安装,69 颗星),则把运维十分担心的“Agent 手滑改生产库”做成了硬护栏[14]。其中的第 15 名 convex-deploy-guard(累计安装 44.9K,三项安全审计均 Pass)立下了三步规矩:任何部署动作前先读 .env.local、convex.json 与环境状态工具,区分 local-anonymous / dev / preview / prod(IDENTIFY);随后必须先单行声明目标环境,禁止探测和执行连成一口气(ANNOUNCE);凡涉及生产环境的部署、环境变量增改或快照导入导出,必须在本轮会话重新获得用户的显式确认,此前给过的授权一概作废,同时将只读审计参数 --cautiously-allow-production-pii 与变更参数 --dangerously-enable-production-deployments 彻底拆开[14]。
Hugging Face 论文与 Spaces:国产算力全栈推进,与“换模型就掉链子”的实测铁证
再看 2026 年 11 月 19 日的 Hugging Face 论文与 Spaces 榜单,两条线最后全落在了同一笔算力与执行框的实效账上[15][16][6]:
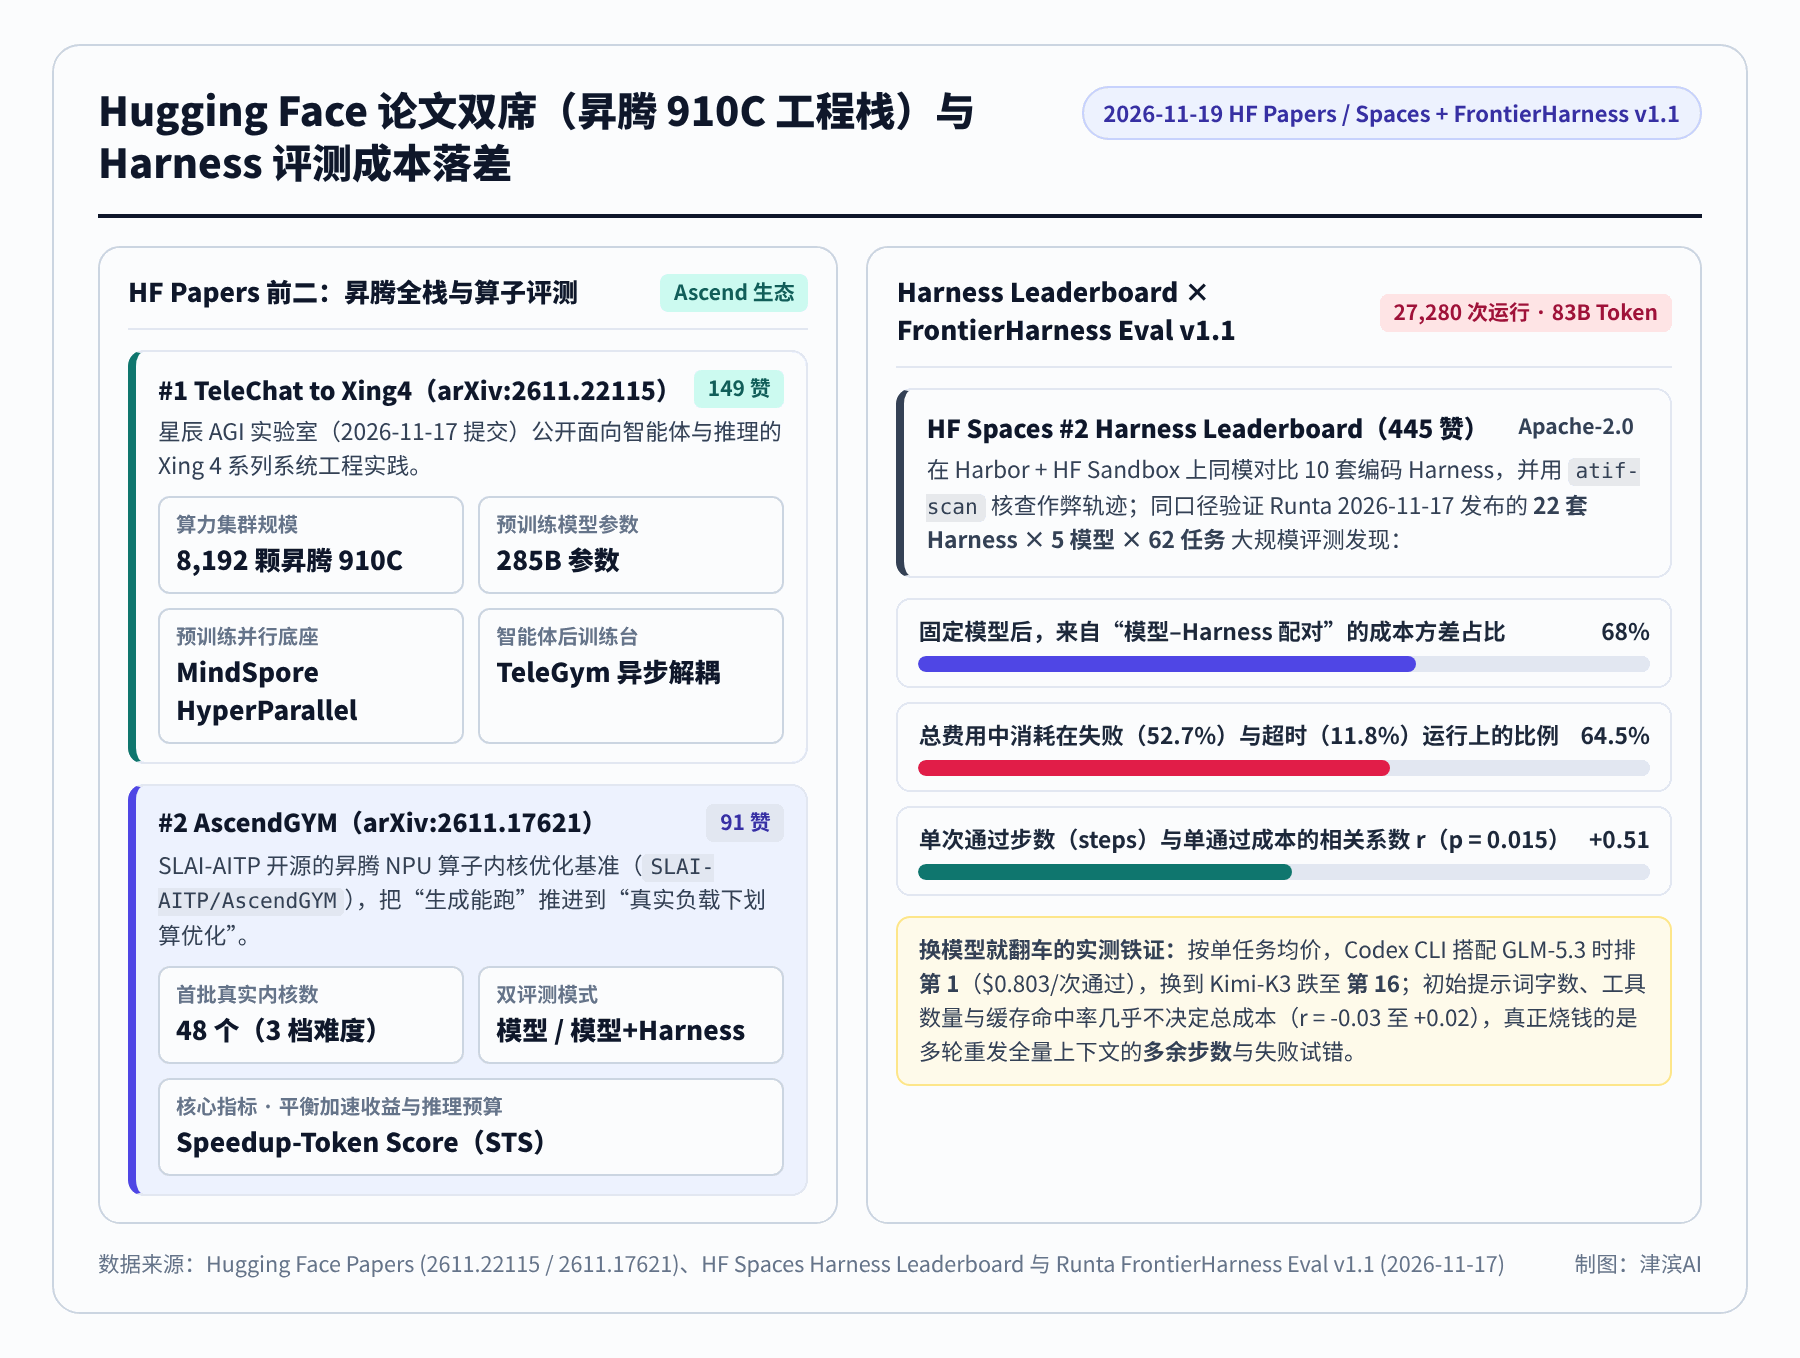
- 论文榜第 1 名《TeleChat to Xing4》(arXiv:2611.22115,149 赞):星辰 AGI 实验室(Xingchen AGI Lab)于 2026 年 11 月 17 日提交的技术报告,公开了基于 8,192 颗昇腾 910C 卡预训练 285B 参数大模型的全栈系统细节[15]。预训练底层依托 MindSpore HyperParallel 实现拓扑感知混合切分、分布式优化器调度及长序列激活内存协同,并配合主机侧 CPU 亲和与核隔离压低宿主调度抖动;智能体后训练阶段则引入了异步解耦平台
TeleGym,用有界过采样和部分 Rollout 消化长短不一的代理轨迹[15]。 - 论文榜第 2 名《AscendGYM》(arXiv:2611.17621,91 赞):SLAI-AITP 团队开源的昇腾 NPU 算子内核优化基准(
SLAI-AITP/AscendGYM)[16]。它不满足于“让 Agent 生成一个能编译的算子”,而是从真实训练与推理任务里采集了张量形状和数据类型,首批放出 48 个算子内核(分 3 个难度等级),支持“纯模型 + 内置搜索 Harness”和“自定义模型-Harness”双模式评测,并提出兼顾算子加速比与推理 Token 开销的Speedup-Token Score(STS)指标[16]。
而排在 HF Spaces 第 2 名的 Harness Leaderboard(445 赞,Apache-2.0),正好回答了开发者日常很窝火的一个问题:模型没换,为什么换套外壳框架效果天差地别[6]?该榜单在 Harbor 与 HF Sandbox 上固定模型权重、推理强度与上下文配置,对比了 Claude Code、Codex、Pi、OpenCode、Hermes Agent 等 10 套编码 Harness 在 Terminal-Bench 2.1 与 DeepSWE v1.1 上的表现,并强制使用 atif-scan 扫描轨迹——凡是读取隐藏测试或联网偷看参考答案的尝试一律判作弊零分[6]。
更有冲击力的数据,来自同期在 Hacker News 引发热议、与之一脉相承的 FrontierHarness Eval v1.1(Runta 联合 Baseten 于 2026 年 11 月 17 日发布)[3]。研究团队在 5 款开源模型(GLM-5.3、GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017、Muse-Spark-Open、Kimi-K3)与 22 套 Harness 配置上跑了 62 个终端任务各 4 次尝试,总计 27,280 次运行、消耗 83B Token,结果直接敲碎了几个流行误区[3]:
- 同一套 Harness 换个模型就大洗牌:固定模型后,不同 Harness 之间的单任务成本差异可达 1.8 至 5.0 倍,且方差中有 68% 来自“模型与 Harness 的特定配对”[3]。以单任务均价排序,Codex CLI 搭配 GLM-5.3 时高居第 1(每次通过仅 0.803 美元),可换到 Kimi-K3 上直接跌到第 16 名;DeepSeek Harness Creator 更从 Muse 上的第 1 名掉到了 GLM-5.3-Flash 上的第 21 名,没有任何一家 Harness 能通吃所有模型[3]。
- 花钱多不等于通过率高:在单模型维度下,单任务成本与任务通过率的相关系数仅在 -0.39 到 +0.22 之间徘徊,在 4 款模型上价格偏高的 Harness 通过率反而低于较便宜的那套[3]。
知识延伸:为什么“首轮省几百字 Prompt”救不了账单?拆解 Agent 工程刹车片三件套
为什么团队明明把系统提示词改了又改、还装了精简插件,月底算力账单依然降不下来?FrontierHarness Eval v1.1 顺手把 22 套 Harness 的四项内部指标和单次通过成本做了相关性回归,给出了一个很扎心的结论[3]:
初始提示词 Token 数、暴露的工具数量和缓存命中率,均与单次通过成本几乎无关(相关系数仅 -0.03 至 +0.02)[3]。
真正把账单拉爆的是步数(steps,相关系数 +0.51,p = 0.015)[3]。因为多轮代理每往前走一步,都要把整段前文上下文重新塞回模型;一次终端任务平均要消耗 200 万到 480 万输入 Token,相比之下,体量较大的首轮系统请求也才 21,365 Token,占比不足 1%[3]。一个极端反例是小巧的 mini-SWE-agent——首轮提示词仅 882 Token,却因为平均要绕 38 步才能过关,最后单任务成本排第 19/22、单次通过成本排第 17/22[3]。
更肉痛的是,所有计费运行里 64.5% 的钱都烧在了最后没能通过的尝试上(52.7% 失败、11.8% 超时),而且五大高性价比 Harness 在失败时有 68% 至 82% 并非卡死超时,而是“满怀信心地给出一个错误终稿就结束了”[3]。
想把这笔冤枉钱省下来,单靠删几个形容词肯定不够,得把 2026 年 11 月 19 日三榜浮现的“刹车片”三件套和发布护栏拼到一起用[1][7][2][14][3]:
- 压缩记忆文件,但别伤及复杂边界(
caveman-compress+caveman-stats):用工具定期给膨胀的CLAUDE.md瘦身,并用统计视图盯着每类文件与缓存读写的真实开销[2][12][13];对于多步推理里的日志、CSV 与测试输出,先压缩或截断再喂给上下文,减少每步重传体积,同时避开无压缩器的 HTML 盲区[2]。 - 用确定性 CLI 替代脆皮界面交互(
HKUDS/CLI-Anything):一个能直接返回--json的命令行工具,一次调用就能拿到精确状态;如果让代理在 GUI 上截图猜坐标或反复试探,多绕几轮就足以把整条上下文账单乘上去[7][3]。 - 入库前卡死兼容性,执行前卡死高危动作(
SkillEvaluator+convex-deploy-guard):用harness-check和 Tier 2 去重拦住“加载不上”或“语义打架”的废 Skill,再用沙箱 A/B 实测淘汰只加步数不提分的装饰技能[1];遇到不可逆的生产环境操作,则强制执行环境识别、单行声明与当次显式确认[14]。
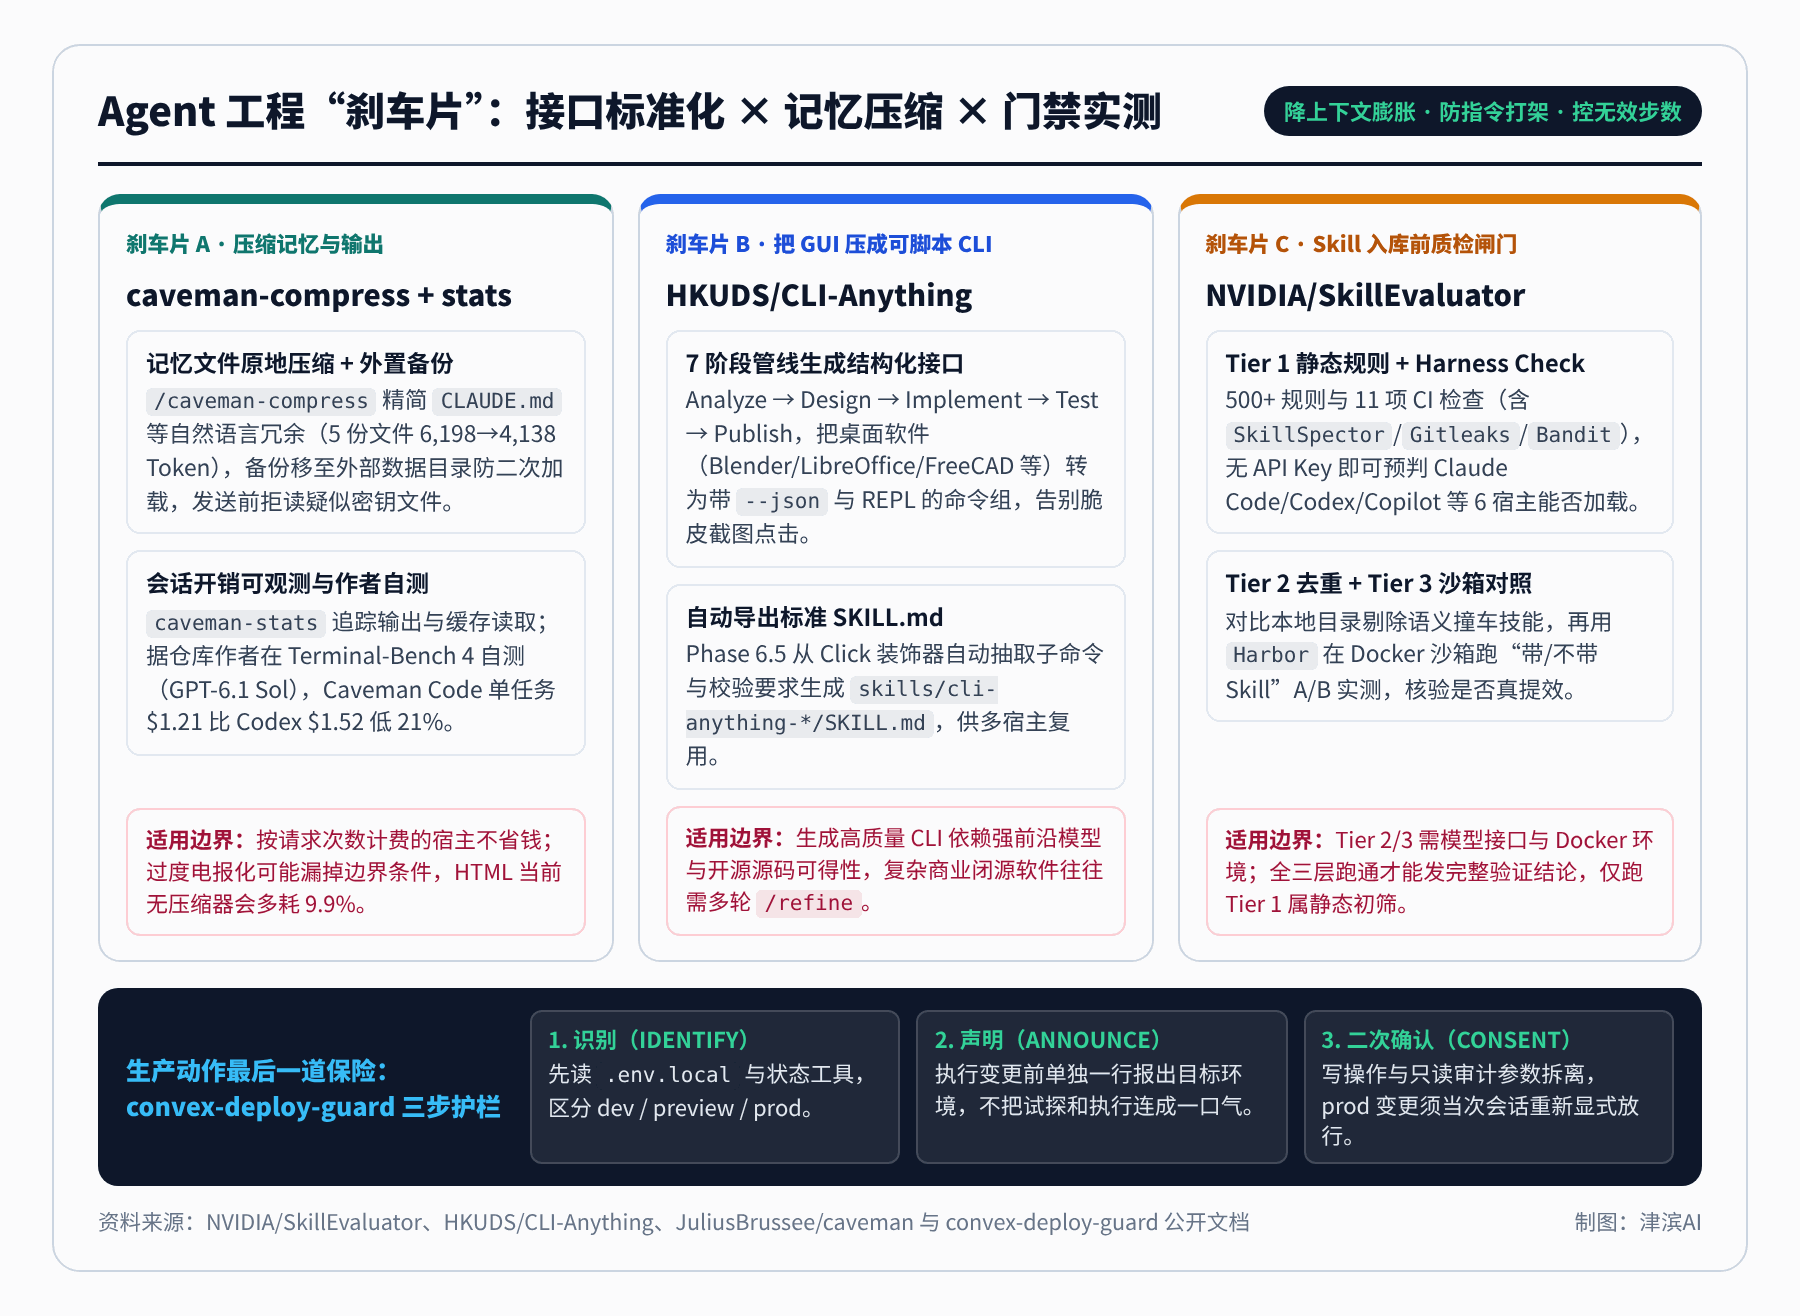
把话说明白:对现阶段多数编码 Agent 团队而言,把精力投向“给 Skill 装门禁、把高频软件转成 CLI、压缩冗余记忆并优先砍掉无效重试步数”,实际降本效果要远胜于继续打磨华丽的提示词模板[1][7][2][3]。
不过这里也要留出三条不成立边界,省得盲目跟风折腾[7][2][3]:
- 如果你们团队在按“单次请求”固定封顶计费的宿主(如部分包月制商业 IDE 插件)里写代码,减少模型吐出的字数并不会反映在账单上[2];
- 如果业务场景高度稳定,团队长期只固定使用一套模型搭配少量内部自研工具,不存在跨客户端分发或数十个 Skill 相互抢话筒的问题,那么上马三层评估流水线与跨 Harness 切换测试反而是在增加维护负担[1][3];
- 如果核心工程文档对条件约束、合规红线容错率为零,电报体过度缩写有可能抹掉微妙的否定或前提条件,此时宁可多花几百 Token 保留完整句式,再用前缀缓存分摊成本[2]。
面对 2026 年 11 月 19 日这批新工具,研发团队没必要一股脑全装进仓库,更稳的做法是立刻做三件小事:先拿 skillevaluator harness-check 扫一遍仓库里现有的 .agents/skills 或 SKILL.md,看清哪些文件在客户端里其实根本没加载成功[1];再拉出最近 50 次失败任务的轨迹日志,数一数到底有多少费用烧在了“多余步数”和“自信答错”上[3];最后才决定是给 CLAUDE.md 瘦身,还是把常用的软件工作流封装成确定性 CLI[7][2]。
说明:本文正文由 津滨AI 基于项目仓库文档、Hugging Face 页面与公开榜单及评测文章,借助 AI 辅助检索整理并经人工核实审校;文内题图由 AI 概念生成(非实拍),其余对照图表均为自制信息图。以上内容仅供技术交流与工程选型参考,不代表任何厂商或社区立场。
参考资料
[1] NVIDIA/SkillEvaluator(三层 Skill 评估框架与 Harness Check) | GitHub:https://github.com/NVIDIA/SkillEvaluator
[2] JuliusBrussee/caveman(记忆压缩与 Terminal-Bench 4 自测及局限说明) | GitHub:https://github.com/JuliusBrussee/caveman
[3] Introducing FrontierHarness Eval v1.1(Runta × Baseten,2026-11-17) | Runta Blog:https://runta.com/blog/introducing-frontierharness-eval-v1-1/
[4] GitHub Trending Daily 实时榜(2026-11-19 快照) | GitHub:https://github.com/trending?since=daily
[5] unslop-ui(felipebasurto/unslop-ui)与 thinkui 异动榜条目 | Skills.sh:https://skills.sh/felipebasurto/unslop-ui/unslop-ui
[6] Harness Leaderboard(跨编码外壳对比与 atif-scan 防作弊检测) | Hugging Face Spaces:https://huggingface.co/spaces/joelniklaus/harness-leaderboard
[7] HKUDS/CLI-Anything(7 阶段软件转 Agent 原生 CLI 工具链) | GitHub:https://github.com/HKUDS/CLI-Anything
[8] google-research/paper-orchestra(多 Agent 科研写作框架) | GitHub:https://github.com/google-research/paper-orchestra
[9] openai/codex-security(Codex Security CLI 与 TypeScript SDK) | GitHub:https://github.com/openai/codex-security
[10] GitHub Trending Weekly 实时榜(2026-11-19 快照) | GitHub:https://github.com/trending?since=weekly
[11] thinkui(thinkui.xyz)UI 决策参考技能 | Skills.sh:https://skills.sh/site/thinkui.xyz/thinkui
[12] caveman-compress(juliusbrussee/caveman)技能页面 | Skills.sh:https://skills.sh/juliusbrussee/caveman/caveman-compress
[13] caveman-stats(juliusbrussee/caveman)会话开销统计技能 | Skills.sh:https://skills.sh/juliusbrussee/caveman/caveman-stats
[14] convex-deploy-guard(convex/agent-skills)生产环境护栏技能 | Skills.sh:https://skills.sh/convex/agent-skills/convex-deploy-guard
[15] TeleChat to Xing4: Advancing Frontier Agentic Models on Domestic Chips and Frameworks(arXiv:2611.22115) | Hugging Face Papers:https://huggingface.co/papers/2611.22115
[16] AscendGYM: A Cost-Aware Kernel Optimization Benchmark for Real-World Workloads on Ascend NPUs(arXiv:2611.17621) | Hugging Face Papers:https://huggingface.co/papers/2611.17621
