企业私有化部署 27B 级模型时,单张 10 GB 至 16 GB 显存的推理卡往往装不下权重,服务常被迫拆上多卡集群。2026 年 11 月 17 日晚,商汤科技按 Apache 2.0 协议开源了约 9B 参数的 SenseNova Loop-9B(此前已于 10 月末放出 Preview 版):它只保留 32 个物理解码层,却在单次前向传播里完成 56 次层计算,首日同步释出的 AWQ 4bit 量化权重仅约 4.9 GB,官方测算可将长文本部署门槛压低至 10 GB 显存以内[1][2][3]。
几乎在模型上线同时,寒武纪宣布基于推理框架 vllm_mlu 完成 Day 0 适配,打通该架构在 MLU 平台上的图文多模态推理链路[1][4]。要把这类循环网络真正接进生产推理引擎,硬件栈得跨过两道槛:32 套权重连跑 56 步时如何稳住特征尺度,以及非标准计算图怎样不弄乱现有调度与显存页表。
4.9 GB 权重背后的结构账,与商汤官方给出的能力边界
常规模型想把深度拉到 56 层,显存里就得驻留 56 套独立权重。SenseNova Loop-9B 的 config.json 与中文文档给出了另一种排布:模型一共只存 32 层物理权重,输入先经第 0 至 3 层做浅层对齐,中间第 4 至 27 层(共 24 层)作为共享循环块连续跑两遍,再交给第 28 至 31 层与输出头收尾[3][5]。靠这套三明治循环结构,约 9B 独立参数在推理时跑出了相当于约 14.6B 参数规模的 56 次计算深度[3]。
为压住长文本显存,这 32 个物理层按每 4 层一组交替排布 3 层线性注意力与 1 层全注意力,循环区间 [4, 28) 恰好对齐完整的 4 层周期[3][5]。模型训练上下文支持到 512K tokens;据商汤公开估算,4bit 权重搭配 8bit KV 缓存时,64K、128K 与 256K 上下文推理显存门槛分别约为 10 GiB、12 GiB 与 15 GiB,若将 KV 缓存同压至 4bit,则降至约 9 GiB、10 GiB 与 12 GiB[3]。
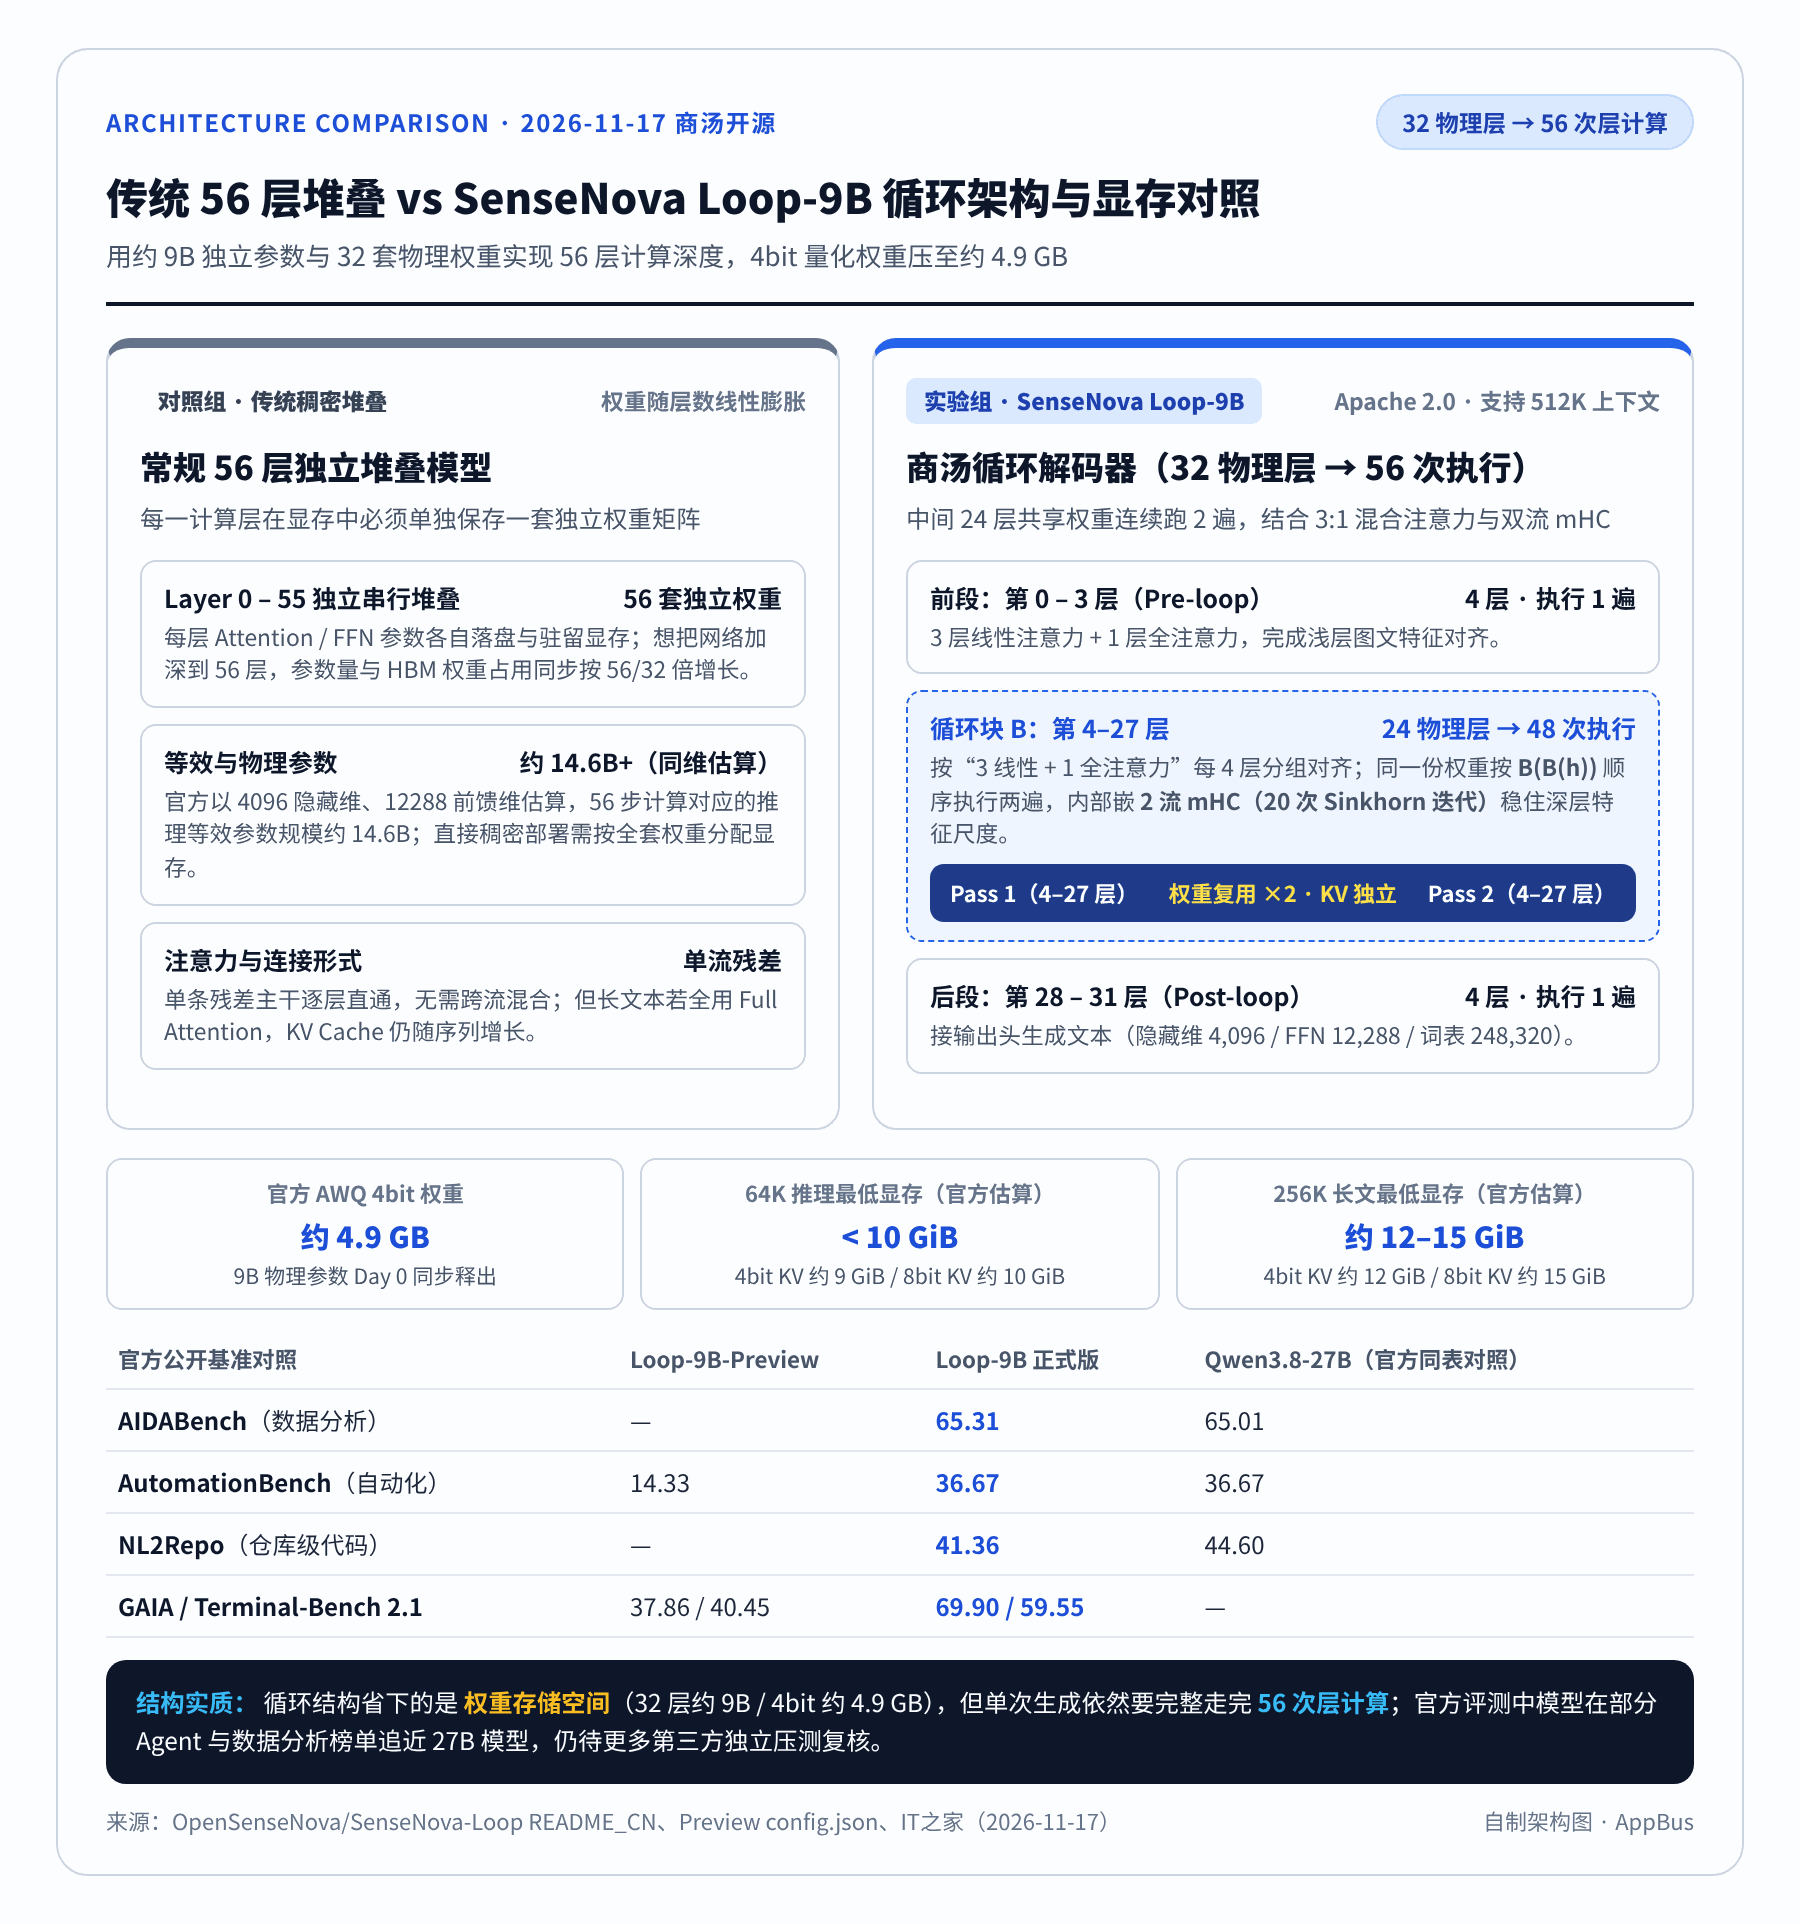
配图说明:图 1 显存需求与评测分数均引自商汤 GitHub 公开文档与 IT 之家发布通报,尚未包含第三方独立压测数据。
商汤披露的评测显示,Loop-9B 正式版在 7 项公开展示榜单上全面高于 Preview 版:AutomationBench 从 14.33 升至 36.67,Terminal-Bench 2.1 从 40.45 升至 59.55,GAIA 从 37.86 升至 69.90,BIRD 从 71.38 升至 72.34[3]。对比参数量三倍于己的 Qwen3.8-27B,正式版在 AIDABench 拿到 65.31 对 65.01,AutomationBench 同为 36.67,仓库级编程 NL2Repo 为 41.36 对比 44.60[3]。
不过官方仓库的已知局限章节并未掩饰短板[3][6]:遇到携带多重约束的工具调用定义、超长链路代码改造以及带复杂三维动效的网页一次生成任务时,模型仍可能遗漏指令或出现波动,部分复杂网页需经人工反馈迭代两到三轮[3][6]。且上述分数均出自商汤自公布口径,独立社区长尾复测尚待补齐[3]。
寒武纪 vllm_mlu 的三步 Day 0 适配:不止接通纯文本
新架构首日落地,首道关卡在图调度与算子覆盖。社区上游 vllm-project/vllm PR #64832 在适配 Preview 版时,仍注明当时仅限未量化纯文本推理[7]。寒武纪基于社区插件架构开发的 vllm_mlu(面向 MLU370 及以上设备),则沿着三条路径在正式版首日打通了图文多模态推理[1][8]:
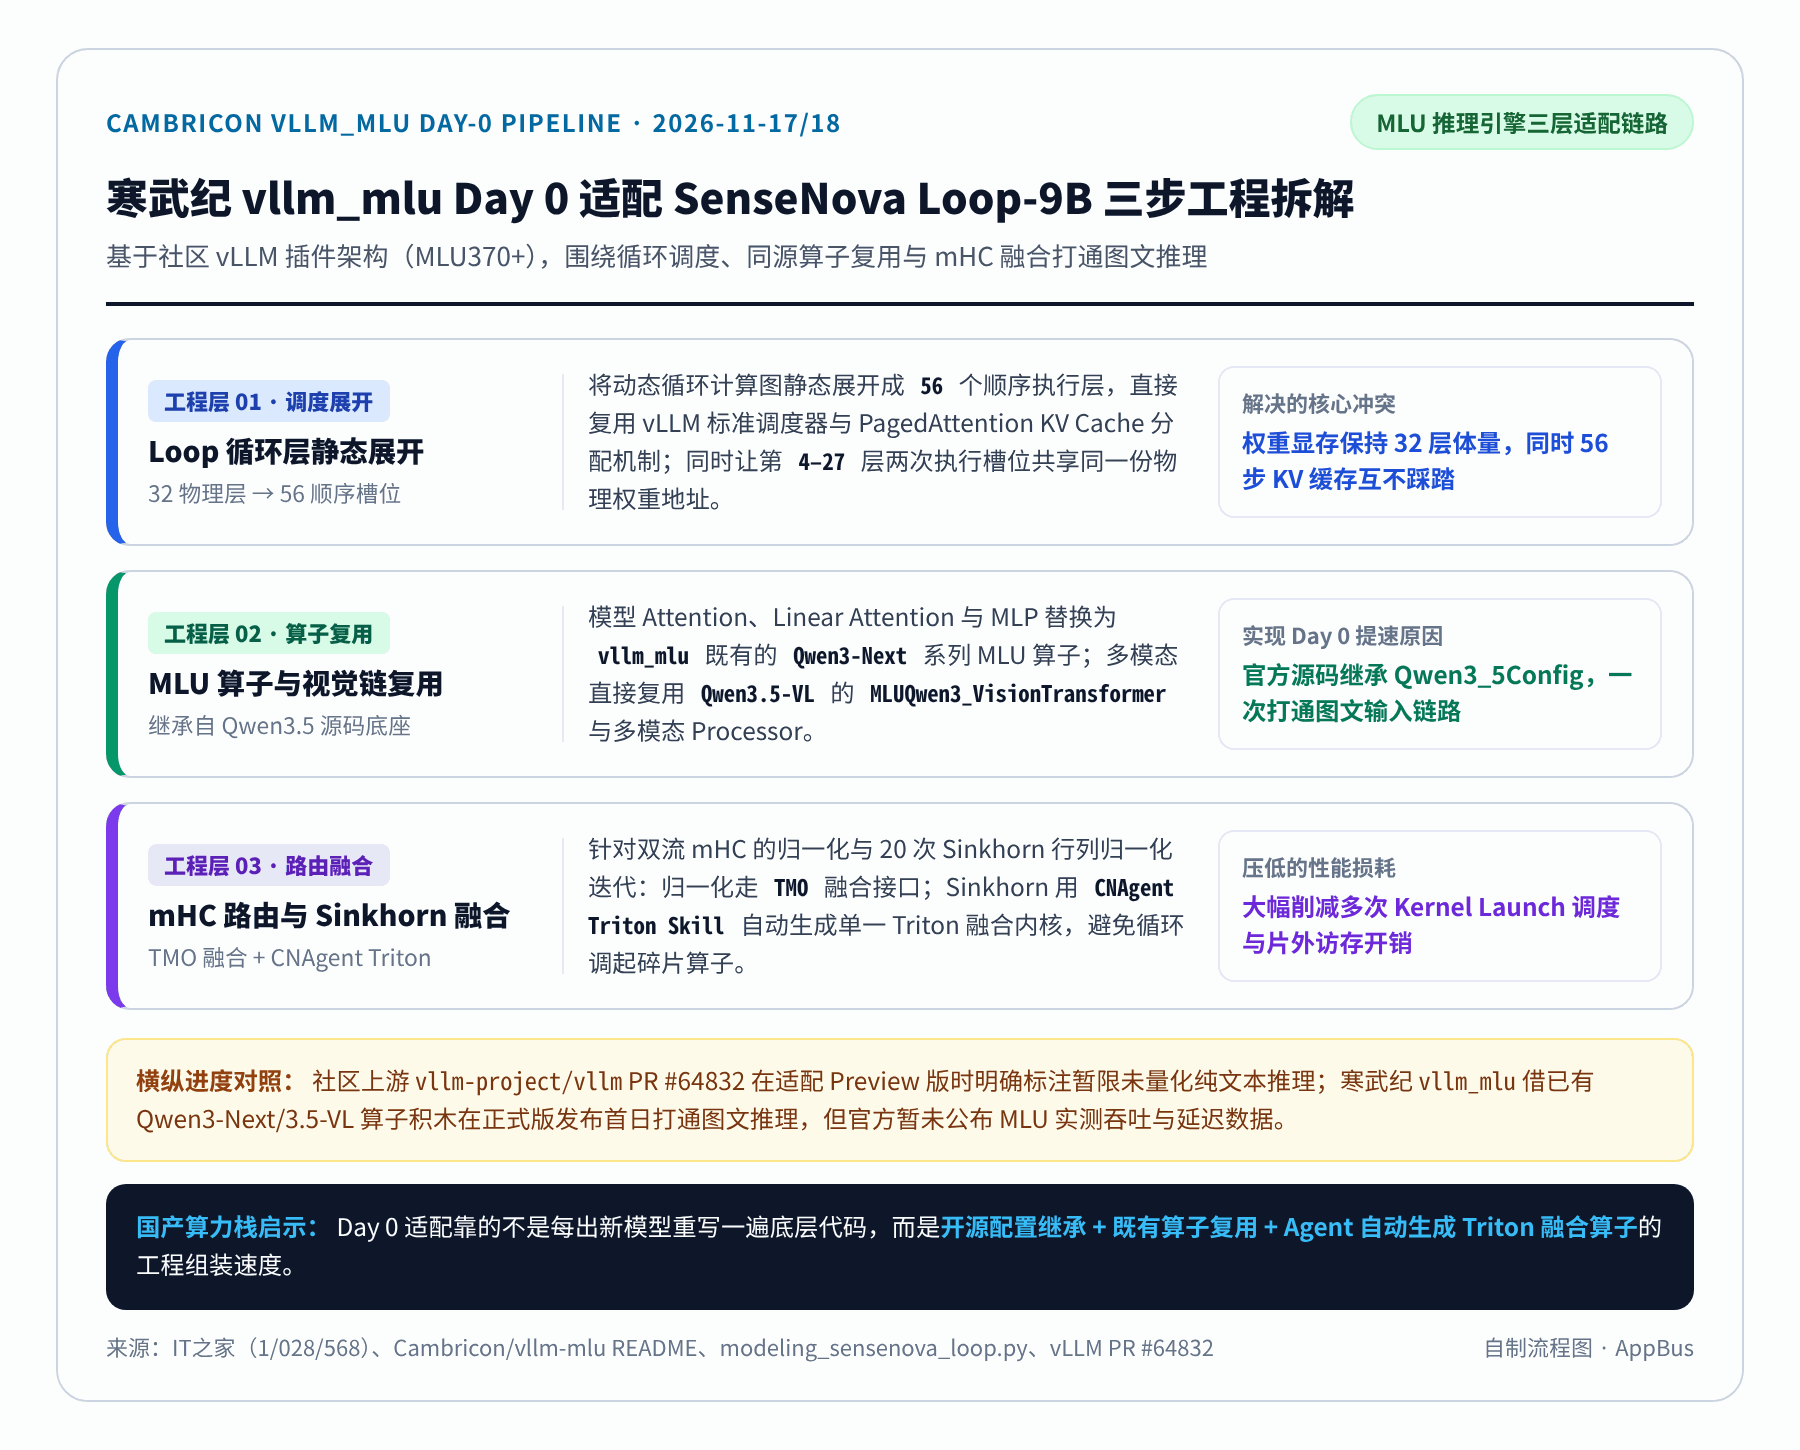
配图说明:图 2 依据寒武纪官方公开适配要点与开源仓库源码整理,截至 2026 年 11 月 18 日暂未见第三方实测 MLU 吞吐报表。
先是把动态循环静态展开进调度器。vllm_mlu 将循环图拉直成 56 个顺序执行的逻辑层,直接复用 vLLM 原生批次调度与 KV Cache 机制,同时让循环段两次执行槽位共享同一份物理权重内存,把权重显存锁在 32 层体量[1]。
再是借源码同源性快速拼装算子与视觉链。寒武纪将注意力、线性注意力与 MLP 替换为 vllm_mlu 既有的 Qwen3-Next 系列 MLU 算子,图像端复用 Qwen3.5-VL 的 MLUQwen3_VisionTransformer 与多模态处理器[1]。对照商汤模型实现 modeling_sensenova_loop.py 可见,SenseNovaLoopConfig 本身继承自 Qwen3_5Config,语言主干与解码层基类亦直接沿用 Qwen3_5TextModel 与 Qwen3_5DecoderLayer[9],这才让底层算子积木得以首日拼装到位[1][9]。
最后是压低 mHC 路由的细碎算子税。针对双流超连接归一化,寒武纪通过 TMO 融合接口合并计算;针对 Sinkhorn 迭代,则用 CNAgent Triton Skill 自动生成单一 Triton 融合内核,将多次迭代调度收拢为一次核函数执行[1]。
但工程选型不能把“省显存”误读成“省时间”。即便 4bit 权重缩至约 4.9 GB,单次生成每个新词依然要串行穿过 56 层计算和每层内的迭代路由,计算耗时按 56 步而非 32 步累算[1][3]。对于高并发、要求毫秒级首字响应的在线服务,这种“以时间换空间”的路线未必优于同参数单遍模型;况且截至目前,寒武纪与商汤均只公布适配打通,MLU 与 GPU 在不同批大小下的实测吞吐、首字延迟(TTFT)及逐字耗时(TPOT)仍缺第三方独立基准[1][3]。
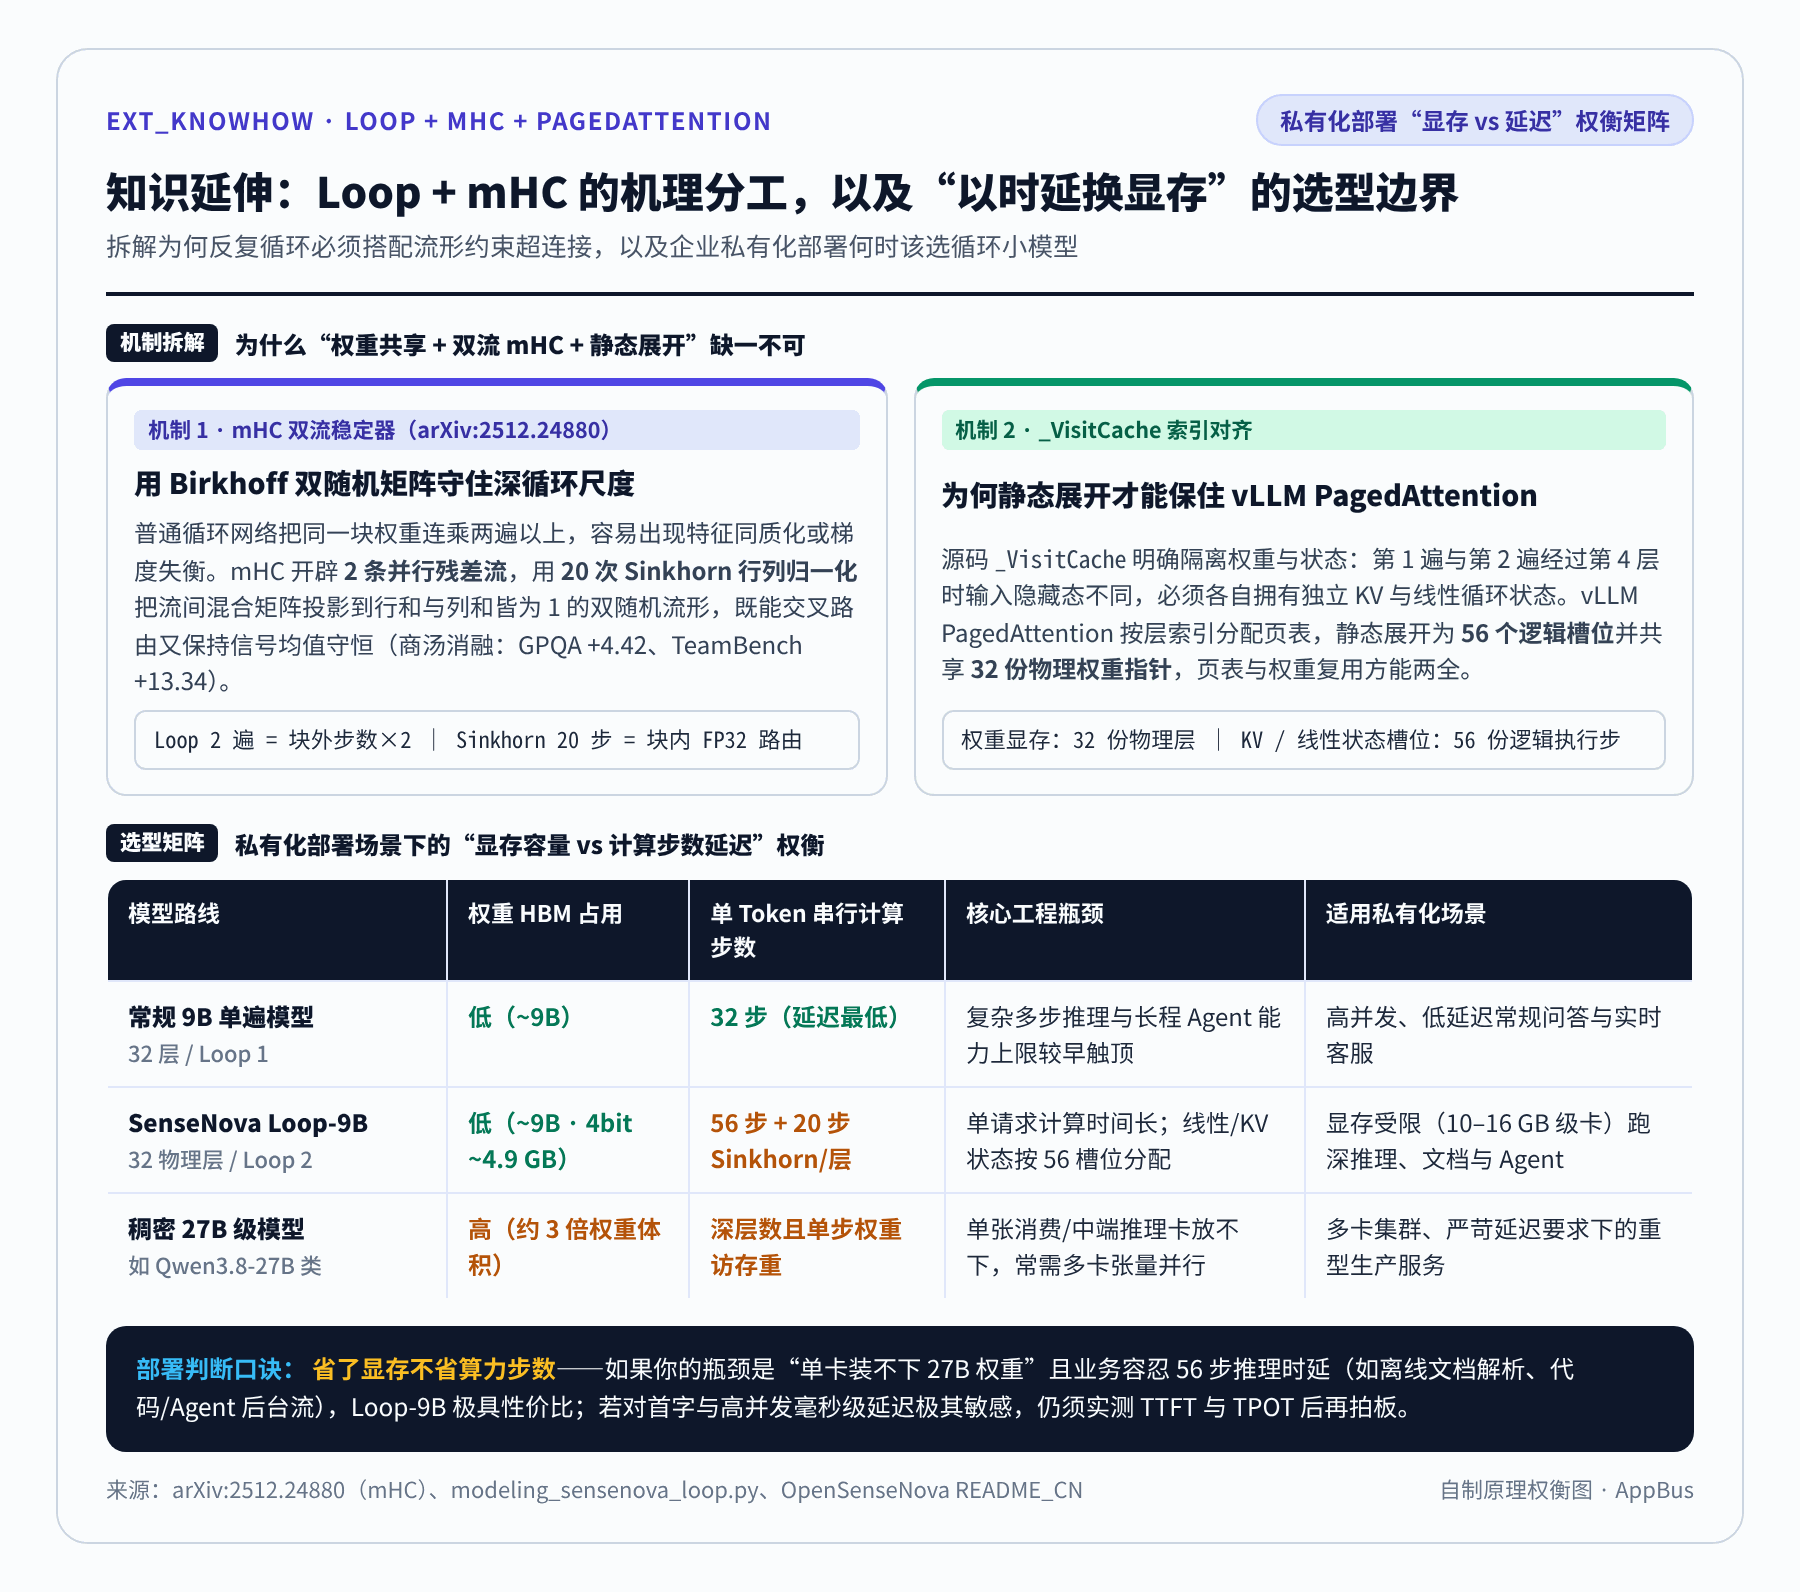
知识延伸:Loop + mHC 如何用算力换显存?静态展开为何能救 vLLM 页表?
把 32 层物理权重跑成 56 步计算,背后紧连着防特征坍缩与显存页表管理两道硬约束[3][9]。
- Loop Transformer + mHC:双流路由与 20 次 Sinkhorn 投影防坍缩。 商汤 Loop Scaling 实验以单遍 9B(Loop 1)为基线:同数据训练下,循环 3 遍使 Workbuddy-office 相对提升 16.93%、AIDAbench-QA 提升 6.42%;循环 4 遍使 LiveCodeBench V6 与数据可视化分别提升 8.10% 和 8.55%,正式版为兼顾推理效率折中采用 2 遍循环[3]。然而如果只把同一组权重连乘多轮,极易引发梯度失衡或特征同质化。为此模型引入 DeepSeek-AI 提出的流形约束超连接(mHC,arXiv:2512.24880)[10]:在循环块内开辟 2 条并行残差流,用可学习映射调节信息读写,并以 Sinkhorn-Knopp 算法执行 20 次对数空间行列归一化[3][9][10]。该步把混合矩阵严格投影到由双随机矩阵构成的 Birkhoff 多面体,使各行各列之和恒为 1,从而在多层连乘下保持信号尺度守恒、恢复残差恒等映射性质(商汤 Preview 消融中,加入 mHC 令 GPQA Diamond 提高 4.42 分、TeamBench 提高 13.34 分)[10][11]。DeepSeek 论文也明确指出,多流与迭代归一化会带来额外访存与核函数启动开销,必须依靠 Kernel Fusion 压低损耗,正对应寒武纪用 TMO 与 CNAgent 生成单 Triton 内核的工程优化[1][10]。
- 静态展开如何解开
vLLMPagedAttention 索引冲突。 权重可以两遍共用,推理状态却不行。查看modeling_sensenova_loop.py中的_VisitCache类可见其明确注释:物理层权重在每次循环访问中复用,但自回归缓存状态在每次执行访问间必须独立[9]。第 1 遍进入第 4 层时的输入隐藏态与第 2 遍再进第 4 层时截然不同,全注意力 KV Cache 与线性注意力循环状态一旦写进同一块缓存,前后两遍推理就会互相覆盖[9]。而vLLM的 PagedAttention 默认按层索引一对一分配分页页表,动态 Python 循环直接复用物理层号会导致页表碰撞。寒武纪vllm_mlu将执行计划静态展开为 56 个逻辑槽位,既让 vLLM 调度器正常管理 56 份独立 KV 与循环状态页表,又在底层将循环槽位权重指针指回同一份 32 层内存,在不改动核心调度器的前提下兼顾分页缓存与低权重占用[1][9]。
对于只有 10 GB 到 16 GB 显存中端加速卡、却需要跑起接近 27B 级文档分析与工具调用能力的私有化团队,SenseNova Loop-9B 与 vllm_mlu 提供了可立刻上卡验证的开源路线;但如果业务卡在低延迟高并发交互,或依赖严苛的多约束工具精度,正式切换前仍须按真实并发度跑通端到端延迟压测,算清省下的 HBM 是否值得多出的 24 步计算时间[1][3]。
说明:本文由 AppBus 基于商汤 GitHub 开源仓库、Hugging Face 模型实现源码、寒武纪适配公开通报及学术论文交叉核对整理,供技术研究与架构选型参考,不构成任何采购或投资建议。
参考资料
[1] 寒武纪 Day 0 完成商汤 SenseNova Loop-9B 适配,打通新型循环计算架构推理链路 | IT之家(2026-11-18):https://www.ithome.com/1/028/568.htm
[2] 商汤发布 SenseNova Loop-9B 模型:部署显存需求低至 10 GB 内 | IT之家(2026-11-17):https://www.ithome.com/1/028/534.htm
[3] OpenSenseNova/SenseNova-Loop 中文说明文档(`README_CN.md`) | GitHub(2026-11-17):https://raw.githubusercontent.com/OpenSenseNova/SenseNova-Loop/main/README_CN.md
[4] sensenova/SenseNova-Loop-9B Model Page | Hugging Face(2026-11-17):https://huggingface.co/sensenova/SenseNova-Loop-9B
[5] SenseNova-Loop-9B-Preview `config.json` | Hugging Face:https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview/raw/main/config.json
[6] OpenSenseNova/SenseNova-Loop `README.md` | GitHub(2026-11-17):https://raw.githubusercontent.com/OpenSenseNova/SenseNova-Loop/main/README.md
[7] vllm-project/vllm PR #64832: Add SenseNova Loop support | GitHub:https://github.com/vllm-project/vllm/pull/64832
[8] Cambricon/vllm-mlu `README.md` | GitHub:https://raw.githubusercontent.com/Cambricon/vllm-mlu/v0.11.2-dev/README.md
[9] SenseNova-Loop-9B-Preview `modeling_sensenova_loop.py` | Hugging Face:https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview/raw/main/modeling_sensenova_loop.py
[10] mHC: Manifold-Constrained Hyper-Connections | arXiv:2512.24880v1(DeepSeek-AI):https://arxiv.org/html/2512.24880v1
[11] 商汤开源 SenseNova Loop-9B-Preview:探索以计算深度释放模型潜力 | 商汤官网(2026-10-30):https://www.sensetime.com/cn/news/sensenova-loop-9b-preview-20261117-1750