2026 年 11 月 16 日,SC26 全球超算大会开幕当天,算力芯片赛道同日摆出了一组颇具张力的对照[1][2]。在超算会场,NVIDIA 公布面向科学智能体的新卡 Rubin HPC,将单卡 CUDA 核心推高至超过 50,000 个[1];同日,AMD 携手美国能源部橡树岭国家实验室(ORNL)与 HPE 宣布新超算 Lux 正式向科研人员开放,并披露旗下芯片已进入第 68 届 TOP500 榜单超过 40% 的系统[3][2]。而在华尔街与半导体研究圈,摩根大通与 SemiAnalysis 的两份测算同日刷屏——前者估算前沿大模型实验室未来采购结构中 NVIDIA GPU 份额或仅 39%[4][5],后者则把 2030 年全球 AI 加速器资本开支预测砍掉 40%[6]。
把会场的新卡发布和市场上的机构预测放在同一张桌子上看,芯片竞争的坐标悄然改写:科学超算与商用大模型,正按两本不同的账本挑选硬件[5][7][8]。
SC26 超算交锋:Rubin HPC 预告新卡,AMD 靠 Lux 守稳科学底座
NVIDIA 在 SC26 端出的 Rubin HPC 隶属 Vera Rubin 平台,预计 2028 年上市供货。按官方博客披露,这颗 GPU 集成超过 50,000 个 CUDA 核心,配齐第 7 代 NVLink 互联与稀疏数据加速机制,专门解决科学仿真中频繁离散取数拖慢算术核心的问题[1]。
NVIDIA 将发力点押在智能体驱动的科研仿真上:当 AI 智能体在气候建模、工程仿真、基因组学和金融风险分析中探索候选方案时,往往要高频执行稀疏矩阵、模板运算与归约排序,再借助 CUDA-X 算法库缩短从提出假说到实验验证的周期。译自官方英文原文,NVIDIA 超大规模与高性能计算副总裁伊恩·巴克(Ian Buck)指出:“对于投身科学与工程领域的智能体而言,更快的仿真意味着更快的发现。”他称 Rubin HPC 将加速智能体测试构想、指引后续探索的仿真流程[1]。此前在 2026 年 6 月 ISC 大会上,NVIDIA 已发布整机形态的 Vera Rubin 科学计算平台(由 Vera CPU 协同 Rubin GPU,单机柜至多配 144 颗 GPU,提供超 7 Exaflops AI 科学算力与 5 Petaflops 原生 FP64),已获德国莱布尼茨超算中心 Blue Lion(计划 2027 年上线)、美国 NERSC Doudna 及洛斯阿拉莫斯国家实验室多套系统采用[9]。
NVIDIA 的路线图指向 2027 至 2028 年,AMD 在 SC26 晒出的则是已经通电接单的超算阵地。据 AMD 11 月 16 日披露的榜单统计,其技术共进入 202 套 TOP500 系统,官方口径明确为占榜单 40% 以上、同比增长约 14%,并包揽本期半数新入围系统;全球前十快超算占 4 席,分别是第 2 名 El Capitan(1,809.00 PFlop/s)、第 3 名 Frontier(1,353.00 PFlop/s)、第 6 名 HPC7(571.50 PFlop/s)与第 8 名 HPC6(477.90 PFlop/s);在 Green500 能效榜前 50 中占超半数、前 10 占 4 席[2]。当然,对照 TOP500 官网 2026 年 11 月完整榜单也得划清边界:本期榜首是中国深圳超算中心 LineShine(2,198.40 PFlop/s),第 5 名 JUPITER Booster、第 7 名 Eagle 与第 10 名 Alps 仍搭载 NVIDIA 芯片;并且 TOP500 按双精度 HPL 基准排座次,与商用云端大模型集群是两码事[10]。
同日开放科研接入的 Lux(SI + HPC) 集群,由 HPE 基于 ProLiant Compute XD685 打造,是美国能源部(DOE)“创世纪计划(Genesis Mission)”投入使用的头一座专用 AI 工厂,首秀便排在 TOP500 第 14 位,实测 HPL 220.79 PFlop/s(峰值 Rpeak 323.90 PFlop/s)[3][2][10]。据 ORNL 橡树岭领导计算设施(OLCF)公开规格,Lux 在 500 多个节点内安装超过 4,000 颗 Instinct MI355X GPU(注:全系统单次作业可用卡数因常驻服务节点可能低于 4,000 颗)、总计 1.1 PB 高带宽内存(单卡 288 GB HBM3E、带宽 8 TB/s),配齐 EPYC 9575F 处理器与 Pensando 400G 以太网。每年规划的 350 万个节点小时中,一半用于聚变电站设计、材料基础模型与田纳西河谷水文预报等科研任务,另一半面向政企伙伴付费开放[3][11]。
在后续梯队上,AMD 宣布搭载 MI430X(CDNA 5)与第 6 代 EPYC 的新机已锁定 ORNL 预计 2028 年交付、2029 年运行的 Discovery,以及法国首台百亿亿次超算 Alice Recoque(预计超 1 Exaflop HPL)、德国 Herder 与芬兰 LUMI-AI;软件侧同步开源 AMD HPC Assistant,并联合 IBM 在 Lux 上跑通量子纠错工具 Pelagos,实现 1 至 8 颗 MI355X 吞吐 6.23 倍扩展[2][8]。
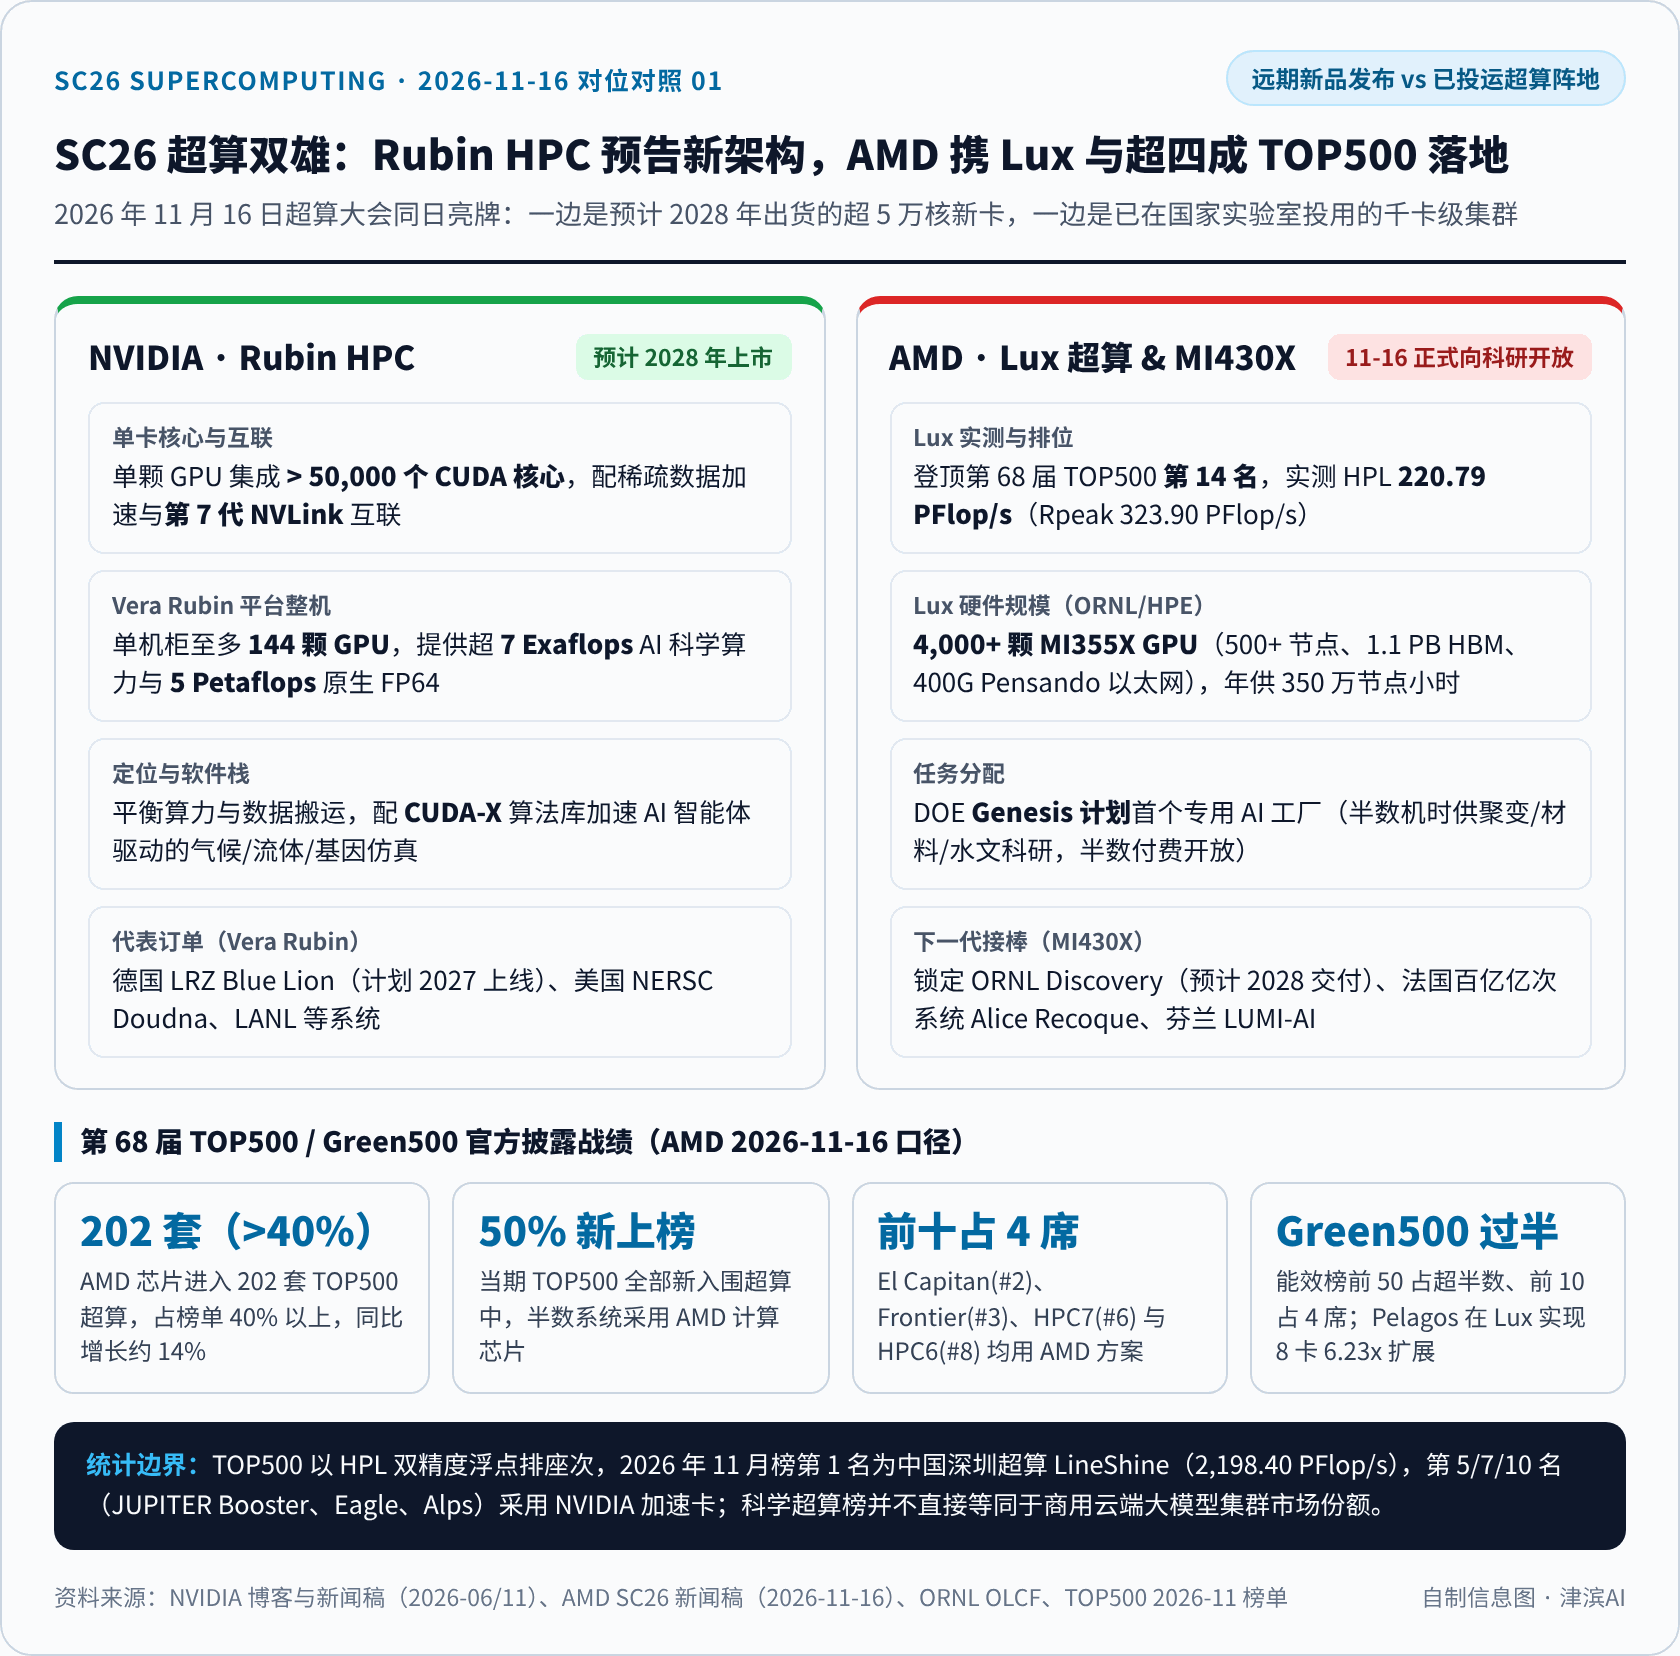
配图说明:Rubin HPC 预计 2028 年供货;TOP500 按 HPL 双精度指标排序,与商用云端大模型集群统计口径不同。
资本市场与产业模型:39% 测算、28% 修订口径与 9230 亿新底线
视角切回商业大模型采购盘,11 月 16 日传播的两份机构研究测算让市场开始重新估算账本[4][5][6]。
先看采购结构的研究测算。据钛媒体 2026 年 11 月 16 日引述摩根大通资管部门市场与投资策略负责人迈克尔·切巴莱斯特(Michael Cembalest)报告《The Icarus Files》报道,在 OpenAI、Anthropic 等前沿实验室未来拟采购的算力基础设施中,NVIDIA GPU 测算占比仅为 39%,博通定制芯片以 24% 排在次席,谷歌 TPU 占 16%,AMD GPU 占 15%,亚马逊 Trainium 占 6%。对照历史数据,2023 至 2025 年 NVIDIA 在全球 AI 芯片总营收中曾占 83%(同期毛利率 75%、营业利润率 66%)[4][5]。报道并提及,OpenAI 于 2025 年 10 月已分别敲定与博通研发 10 GW 定制加速器、向 AMD 采购 6 GW GPU 的计划[4]。
我们进一步调阅摩根大通官网托管的《The Icarus Files》PDF 原件(封面日期 2026 年 11 月 14 日,文档属性显示于美东时间 11 月 16 日早晨修订上传),发现第 4 页核心图表做了口径细化:按“2026 年及以后部署的已公开前沿实验室吉瓦(GW)算力协议”重算并计入 Cerebras(0.75 GW、占 2%)后,在合计 43.86 GW 样本里,NVIDIA GPU 占 28%(12.11 GW),博通定制 23%(10 GW),AMD GPU 18%(8 GW),亚马逊 Trainium 16%(7 GW),谷歌 TPU 14%(6 GW)。两处研究边界必须挑明:报告尾注声明该文系切巴莱斯特个人市场观点,不代表摩根大通卖方研究;且无论 39% 还是 28%,统计的都是已公开远期吉瓦协议样本,并非当下即期出货市占率,但大客户正在用多源下单分散议价权[4][5]。
另一份预测修正来自 SemiAnalysis。据 36 氪转述财联社消息,该芯片研究机构在模型更新中调低了未来数年 AI 加速器资本开支、出货、HBM 与电力需求预期:2028 年全球 AI 加速器资本开支预期下调 28%,2029 年下调 41%,2030 年下调 40%——2030 年单年预测由原先的 1.531 万亿美元收窄至 9230 亿美元(少算 6080 亿美元);2026 至 2030 年五年逻辑晶圆出货总面积预计也收窄 17%[6]。不过,即便经历这轮研究模型下修,2030 年单年预测体量仍接近万亿美元,更像是把早年“不计功耗融资抢卡”的过陡外推曲线拉回常态轨道[5][6]。
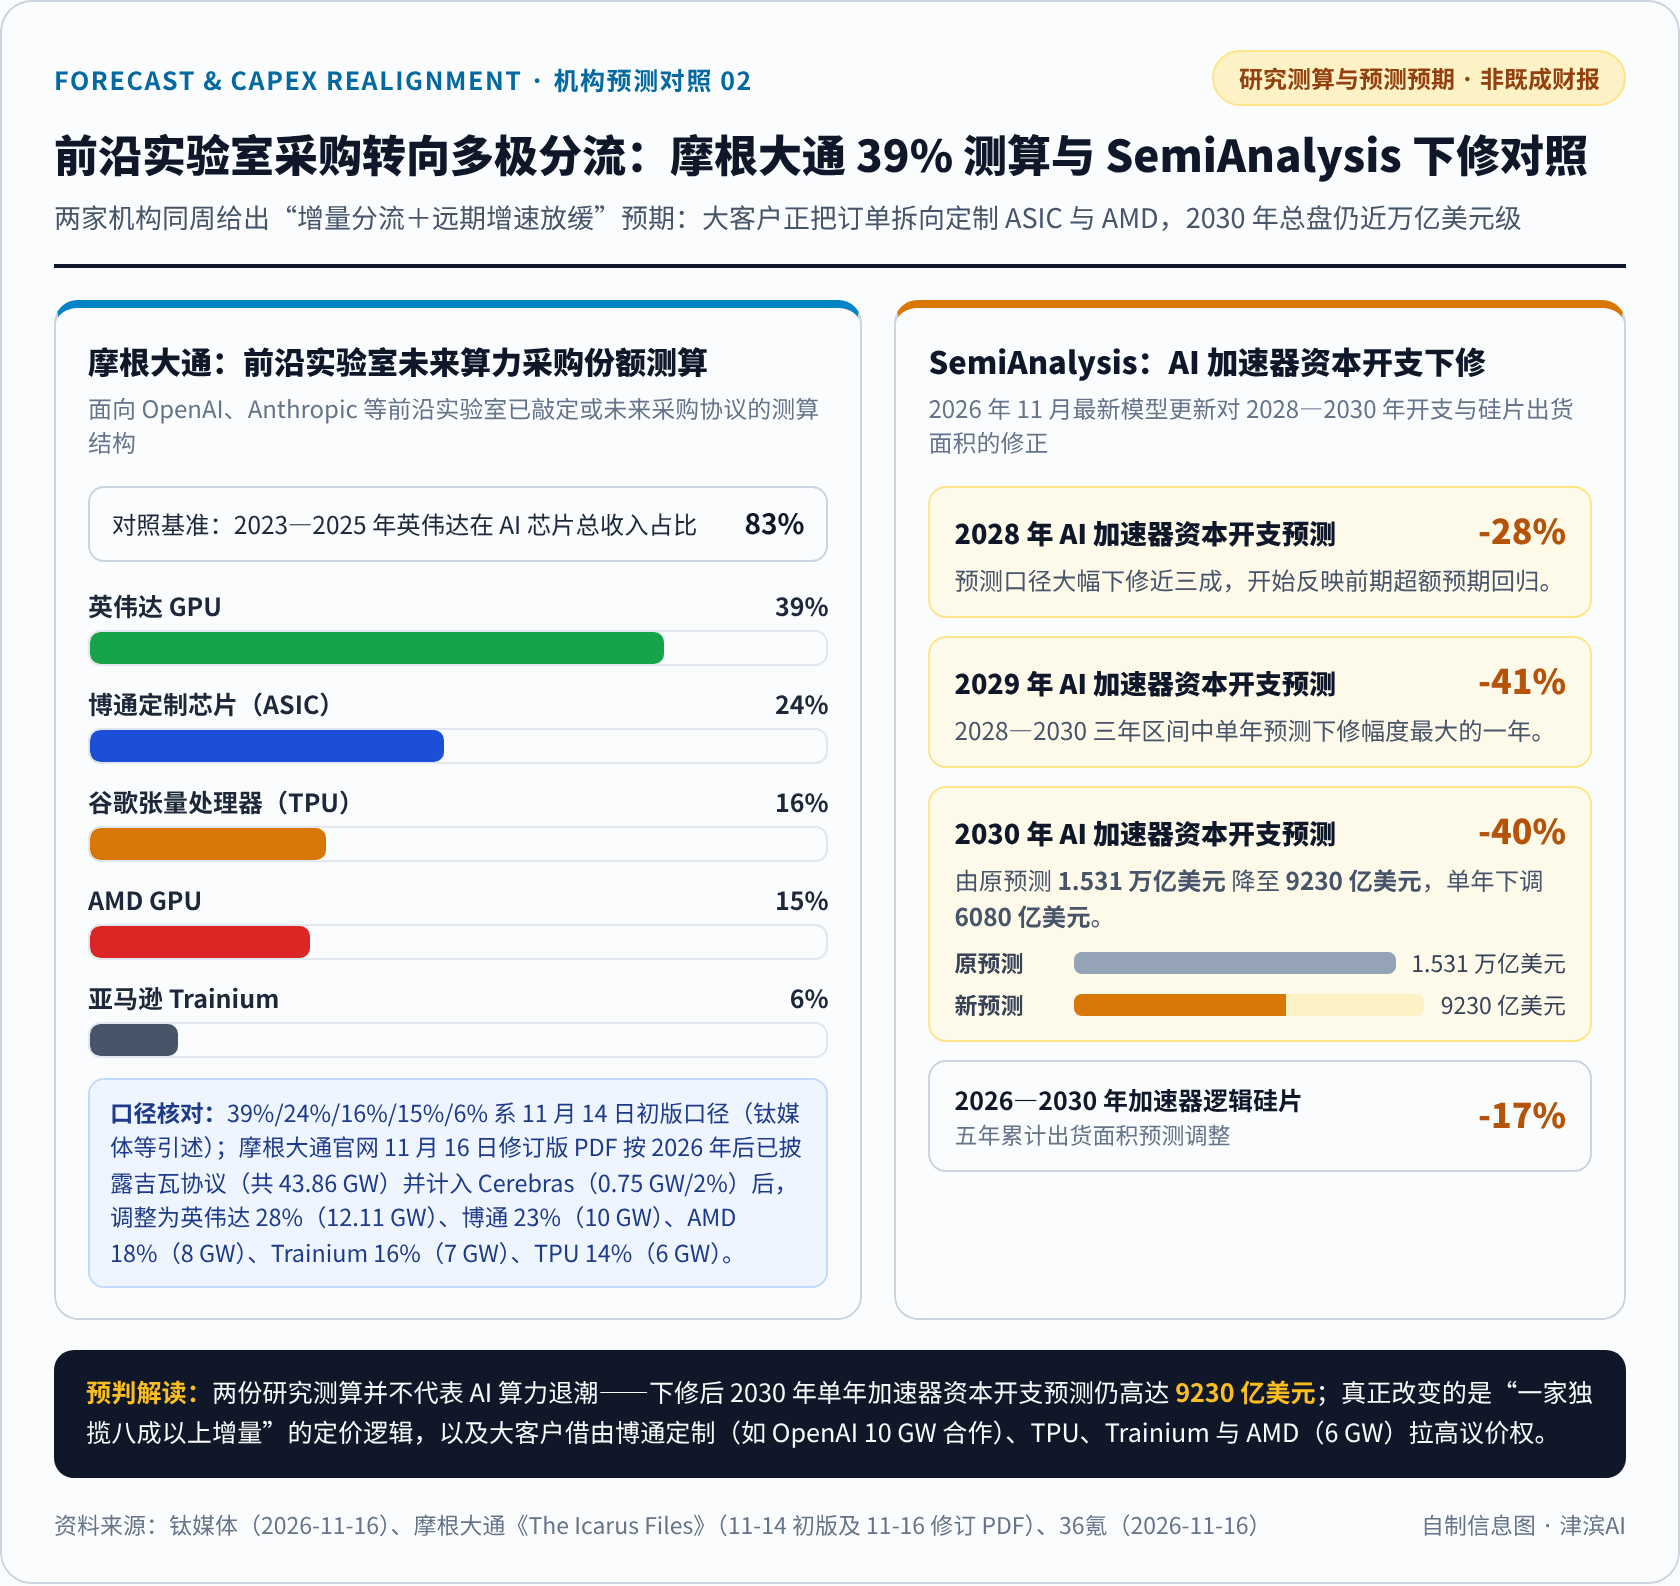
配图说明:左图柱状条按 2026-11-14 初版口径绘制并附 11-16 PDF 按吉瓦修订明细;右图全部数据均为研究机构预测模型下修值,非既成财报。
知识延伸:为什么科学超算死磕 FP64,AI 大厂却抢着做 FP8/FP4 与定制 ASIC?
同样叫算力芯片,为什么国家级超算中心偏爱原生 FP64 通用 GPU,而云巨头与大模型实验室却纷纷压低比特位数、甚至下场自研 ASIC?拆开微架构,关键在于“精度税”和“通用税”两笔硬账[7][8][12]。
- 一笔是“精度税”:科学仿真为什么难以全靠低精度软件模拟? 气候、流体与分子动力学动辄连续迭代千万步,一旦用低位宽格式近似,微小的舍入误差会随步数滚雪球式放大。AMD 在 MI430X 技术文章里补充了一层 AI 时代的新担忧:下一代科学 AI 代理模型要靠高保真仿真生成训练数据,底层仿真若发生数值失真,AI 模型也会把错误规律一并学进去[7]。基于 CDNA 5 架构的 MI430X 由此预期配备高达 288 TFLOPS 原生 FP64(5 月初报口径为超 200 TFLOPS、预期超下代 NVIDIA Rubin 6 倍以上)与 432 GB HBM4(带宽 23.3 TB/s、容量比 Vera Rubin 多 50%),并兼配 9.2 PFLOPS 峰值 FP4。面对业内“能否砍掉原生 FP64、用 Ozaki 算法在低精度核上软件模拟”的争论,AMD 在 SC26 论文中基于 MI350X/MI355X 实测 11 个科学应用、47 种配置后给出数据:模拟法仅适合稠密大矩阵乘法(GEMM),而整个 HPC 生态里不到 10% 的负载呈稠密 GEMM 形态——11 类测试中仅 rocHPL 有时可用(且 HPL 官方榜单禁模拟),其余 rocHPCG、流体网格、高阶有限元、蒙特卡洛与分子动力学 LAMMPS 等 10 类仍依赖原生 FP64 矢量算力与显存带宽;此外软件模拟的显存占用可达原生 FP64 的约 3 倍[8]。相比之下,商用大模型训练与推理对低精度容忍度高,用 FP8 或 FP4 可成倍拉高密度——例如 Lux 在 4,000 多颗 MI355X 上便同时提供 317 PFLOPS FP64、20 EFLOPS FP8 训练与 40 EFLOPS FP4 推理算力[11]。
- 另一笔是“通用税”:通用 GPU 为什么难在单位功耗上赢过脉动阵列 ASIC? 对照 Google Cloud《TPU 架构》文档可见结构差异:常规通用 GPU 单片集成 2,500 至 5,000 个算术逻辑单元(Rubin HPC 更推高至超 50,000 个 CUDA 核心),之所以能调度复杂分支、图形与各类新算子,全靠完备的控制逻辑与内存层次[1];但每跑一次运算都得往返寄存器或共享内存取数、写回中间值,面积和能耗被控制与访存开销分走一块。而谷歌 TPU、亚马逊 Trainium 与博通代工定制 XPU 等 ASIC 砍掉通用控制负担,把海量乘加器硬连成 脉动阵列(Systolic Array)(如 TPU v6e 与 TPU7x 的 256×256 矩阵乘法单元 MXU,早期为 128×128);矩阵计算时中间和直接沿相邻单元接力传递,大幅省去内存往返,把硅片功耗预算换成更高每瓦 Token 吞吐[12]。摩根大通报告显示,全球七大算力买家(五大云巨头加两大前沿实验室)中仅 SpaceX 未推进自研芯片[5]。代价则是通用边界:一旦模型出现脱离规整矩阵乘的动态稀疏算子,ASIC 的编译器与生态弹性远不如通用 GPU[12]。
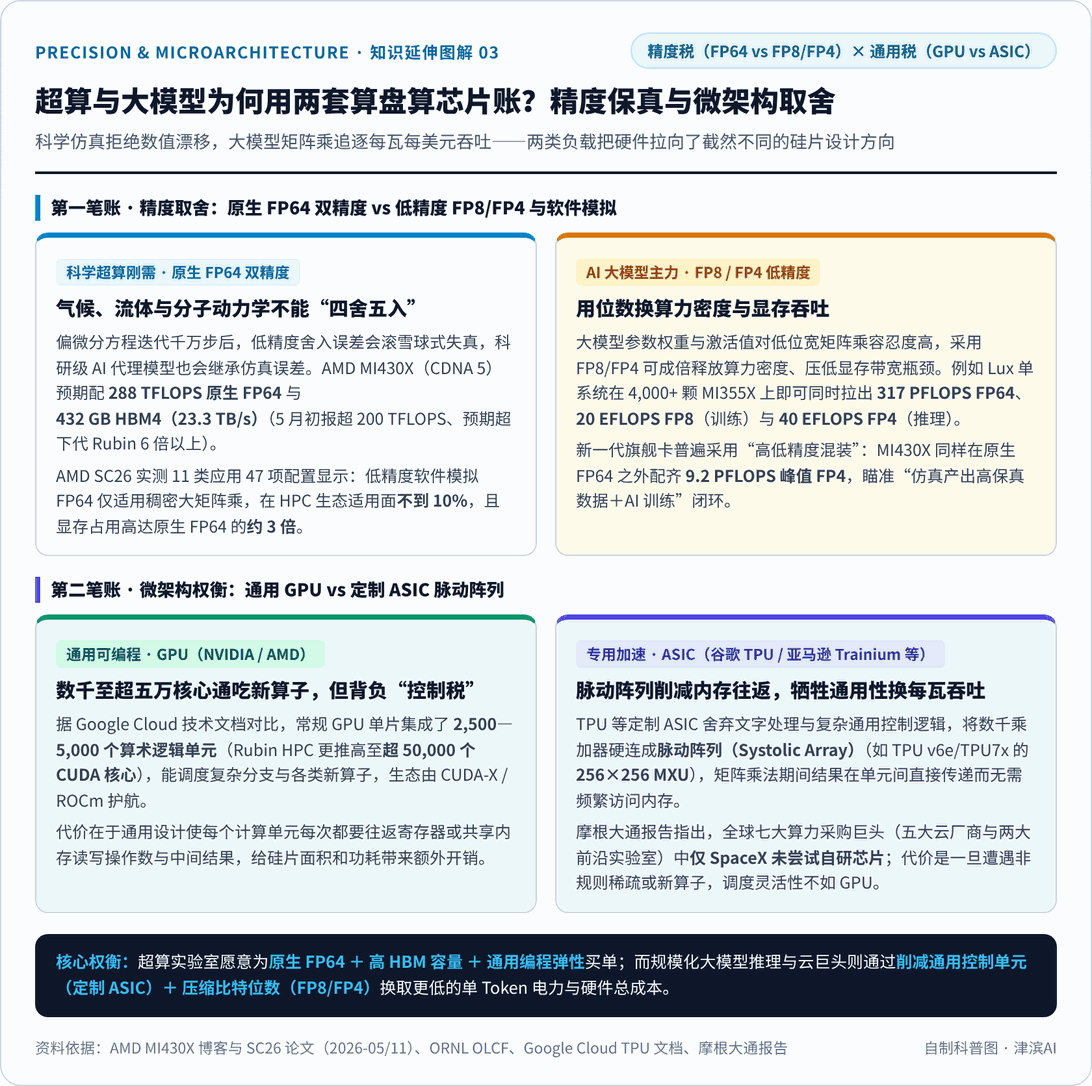
在我看来,SC26 超算发布与同日刷屏的两份研究测算合起来读,恰恰照出了 2027 年后算力底座的分化方向:算力基建并没有退潮,而是从“一张通用 GPU 通吃全部需求”切分成两条采购链[3][5][6]。需要高保真仿真、多物理场与稀疏新算子的科研和重度探索,仍会为大 HBM、原生 FP64 与机柜强互联埋单[1][8];而成熟大模型推理与云巨头日常负载,则会加速用 FP8/FP4 配合定制 ASIC 脉动阵列及高性价比 GPU 分摊预算[4][5][12]。NVIDIA 凭第 7 代 NVLink 与 CUDA-X 生态短期依然握牢核心训练盘,但接下来比拼的已不只是单卡峰值,而是吉瓦级电力与单 Token 综合拥有成本[1][5][6]。
说明:本文由津滨AI借助 AI 辅助检索与起草,并经人工逐条核对公开政务文件、官方公告、司法文书及权威媒体信源审校;文首题图为 AI 概念生成示意(非实拍),其余 3 张信息图均依据公开披露数据自制渲染,供产业观察与科普阅读参考,不代表任何政府部门、科研机构或企业官方立场。
参考资料
[1] NVIDIA Announces Rubin HPC | NVIDIA Blog(2026-11-16):https://blogs.nvidia.com/blog/rubin-hpc/
[2] AMD Expands Frontier of Scientific Computing at SC26 | AMD Newsroom(2026-11-16):https://newsroom.amd.com/news/sc26-amd-expands-frontier-scientific-computing/
[3] AMD-Powered Lux Supercomputer Opens to Scientific Users at Oak Ridge | AMD Newsroom(2026-11-16):https://newsroom.amd.com/news/amd-powered-lux-supercomputer-opens-scientific-users/
[4] 摩根大通:前沿AI算力采购中英伟达GPU占比测算 | 钛媒体(2026-11-16):https://www.tmtpost.com/nictation/8206833.html
[5] Eye on the Market: The Icarus Files (PDF) | J.P. Morgan Asset Management(2026-11-14初版 / 11-16更新):https://cdn.jpmorganfunds.com/content/dam/jpm-am-aem/global/en/insights/eye-on-the-market/the-icarus-files-amv.pdf
[6] SemiAnalysis下修AI算力资本开支预测 | 36氪 / 财联社(2026-11-16):https://www.36kr.com/newsflashes/4072371411293057
[7] AMD sets new bar for HPC with AMD Instinct MI430X GPU FP64 performance | AMD Blog(2026-05-06):https://www.amd.com/en/blogs/2026/amd-sets-new-bar-for-hpc-with-amd-instinct-mi430x-gpu.html
[8] Exascale Was the Beginning: AMD Instinct MI430X GPUs | AMD Blog(2026-11-12):https://www.amd.com/en/blogs/2026/exascale-was-the-beginning-amd-instinct--mi430x-gpus.html
[9] NVIDIA Vera Rubin Delivers World-Class Supercomputers for Science | NVIDIA Newsroom(2026-06-22):https://nvidianews.nvidia.com/news/nvidia-vera-rubin-delivers-world-class-supercomputers-for-science
[10] TOP500 List - November 2026 | TOP500.org(2026-11):https://top500.org/lists/top500/list/2026/11/
[11] Lux System Specifications | Oak Ridge Leadership Computing Facility (OLCF):https://www.olcf.ornl.gov/olcf-resources/compute-systems/lux
[12] TPU architecture | Google Cloud Documentation(2026-01-14更新):https://docs.cloud.google.com/tpu/docs/system-architecture-tpu-vm