2026 年 11 月 15 日,阿里巴巴千问团队先发出英文技术博客推出旗舰基座模型 Qwen4-Max,11 月 16 日向中文市场正式开放 API 与办公、编程应用入口;其骨干总参数达到 2.4T(即 2.4 万亿),但每个词元只激活 71B 参数(比上代减少 25%),外加 328B 的 N-gram 词表嵌入参数,原生支持视觉理解与 100 万(1M)词元上下文窗口[1][2]。
几乎踩着同一个周末节点,上海人工智能实验室没有召开发布会,直接在 Hugging Face 与项目官网上线了科学多模态模型书生 Sage S2.1-Flash[3][4]。与前者的闭源商用路线不同,书生 S2.1-Flash 依据 MIT 协议开放 BF16 与 FP8 双套权重,仓库 safetensors 精确统计总参数约为 321B(321,323,031,390 参数,部署指南记为 320B-A18B 混合专家架构),同样将上下文窗口推至 1M(1,048,576 词元)[5][6][7]。通用闲聊跑分正在退居次席,国产头部模型正同步向商业成本账与科研工具闭环两头突围。
双轨分化:商用长程“算总账”,开源科研“接闭环”
Qwen4-Max 盯紧的是长周期智能体账单。代理系统接进真实办公与研发流水线后,多轮工具调用会把单次任务的词元吞吐量推到数十万级别,企业首先要算清整单调用费;阿里千问此次重点砍低了重复前缀的缓存读取价格[1][2][8]。
从阿里云百炼中国站公开计费表来看,在百万词元以内区间,Qwen4-Max 的标准输入与输出定价分别降至每百万词元 10 元和 30 元(上代 Qwen3.8-Max 为 12 元与 36 元),显式和隐式上下文缓存命中的单价下探到 0.5 元/百万词元[8];海外站点 QwenCloud 同步给出了输入 1.5 美元、输出 4.5 美元、缓存读取 0.075 美元的对应费率[9]。产品端还加入 Live Delivery 分阶段持续交付模式(配套插件 Qwen-Live-Delivery-Plugin 已放到 GitHub 开源),让智能体先出可用初版再听用户中途纠偏;不过截至目前,2.4T 旗舰本体仍仅以闭源 API 形态提供,官方仅披露系列中的中小尺寸模型计划后续陆续开源[1][2]。
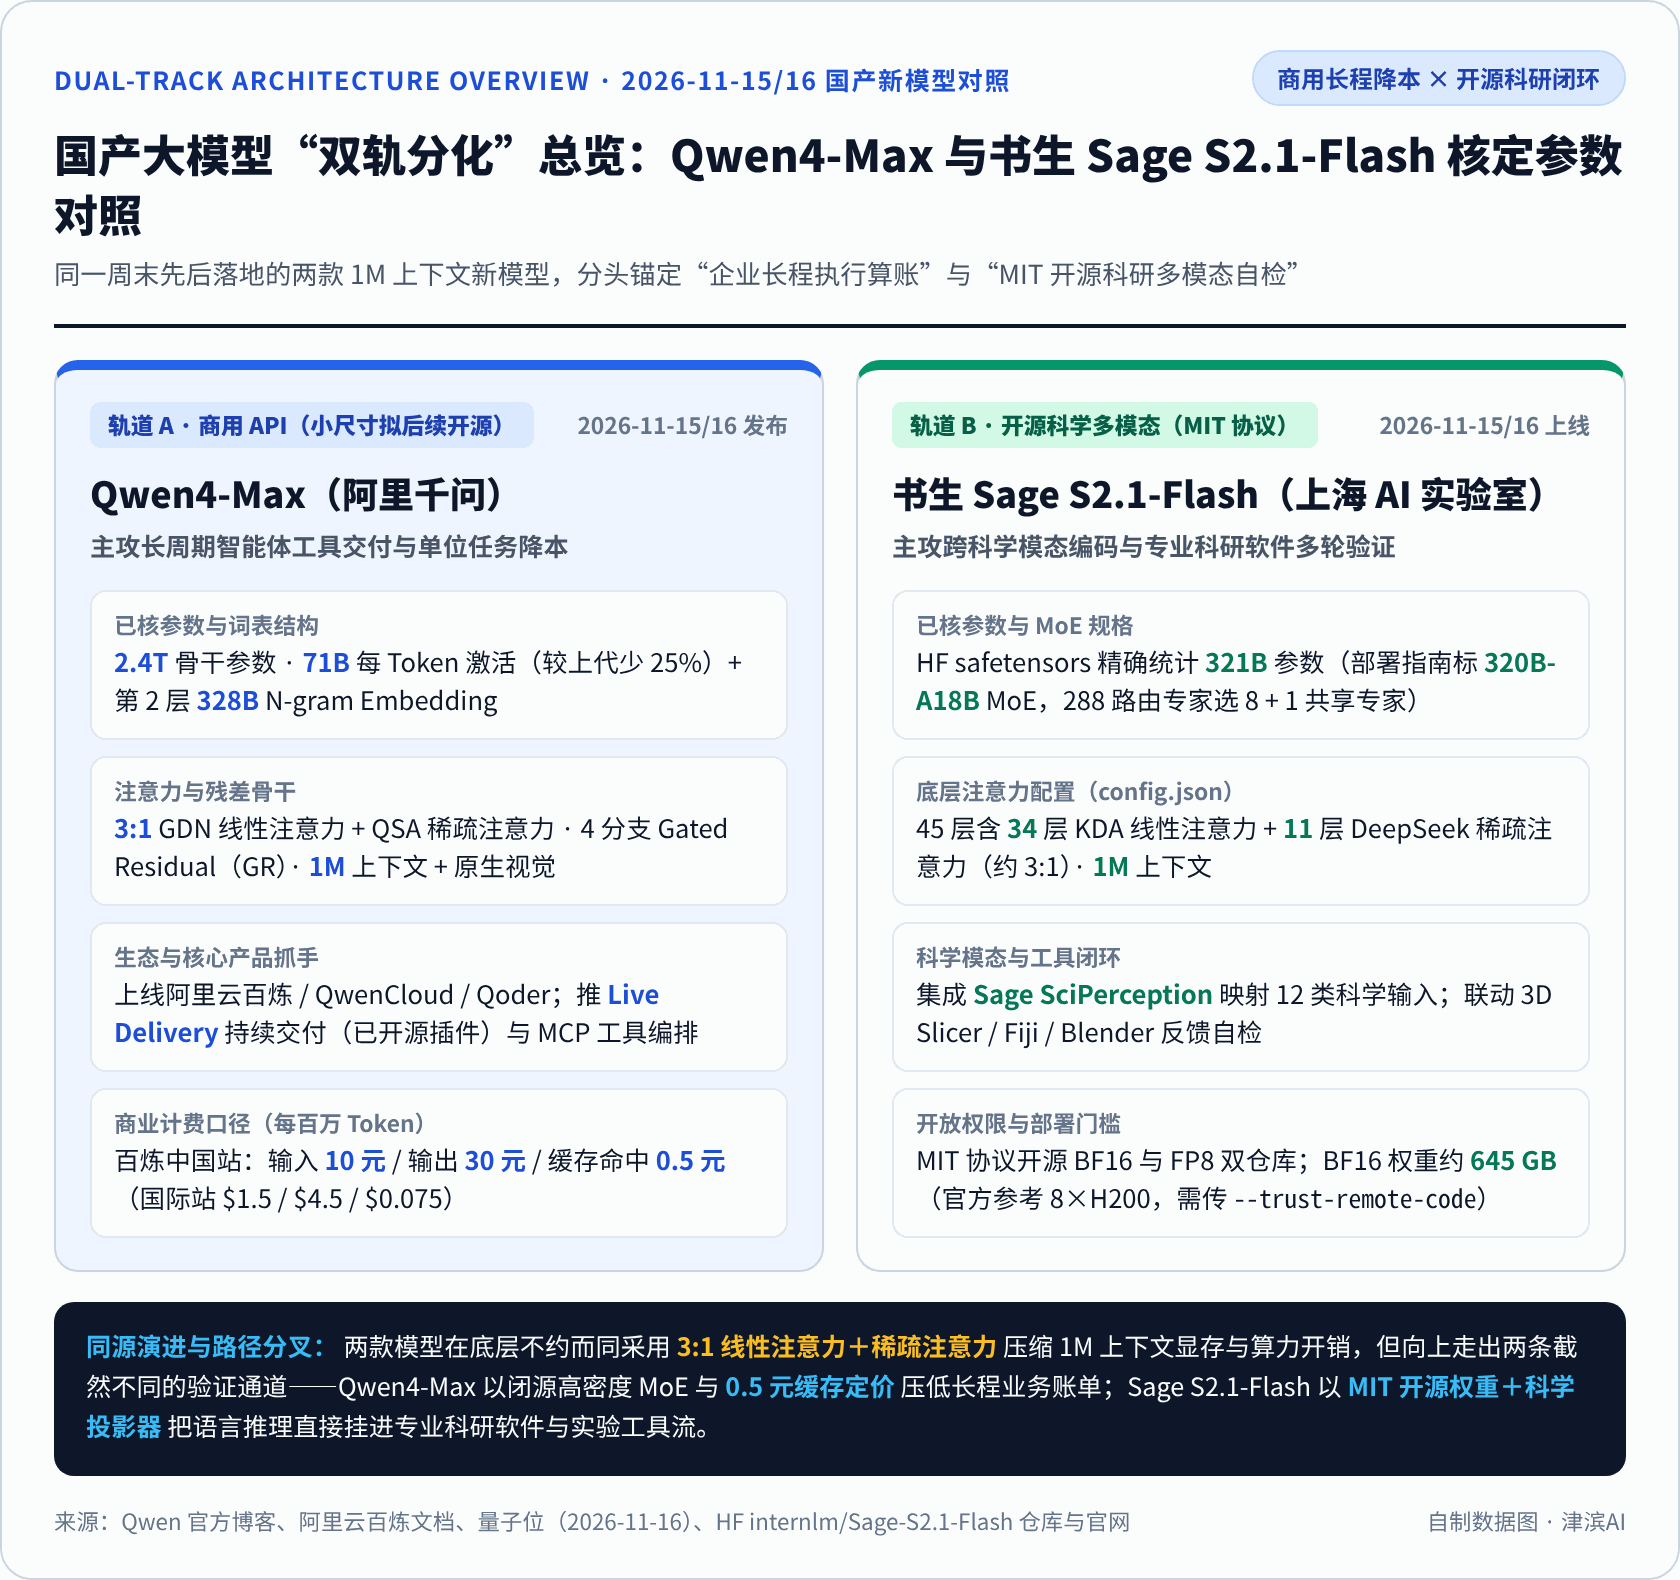
配图说明:图 1 仅收录已在 Qwen 博客、阿里云计费文档及 Hugging Face 仓库配置文件中核实的架构、参数与定价字段。
书生 Sage S2.1-Flash 则把全部筹码压进了科研开源纵深[3][4]。它没有搭消费级聊天外壳,而是用 MIT 协议开放权重与工具接口,专攻“检索文献—写代码计算—对照软件视觉反馈再修正”的多轮科学工作流[3][6]。
从项目官网公开的演示案例看,模型能直接驱动多款实验室专业软件完成校验闭环:在 12,487 张来源混杂、朝向乱序的 CT 切片里挑出同次扫描的 139 张有效图,复原层序后送进 3D Slicer 重建三维骨骼;在生物软件 Fiji 中调节荧光显微分割阈值并叠回原图复查细胞核轮廓;还能提取 Pr³⁺:Y₂SiO₅ 晶体量子存储研究文献的方程参数,生成可交互校验网页[4]。但宽松的开源协议并不代表轻量部署:仓库指南写明 BF16 权重分拆为 120 个文件、体积约 645 GB(仓库实占约 642.85 GB),vLLM 与 SGLang 参考配置均以 8 张 H200 GPU 起步(另有 FP8 仓库缓释显存压力),各大推理引擎都要加传 --trust-remote-code 参数,跑 vLLM 并行多工具返图还得先打仓库附带的 vllm_patch 补丁[5][6]。
实测对照与短板:62% 降本与 90.3 分之外还有哪些账
把官方博客图表与 Hugging Face 的 README 评测表逐行拆开核对,能看清两款模型的测试集和基线模型彼此独立,而且谁也没有拿出一边倒的成绩单。
先核对 Qwen4-Max 的官方披露口径。 为了度量复杂职业与工业任务,千问团队自建了涵盖 26 个一级领域、182 个二级子类与 721 个细分专业方向的 Work360 框架;据 Qwen 官方博客披露,Qwen4-Max 在该基准的总分从上代 Qwen3.8-Max 的 47.74 升至 52.69,Xhigh 和 High 思考档词元消耗分别下降约 24% 与 35%,叠加上文缓存大幅降价,单任务平均费用从 4.43 美元降至 1.67 美元,降幅达 62%[1]。在第三方终端编程基准 Terminal-Bench 4.0(同为 Xhigh 档)上,Qwen 官方博客及阿里供稿量子位均披露:单次尝试平均用量从 289K 词元降至 151K(博客口径减约 48%,High 档减约 49%),得分从 38.9 升至 48.5,单任务均费减少 58%[1][2]。
官方长图与供稿展示的强项还包括:Agents' Last Exam v1.1 升至 46.7(较上代 27.9 上涨 18.8 分),法律基准 HLAB-Vals-1.1 达 21.3(涨 5.9 分),DeepSWE v1.1 达 75.7,生物信息基准 BioMysteryBench 达 85.0,前端盲测 CodeArena(Elo 1750)居全球第 6[1][2]。应用实例上,官方披露在 SANF 与 Pacific Union 汽车产线将单件加工编程人工耗时由约 475 分钟缩至 24 分钟(降约 95%);金融投研编排 90 个 MCP 工具产出带双层超链溯源的报表;IPO 尽调整理 198 份混乱底稿并交出 86 页逾 6 万字报告;阿里云自优化调度闭环使数据标注多模型路由降本 10.42%、离线 CPU 求解提速超 14.61 倍;科研方向则联手深度原理 Mira 干湿闭环 48 小时从 270 万分子筛选并经 4 轮迭代合成新型冷却液样品,并在深势科技 PharmMaster 针对阿尔兹海默症靶点 NLRP3 调用 454 次工具、完成 3239 项计算评估并优化 24 个候选分子,RBFE 估算名义亲和力较起始分子提升约 3.6 倍(合作专家认为具有进一步湿实验验证价值)[1][2]。
不过同一张官方长图同样亮出了落差:在 Terminal-Bench 4.0 上,Qwen4-Max 的 48.5 分明显低于 Kimi K3.1(67.2)与 Opus5.5(59.6);在软件复现 ProgramBench(31.5 vs Opus5.5 的 65.0)、真实代理 AgentArena 净提升(7.5 vs 18.2)以及专业图表理解 Chartography(54.2 vs GPT6-Astra 的 71.1)上也仍有可比差距[1]。另外需要注意,Work360 属千问团队自建框架,冷却液样品与产线工时折减同样来自官方披露,外部第三方长期复测仍有必要[1]。
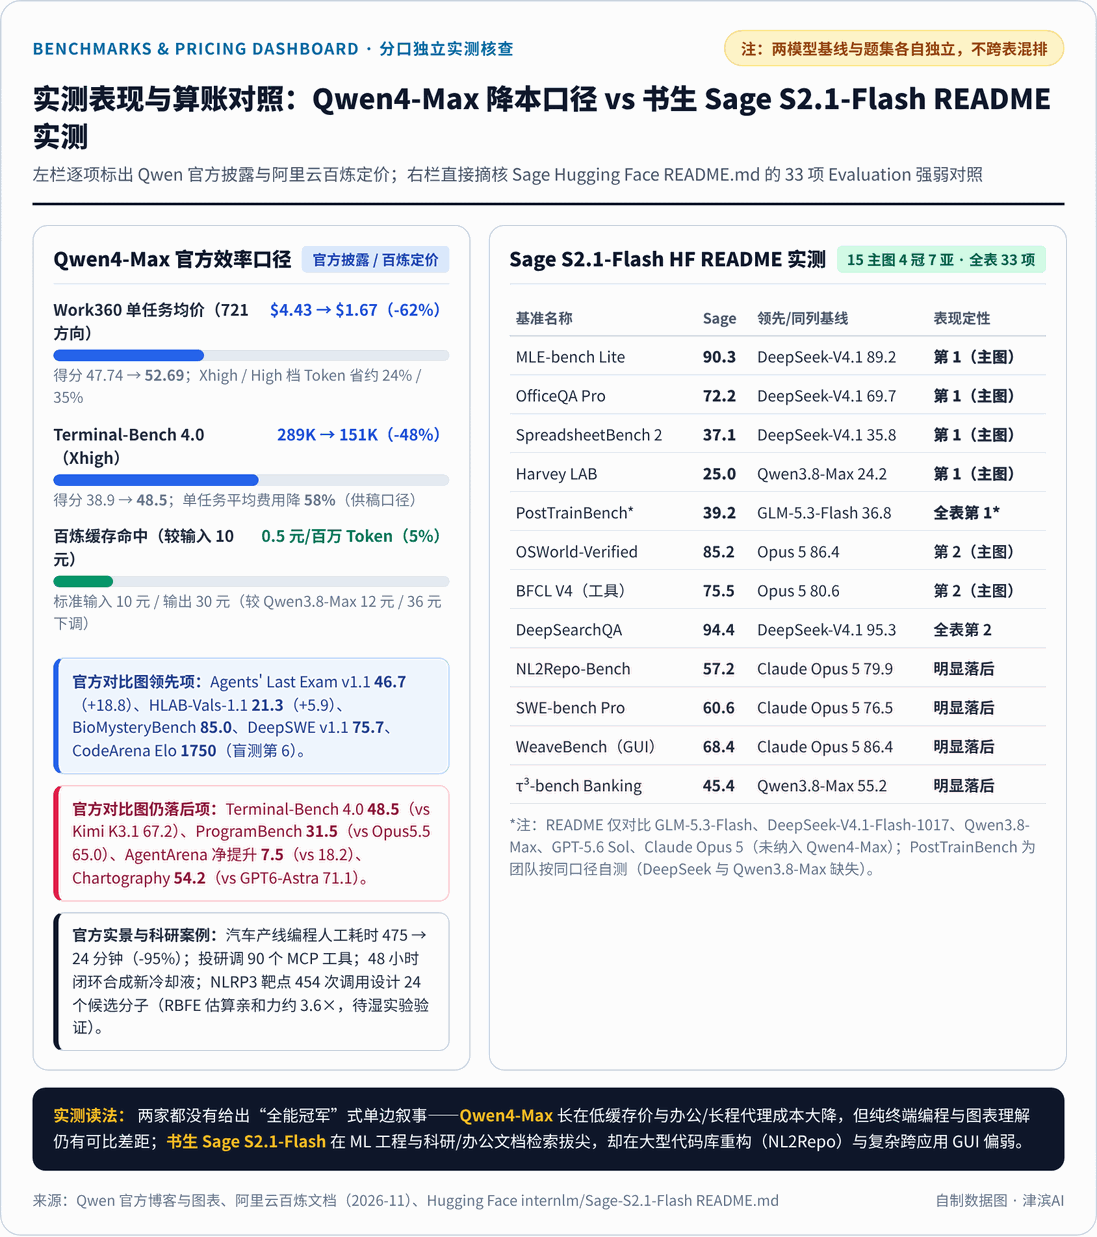
配图说明:图 2 严格分开呈现两套互不交叉的评测集合;Sage README 基线仅对比至 Qwen3.8-Max,未将刚发布的 Qwen4-Max 纳入同表。
再核对书生 Sage S2.1-Flash 的 Hugging Face README.md 实测表。 仓库公开了涵盖 7 大类共 33 项基准、对照 5 款基线(GLM-5.3-Flash、DeepSeek-V4.1-Flash-1017、Qwen3.8-Max、GPT-5.6 Sol、Claude Opus 5)的测试成绩,在主图选取的 15 项基准中取得 4 项榜首与 7 项次席(README 专门注明该名次仅适用所选基准与 6 款模型集合)[3][10]。
它的锋芒集中在机器学习工程与专业文档处理:MLE-bench Lite 拿到 90.3 分居首,压过 DeepSeek-V4.1-Flash-1017(89.2)与 Claude Opus 5(88.0);办公文档基准 OfficeQA Pro(72.2)、Harvey LAB(25.0)与 SpreadsheetBench 2(37.1)同样位居首位;全表中的 PostTrainBench 自测均值 39.2 居首(官网注明为团队同口径自测且 DeepSeek 与 Qwen3.8-Max 缺失数据);DeepSearchQA(94.4)、BrowseComp(91.2)、OSWorld-Verified(85.2)、BFCL V4(75.5)亦站稳第二梯队前端[3][4]。但转到工程仓库与复杂桌面操作,失分同样直白:在 NL2Repo-Bench(57.2 vs Claude Opus 5 的 79.9)、SWE-bench Pro(60.6 vs 76.5)、跨应用 GUI 操作 WeaveBench(68.4 vs 86.4)以及银行客服工具 τ³-bench Banking(45.4 vs Qwen3.8-Max 的 55.2)上仍有明显差距[3]。
知识延伸:3:1 混合注意力如何压掉“算力税”?AI 做科研为何要离开纯文本词元
一闭一开两款 1M 上下文新模型在产品形态上南辕北辙,翻开 Qwen 官方架构图与书生仓库里的 config.json 配置文件,却能看到双方在底层落入了同一套混合骨架[1][7]。
- 第一项机制:用“3 层线性状态 + 1 层稀疏注意力”消减百万上下文算力税。 传统 Transformer 每生成新词,都要用 Softmax 全注意力(Softmax(QKᵀ/√d_k)V)把当前查询与前面全部词元做两两乘积,算力开销随序列长度平方 O(L²) 攀升,KV Cache 显存也按
batch_size × n_tokens × n_heads × d_head × 2 × bytes随长度线性膨胀[11][12]。InfiniteVL 论文(arXiv:2512.08829v1)实测显示,传统视觉语言模型在流式视频处理中帧数一到第 294 帧就发生显存溢出,吞吐从大约 10 FPS 跌破 1 FPS[11]。早期的纯线性注意力虽将复杂度降为线性 O(Ld²)、靠固定矩阵 S_t 存历史,但简单累加外积容易低秩混叠,导致 OCR 与精细文档丢细节[11][12]。于是 Gated DeltaNet(GDN)引入遗忘门 α_t 与类 Householder 旋转项 (I − β_t k_t k_tᵀ) 刷写循环记忆 S_t = S_{t-1}·α_t(I − β_t k_t k_tᵀ) + β_t v_t k_tᵀ,把推理记忆显存锁死在与长度无关的固定常量(batch_size × n_heads × d_head × d_head × bytes)[11][12]。正如 Sebastian Raschka 在技术笔记中分析的,只要经固定矩阵压缩就难免损失全局精确回忆,因此架构师普遍采取 3:1 混合比——InfiniteVL 用该配比在单卡跑出超 3.6 倍延迟提速与 24 FPS 恒定显存吞吐[11][12]。两款新模型正是这套思路的延伸:Qwen4-Max 以 3 层 GDN 配 1 层微块索引的 QSA 稀疏注意力,并在第 2 层加挂 328B N-gram 查表与 4 分支 Gated Residual 稳训[1];书生 S2.1-Flash 的config.json同样在 45 层中排出 34 层 KDA(GDN 的通道级门控变体)交替 11 层 DeepSeek 稀疏注意力(约 3:1),配 288 个路由专家(每次激活 8 个加 1 个共享专家)撑住 1M 上下文[7][12]。
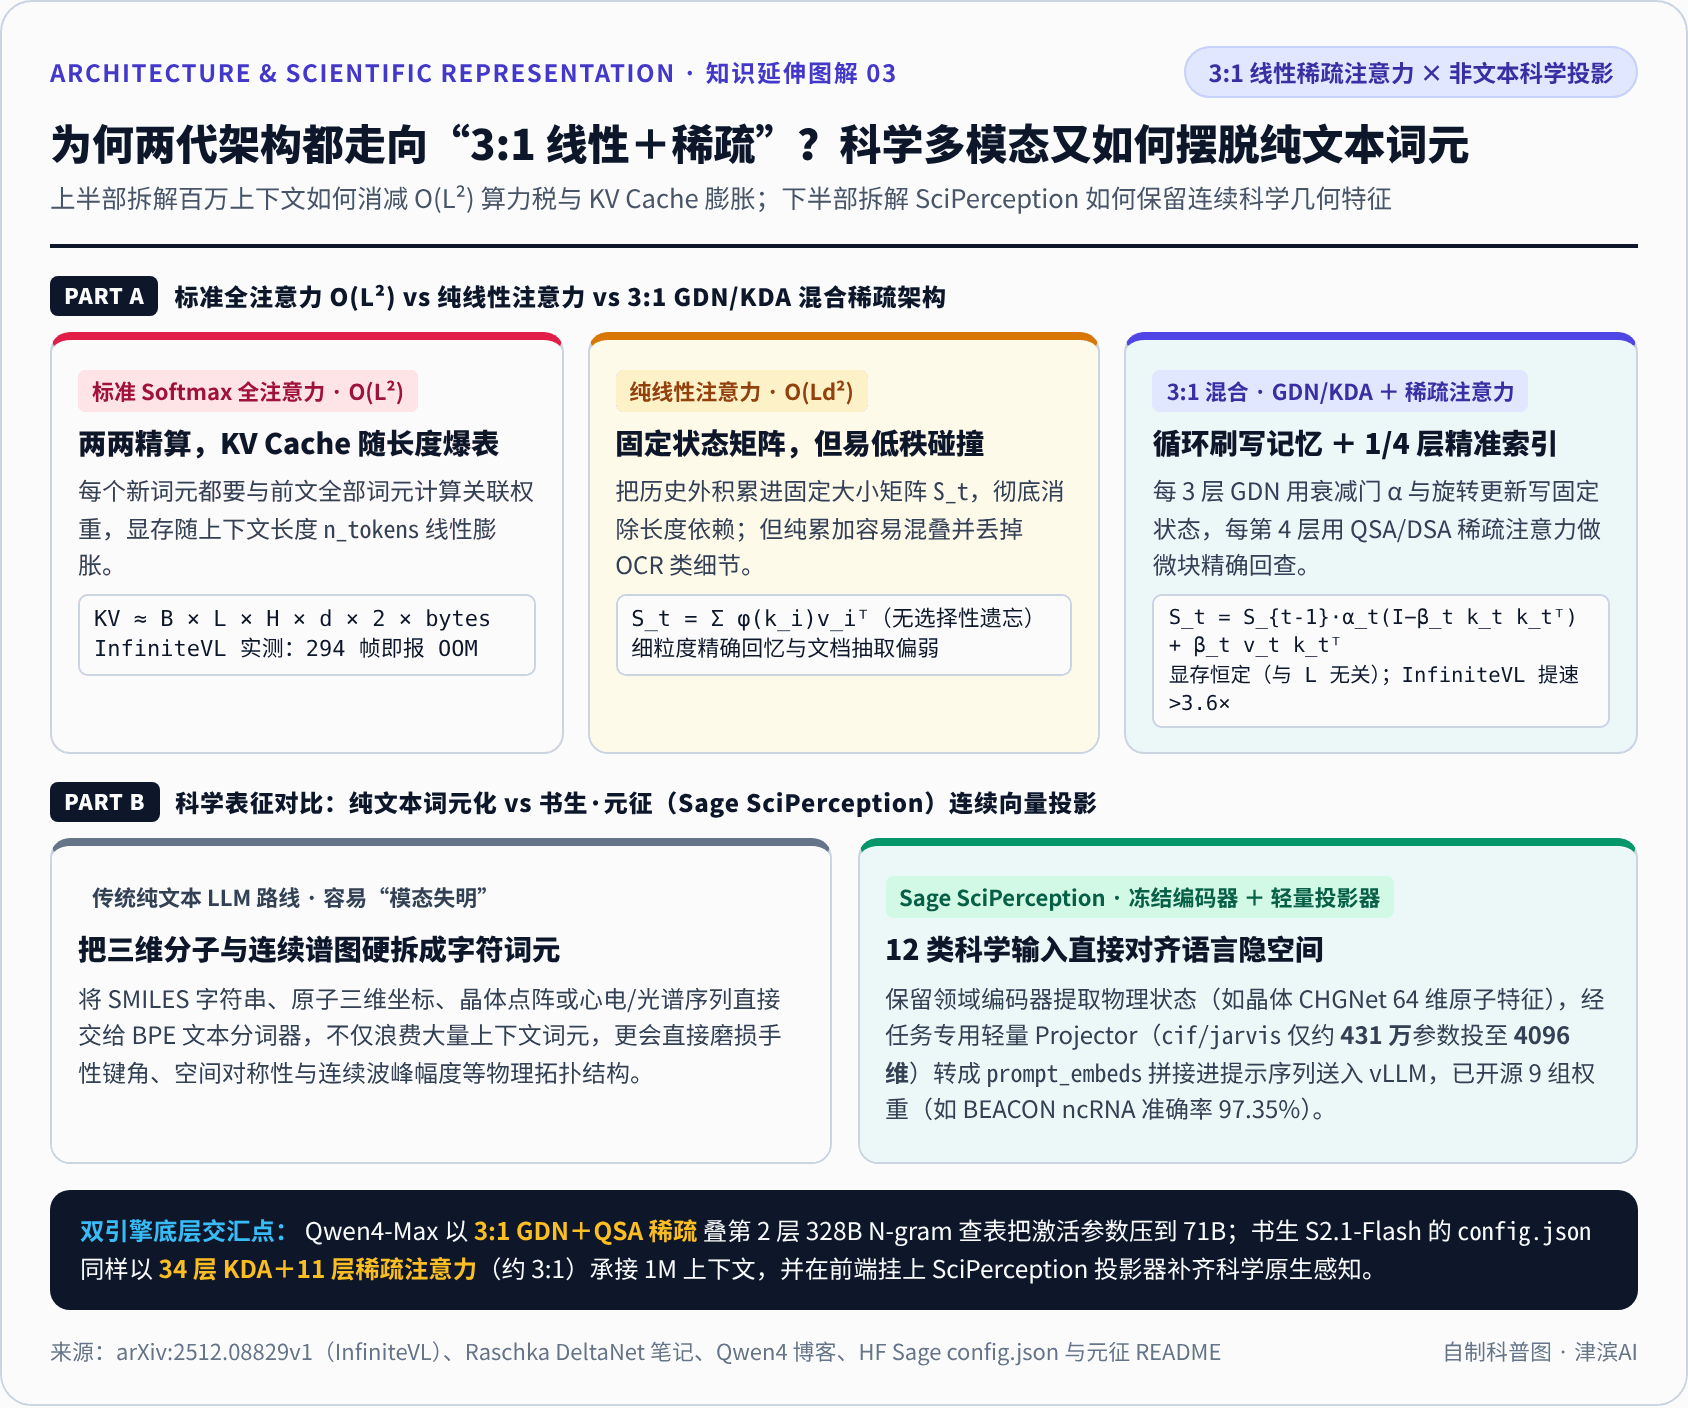
- 第二项机制:科学多模态为何要离开纯文本词元。 通用语言模型碰到化学分子或晶体任务时,通常只能把 SMILES 字符串、晶体坐标或波形表压成纯文本词元,极易丢失三维键角、手性拓扑、晶体对称性与连续波峰幅度等物理信息[13]。书生 S2.1-Flash 接入的书生·元征(Sage SciPerception)冻结领域科学编码器与语言底座,将分子、晶体、蛋白序列与折叠三维构象、核酸链段、多种光谱、串联质谱、X 射线衍射、心电、脑电及光变曲线等十余类输入(架构图具体列出 12 类)先交给科学编码器提取物理状态(如晶体任务提取 CHGNet 0.3.0 的
[num_atoms, 64]原子特征),再经轻量可训练投影器(如cif/jarvis仅 4,314,304 参数、输出 4096 维匹配隐层)直接映射成prompt_embeds拼接送入 vLLM 联合推理[6][10][13]。目前随模已释出 9 组科研投影器权重,元征主库代表指标含 JARVIS-DFT 形成能 MAD/MAE 15.03、BEACON ncRNA 准确率 97.35%、GUE 剪接位点 MCC 87.87%、QM9S 三谱识别 Acc@1 49.75%;但作者也注明前端科学编码器权重与预处理脚手架需另行配置,DNA、MPBind、ncRNA 任务适配科学模型尚未打包放出[10][13]。
把两款同期新模型放在同一张选型桌上对照,国产大模型退出单纯拼闲聊分数的消耗战已成方向,各家正分别补齐“长程智能体的商用算账能力”与“科学软件闭环的开源原生深度”;但两条路径现阶段都各有待跨之坎——Qwen4-Max 的自建 Work360 泛化性与合成样品落地效果仍待独立第三方长期检验,而书生 Sage S2.1-Flash 645 GB 的全精度体积也决定了它短期内更贴近具备多卡集群的科研院所与云服务方,而非普通课题组的单机桌面[1][5][6]。
说明:本文由津滨AI借助 AI 辅助检索与起草,并经人工逐条核对公开政务文件、官方公告、司法文书及权威媒体信源审校;文首题图为 AI 概念生成示意(非实拍),其余 3 张信息图均依据公开披露数据自制渲染,供产业观察与科普阅读参考,不代表任何政府部门、科研机构或企业官方立场。
参考资料
[1] Qwen4-Max: Your New Teammate Has Arrived | Qwen Official Blog(2026-11-15):https://qwen.ai/blog?id=qwen4-max
[2] 阿里正式发布Qwen4,智能体及编程能力进阶,迈向真实全场景 | 量子位(2026-11-16):https://www.qbitai.com/2026/11/510486.html
[3] internlm/Sage-S2.1-Flash README.md | Hugging Face(2026-11-16):https://huggingface.co/internlm/Sage-S2.1-Flash/raw/main/README.md
[4] 书生 S2.1 Flash 官方网站(案例演示与完整评测设定) | Shanghai AI Laboratory:https://internlm.github.io/Sage-S2.1-Flash/
[5] internlm/Sage-S2.1-Flash Model Page | Hugging Face:https://huggingface.co/internlm/Sage-S2.1-Flash
[6] Sage-S2.1-Flash Deployment Guide (`deployment_guide.md`) | Hugging Face:https://huggingface.co/internlm/Sage-S2.1-Flash/raw/main/deployment_guide.md
[7] Sage-S2.1-Flash Model Configuration (`config.json`) | Hugging Face:https://huggingface.co/internlm/Sage-S2.1-Flash/raw/main/config.json
[8] 模型列表与计费说明(qwen4-max / qwen3.8-max) | 阿里云百炼文档:https://help.aliyun.com/zh/model-studio/model-pricing
[9] Qwen4-Max Model Pricing & Rate Limits | QwenCloud:https://www.qwencloud.com/models/qwen4-max
[10] internlm/Sage-S2.1-Flash 中文说明(`README_CN.md`) | Hugging Face:https://huggingface.co/internlm/Sage-S2.1-Flash/raw/main/README_CN.md
[11] InfiniteVL: Synergizing Linear and Sparse Attention for Highly-Efficient, Unlimited-Input Vision-Language Models | arXiv:2512.08829v1:https://arxiv.org/html/2512.08829v1
[12] Gated DeltaNet for Linear Attention (`LLMs-from-scratch/ch04/08_deltanet/README.md`) | Sebastian Raschka / GitHub:https://github.com/rasbt/LLMs-from-scratch/blob/main/ch04/08_deltanet/README.md
[13] 书生·元征(Sage-SciPerception)中文文档(`README_zh.md`) | Hugging Face:https://huggingface.co/internlm/Sage-SciPerception/raw/main/README_zh.md