熬了大半年通宵敲出来的毕业论文,连半个标点都没让大模型碰过,交进平台一测,屏幕上却赫然跳出刺眼的红字——AI 疑似率直奔 90%。点开报告详情页更让人气笑:连作者自己的真实姓名、基金项目编号、古籍里的经典中药方剂,甚至实验室亲手测出来的表格数据与访谈记录,全被算法画上了“疑似机器生成”的红线(《天津今晚报》,2026 年 11 月 22 日)。
为了把那串悬在毕业答辩头顶的红字压下去,无数学生被迫干起了最荒诞的苦力活:把原本通顺严谨的学术句子硬生生拆得七零八落,故意塞进别扭的口水话,每改一版再乖乖扫码掏几十上百块检测费。这到底是帮高校抓代写造假,还是逼着老实人花钱买罪受?
越工整越挨板子,AIGC查重仪到底在瞎猜什么?
想看透这出闹剧,先得把“传统文字查重”和“AIGC 检测”这两件完全两码事的工具拆开看。
传统论文查重干的是“拿尺子比原句”的实在活:数据库里躺着几千万篇已发表文献,你抄了哪本期刊第几页哪句话,白纸黑字一抓一个准,证据链铁证如山。可 AIGC 检测手里根本没有一份“标准底稿”供它比对。大模型每次生成的字句都不重样,检测仪只能蒙着眼睛算概率,靠两个叫“困惑度(Perplexity)”和“突发性(Burstiness)”的统计指标瞎猜你像不像机器。
这两个听着唬人的词,翻译成大白话就是一场“猜词接龙游戏”。
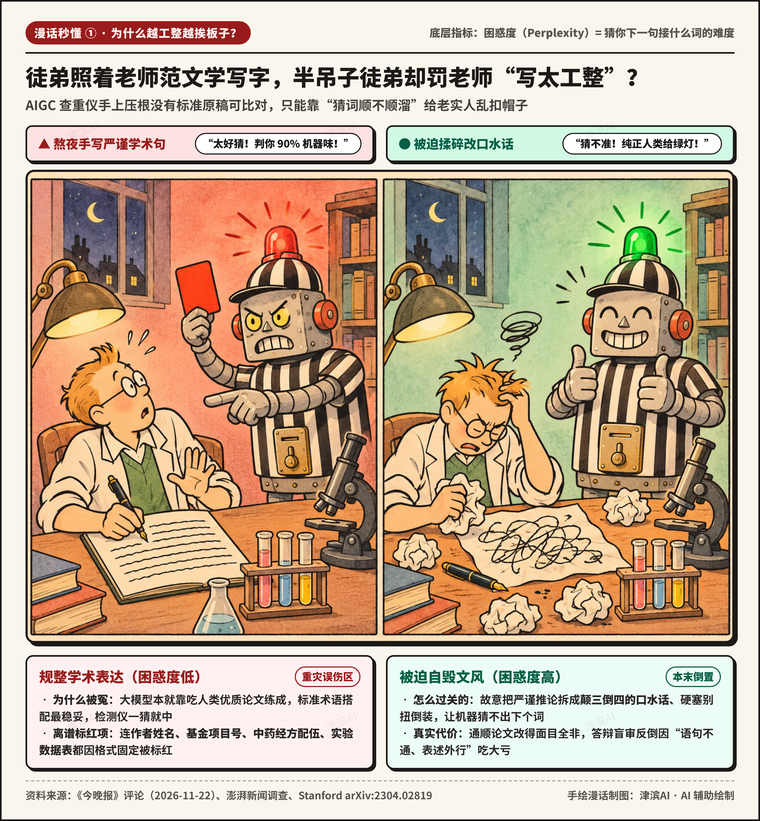
假设你上一句写“实验数据表明”,下一句稳稳当当接上“该催化剂显著提升了反应速率”。因为用词稳妥、完全符合教科书学术规范,检测仪觉得你下一句接什么词“太好猜了(困惑度低)”,当场亮红灯判你“机器味浓重”。反过来,如果你把句子揉碎改成语病连篇、长短乱跳、东一榔头西一棒子的口水话,检测仪猜不准你下一句会蹦出什么词(困惑度高、突发性强),立马竖起大拇指发绿牌夸你是“纯正人类”!
正因如此,《天津今晚报》在 2026 年 11 月 22 日刊发的评论中引述了一个戳穿肺管子的网友比方:徒弟 B 照着人类老师 A 的范文学写字,目标是越写越像 A。等 B 学了个半吊子,平台居然派 B 去抓 A,判定标准竟是“人类 A 绝对不准写得跟 B 一样工整”(《天津今晚报》,2026 年 11 月 22 日)。至于姓名、基金编号和中药经方为什么躺着中枪?因为“国家自然科学基金资助”和“麻黄汤配伍克数”一个字都不能乱改,在猜词机器眼里属于“好猜到极点”的死模板,看见规整格式就不分青红皂白一棍子打死(见下方手绘漫话 ①)。
61.22%纯手写作文被冤枉,斯坦福盲测撕开了哪块遮羞布?
“越守规矩越容易被冤枉”绝非学生的片面吐槽,学术界早就有过硬核盲测铁证。
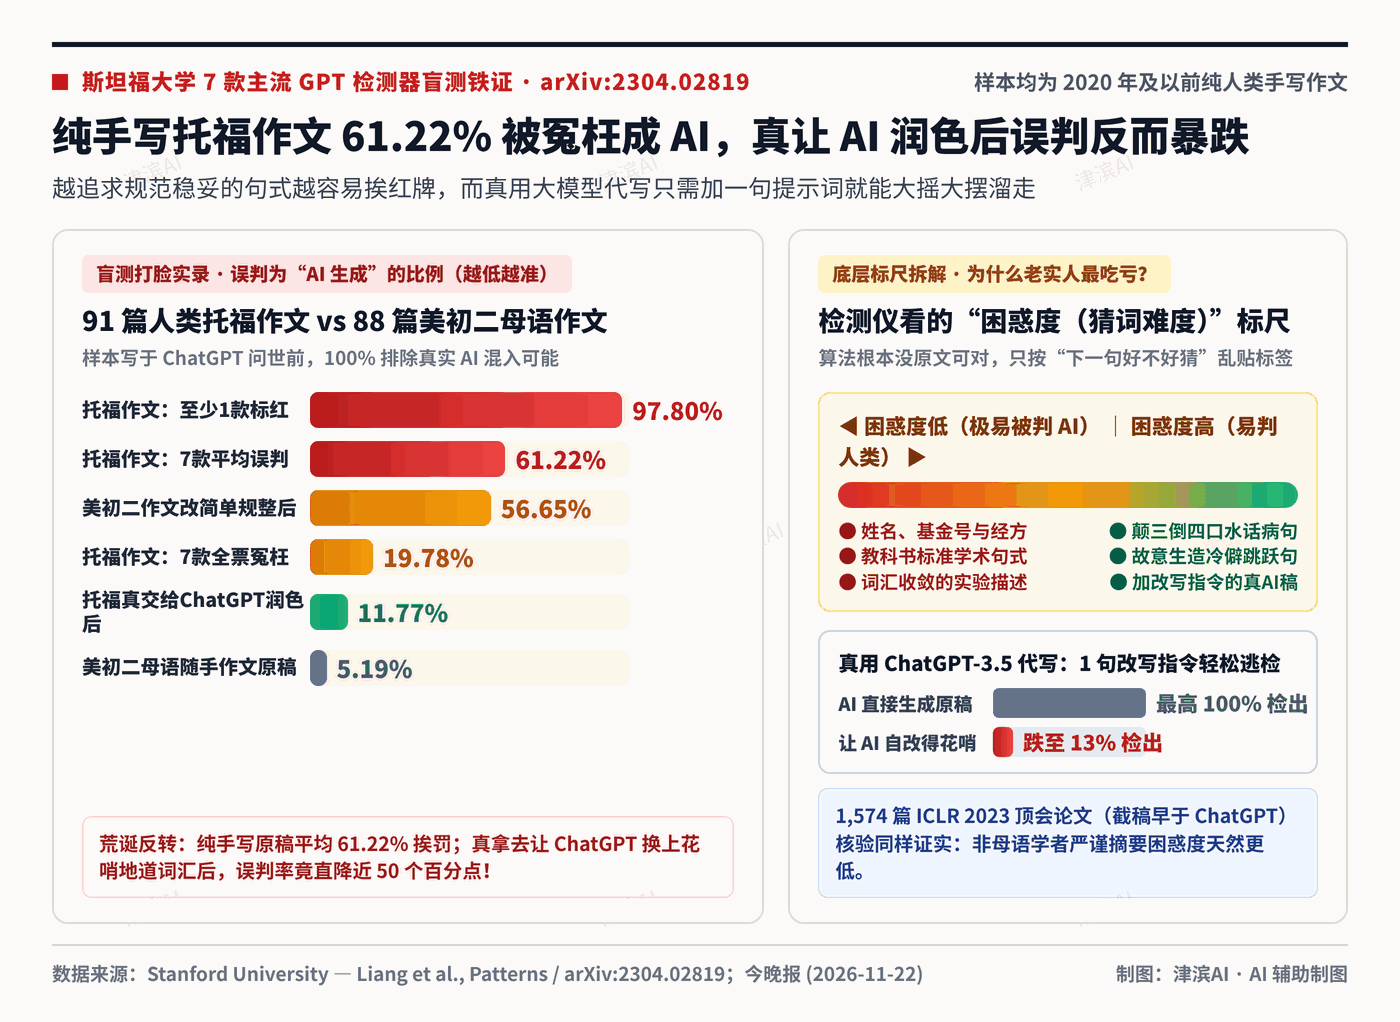
斯坦福大学学者 Weixin Liang、James Zou 等人在发表于 Patterns 期刊的经典论文《GPT 检测器对非英语母语作者存在偏见》(arXiv,2023 年 7 月 10 日修订版)中,专门找来 91 篇写于 2020 年及以前(彼时 ChatGPT 根本尚未问世,100% 纯人类亲笔)的托福考场作文,外加 88 篇美国八年级母语学生的随手作文,送进 7 款主流 GPT 检测器做盲测。
测出来的结果,把一众检测工具的底裤扒得干干净净(详细实测反差见下图):面对美国初二母语学生的随手作文,7 款检测器平均误报率只有 5.19%。可一碰到讲究句式稳妥、词汇收敛的人类托福作文,平均高达 61.22% 的纯手写文章被当场误判成“AI 生成”!更夸张的是,91 篇人类作文里竟有 89 篇(97.80%)至少被一款检测器标红,近两成考生(19.78%)甚至被 7 款检测器“全票一致”冤枉成机器代写。研究团队顺手检验了 1,574 篇截稿早于 ChatGPT 问世的机器学习顶会 ICLR 2023 录用论文,同样证实追求规范表达的非母语学者摘要困惑度天然更低(Stanford arXiv:2304.02819)。
更讽刺的反转还在后头。研究人员真把那批被冤枉的人类托福作文丢给 ChatGPT,只加了一句“把用词润色得像母语者一样花哨地道”,困惑度一升高,平均误判率竟从 61.22% 断崖跌到了 11.77%。甚至拿 ChatGPT-3.5 真正代写的大学申请文书去测,只需让 AI 自己加一句“提升文学性表达”指令,检出率就从最高 100% 暴跌到 13%(Stanford arXiv:2304.02819)。
真用 AI 润色的人大摇大摆过关,老老实实手写标准句的人背锅掏钱。
左手吹哨罚红牌、右手卖药收门票,这笔糊涂账该怎么破?
既然底层算法连“学术规范”和“机器生成”都分不利索,加上国内部分传统文献平台在大模型研发上的投入远不及头部科技企业,为什么这套半生不熟的检测分还能把几十万毕业生折腾得彻夜难眠?
根子出在一门旱涝保收的生意经上。
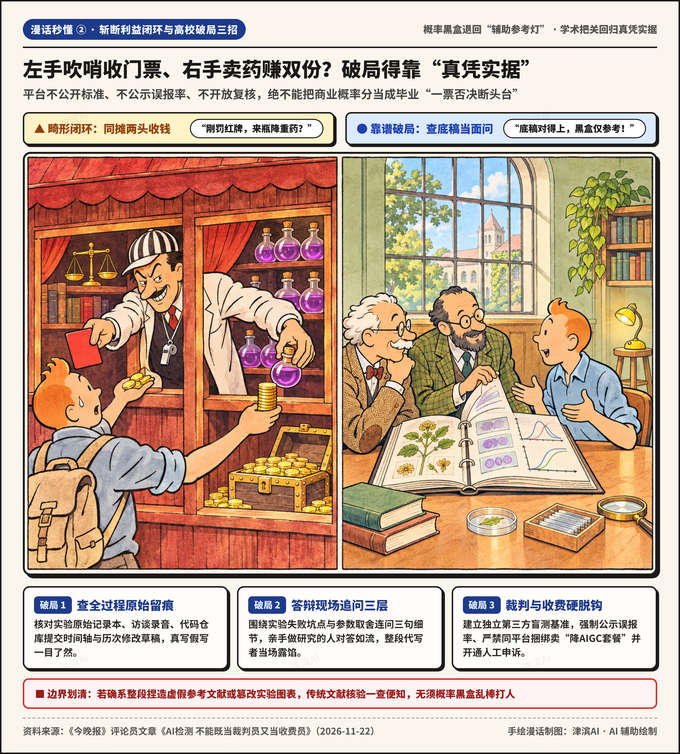
据澎湃新闻调查与《天津今晚报》2026 年 11 月 22 日评论披露,部分主流平台升级算法后,同一篇文稿前后两次送检数值能差出十万八千里。平台一边握着关联毕业答辩、学位授予与学术声誉的“红牌吹哨权”,坚持不公开核心判定标准、不公示官方误报率、不开放人工复核申诉通道。另一边,同一生态又按次数收检测门票,甚至顺手推销昂贵的“付费降 AIGC 套餐”。算法越飘忽、误杀率越高,学生反复改稿复测掏的次数费就越厚,所有试错成本与心理煎熬全由学生买单,平台两边收钱却无需为任何一次误判担责。
要把这笔本末倒置的糊涂账扳回正轨,底线必须一次性划死:任何商业平台的 AIGC 概率分,都绝不能直接当成卡死毕业答辩的“一票否决断头台”,顶多只能算一条提请导师留意的辅助参考灯。 当然,如果学生真的整段照搬大模型生成的文字,甚至连大模型瞎编的“查无此文”假期刊、假引文都原封不动粘进论文,那根本用不着概率黑盒出场,拿常规文献检索库一核对就能当场坐实造假。
真正管用的学术把关,其实就藏在下图右半幅的三件实在事里:第一,查全过程留痕,看开题报告、实验原始记录本、访谈录音与多版初稿修改轨迹。第二,答辩当面追问三层细节,围绕一个实验失败坑点或公式推导追问三句,亲手熬夜写论文的人倒背如流,花钱找代写或无脑粘贴的人三分钟就会露馅。第三,裁判与卖药必须物理切割,行业亟待建立与按次收费脱钩的独立第三方评测标尺,强制公示不同学科基线误报率并开放免费人工复核通道。别再让认真写论文的年轻人,为了迎合一台猜词机器去糟蹋正常的中国话。
知识延伸:毕业生遇到纯手写论文被误标高AI率,怎么留证自保不花冤枉钱?
每年毕业季都有不少同学病急乱投医,花几百块钱去买网上的“一键降 AIGC 神器”。千万别踩这个连环坑:这类黑盒改写工具往往靠同义词乱替和语序硬拆来刷高困惑度,极易把专业法定术语改得驴唇不对马嘴(比如把固定药理名词改成外行生造词),过了机器初筛,到了外审专家眼里反而会因“基本概念常识错误”直接挂掉盲审。
最稳妥的零成本自保办法只有两条:一是从动笔第一天起打开 Word 修订记录、云文档历史版本时间轴或 Git / Overleaf 提交日志,按周保存 v1 到 v10 的演进草稿;二是妥善归档实验原始表格、问卷后台导出包与文献批注笔记。一旦遭遇离谱误标,直接带着完整时间轴草稿与原始实验底稿向导师和学院学位委员会申请人工复核,用扎实的过程铁证说话。
说明:本文由 津滨AI 编辑部借助 AI 辅助检索公开新闻评论与国际同行评议论文并完成初稿整理,经人工逐条核对《天津今晚报》评论原文及斯坦福大学发表于《Patterns》/ arXiv 的盲测实验原始数据后审校定稿;文内概念题图与两幅知识连环画插图由 AI 辅助生成并经人工编排核实(非实拍),统计对比图由 津滨AI 基于公开论文数据自制。本文仅作人工智能技术科普与学术评价机制探讨参考。
参考资料
- 今晚报 / 北方网 (2026-11-22,评论员宋学敏):今晚谈丨AI检测 不能既当裁判员又当收费员
- Weixin Liang, Mert Yuksekgonul, Yining Mao, Eric Wu, James Zou — Stanford University (2023-07-10 v3, Patterns / arXiv:2304.02819):GPT detectors are biased against non-native English writers
